システム内蔵テンプレートの確認
ダウンロード
フォーカスモード
フォントサイズ
システムには76個のルールテンプレートが組み込まれており、そのまま使用できます。使用前に各テンプレートの適用シーンをよくご確認ください。
テンプレートリストの確認
ルールテンプレート管理ページでは、システムテンプレートリストを表示できます。
ユーザーはテンプレート名、説明キーワード、タイプ、ディメンション、適用エンジンに基づいて検索/フィルタリングクエリを実行できます。同時に、ユーザーはカスタムテンプレート画面で作成および一括管理操作を実行できます。
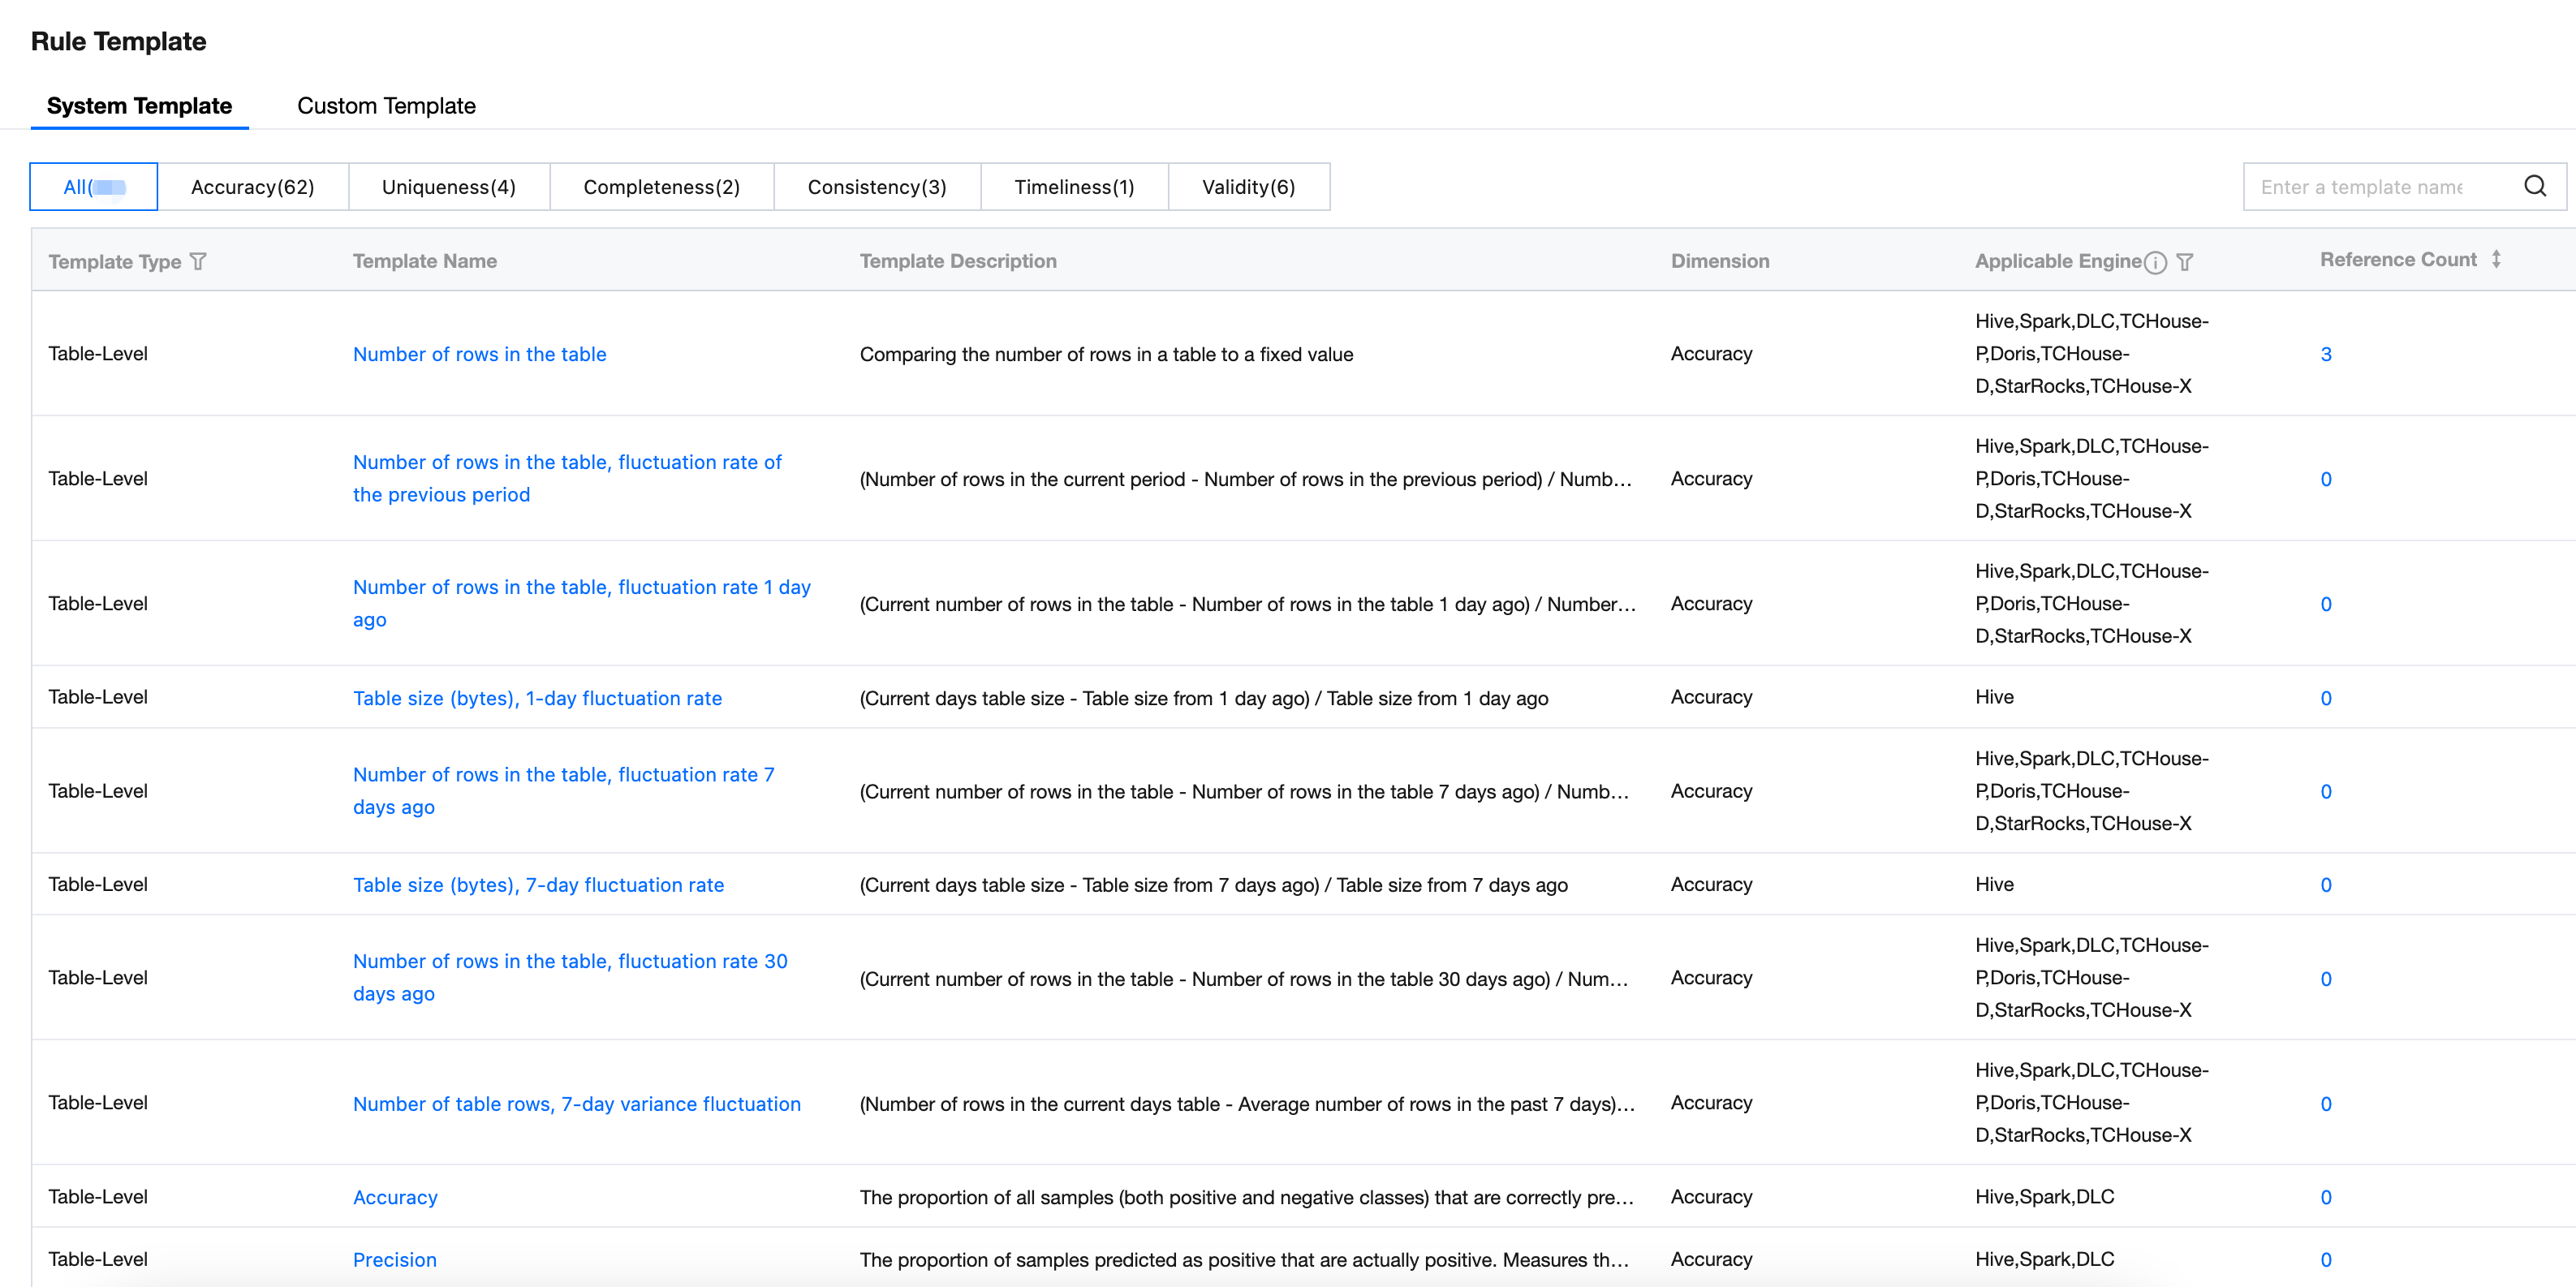
フィールド | 詳細 |
テンプレートタイプ | 現在、テーブルレベル、フィールドレベルの2種類のテンプレートタイプをサポートしており、フィルタリングをサポートしています。 |
テンプレート名 | テンプレートの命名 |
テンプレート説明 | このテンプレートルールの具体的な実行ロジック、計算式の詳細な説明です。 |
ディメンション | 正確性、一意性、完全性、一貫性、即時性、有効性、フィルタリングをサポートします。 |
対応エンジン | このテンプレートに適用されるエンジンタイプ:Hive、Spark、DLC、TCHouse-D、TCHouse-P、TCHouse-X、Doris、StarRocks、エンジンでのフィルタリングをサポートします。 |
引用数 | 現在参照されている関連ルールの数で、並べ替えをサポートしています。 |
テンプレート分布
正確性、一意性、完全性、一貫性、適時性、有効性などの次元から76個のテンプレートを提供します。以下に示します:
標準テーブルテンプレート
監視対象 | ルールディメンション | 計算項目 | 計算サブ項目 | 説明 | 数値型 | 数値-変動率型 | 数値-標準得点型 | その他 | ||||||||
| | | | | 固定値 | 数値範囲 | 前周期 | 1日前 | 7日前 | 30日前 | 7日間 | 30日 | 空/一意/重複 | 形式一致 | 列挙範囲 | 値の大小 |
テーブルレベル | 正確性 | テーブル行数 | | データ行数を計算します。 | ✅ | - | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | - | - | - | - |
| | テーブルサイズ(バイト) | | データテーブルサイズを計算します(Hiveテーブルのみサポート)。 | ✅ | - | - | ✅ | ✅ | - | - | - | - | - | - | - |
| 即時性 | データ生成の即時性 | | データ行数を計算し、行数が0の場合、データが生成されていないとみなします。 | ✅ = 0 | - | - | - | - | - | - | - | - | - | - | - |
フィールドレベル | 正確性 | フィールド数値 | 平均値 | 数値の平均値を計算します。 | ✅ | - | - | ✅ | ✅ | ✅ | ✅ | ✅ | - | - | - | - |
| | | 集計値 | 数値の集計値を計算します。 | ✅ | - | - | ✅ | ✅ | ✅ | ✅ | ✅ | - | - | - | - |
| | | 中央値 | 数値の中央値を計算します。 | ✅ | - | - | ✅ | ✅ | ✅ | ✅ | ✅ | - | - | - | - |
| | | 最小値 | 数値の最小値を計算します。 | ✅ | - | - | ✅ | ✅ | ✅ | ✅ | ✅ | - | - | - | - |
| | | 最大値 | 数値の最大値を計算します。 | ✅ | - | - | ✅ | ✅ | ✅ | ✅ | ✅ | - | - | - | - |
| 一意性 | フィールド一意値 | 一意値の個数 | 一意値を検証します。 | - | - | - | - | - | - | - | - | ✅ | - | - | - |
| | | 一意値の個数/総行数 | | - | - | - | - | - | - | - | - | ✅ | - | - | - |
| | フィールド重複値 | 重複値の個数 | 重複値を検証します。 | - | - | - | - | - | - | - | - | ✅ | - | - | - |
| | | 重複値の個数/総行数 | | - | - | - | - | - | - | - | - | ✅ | - | - | - |
| 完全性 | フィールドNULL値 | NULL値の個数 | 空値を検証します。 | - | - | - | - | - | - | - | - | ✅ | - | - | - |
| | | NULL値の個数/総行数 | | - | - | - | - | - | - | - | - | ✅ | - | - | - |
| 有効性 | 携帯電話番号形式 | 不正件数 | 正規表現で検証し、中国本土の携帯電話番号形式に適合していることを確認します。 | - | - | - | - | - | - | - | - | - | ✅ | - | - |
| | | 不正件数/総行数 | | - | - | - | - | - | - | - | - | - | ✅ | - | - |
| | メールアドレス形式 | 不正件数 | 正規表現で検証し、メール形式に適合していることを確認します。 | - | - | - | - | - | - | - | - | - | ✅ | - | - |
| | | 不正件数/総行数 | | - | - | - | - | - | - | - | - | - | ✅ | - | - |
| | 身分証形式 | 不正件数 | 正規表現で検証し、中国本土の身分証明書形式に適合していることを確認します。 | - | - | - | - | - | - | - | - | - | ✅ | - | - |
| | | 不正件数/総行数 | | - | - | - | - | - | - | - | - | - | ✅ | - | - |
| 一貫性 | フィールドデータ範囲 | 数値範囲 | 数値が数値範囲内にあるかどうかを検出します。 | - | ✅ | - | - | - | - | - | - | - | - | - | - |
| | | 列挙範囲 | 文字値が列挙値内にあるかどうかを検出します。 | - | - | - | - | - | - | - | - | - | - | ✅ | - |
| | フィールドデータ相関性 | | 別のテーブルの特定のフィールドとサイズを比較します。 | - | - | - | - | - | - | - | - | - | - | - | ✅ |
推論テーブルテンプレート
モデル推論テーブルに対して、正確性の次元から、モデルドリフト、モデル分類、モデル回帰の3タイプ20個のテンプレートを提供します。以下に示します:
説明:
現在はDLCエンジンにのみ適用されます。
監視対象 | 维度 | 指標名 | 適用特徴タイプ | 意味と計算方法 |
モデル推論テーブル | 分類モデル | 正確率 | - | 正しく予測された割合。 True Positive(TP、真正):実際はiクラスであり、かつiクラスと予測されたものです。例:labelがAクラスであり、かつpredictがAクラスである場合です。 |
| | 適合率 | - | 正クラスと予測されたサンプルのうち、実際に正クラスである割合、TP/(TP+FP) True Positive(TP、真正):実際は正クラスであり、かつ正クラスと予測されたものです。例:labelがAクラスであり、かつpredictがAクラスである場合です。 False Positive(FP、偽陽性):実際は負クラスであるが、正クラスと予測されたものです。例:labelがAクラスではなく、かつpredictがAクラスである場合です。 False Negative(FN、偽陰性):実際は正クラスであるが、負クラスと予測されたものです。例:labelがAクラスであり、かつpredictがAクラスではない場合です。 True Negative(TN、真陰性):実際は負クラスであり、かつ負クラスと予測されたものです。例:labelがAクラスではなく、かつpredictがAクラスではない場合です。 |
| | 再現率 | - | 正クラスであるサンプルのうち、正しく予測された割合、TP/(TP+FN) True Positive(TP、真正):実際は正クラスであり、かつ正クラスと予測されたものです。例:labelがAクラスであり、かつpredictがAクラスである場合です。 False Positive(FP、偽陽性):実際は負クラスであるが、正クラスと予測されたものです。例:labelがAクラスではなく、かつpredictがAクラスである場合です。 False Negative(FN、偽陰性):実際は正クラスであるが、負クラスと予測されたものです。例:labelがAクラスであり、かつpredictがAクラスではない場合です。 True Negative(TN、真陰性):実際は負クラスであり、かつ負クラスと予測されたものです。例:labelがAクラスではなく、かつpredictがAクラスではない場合です。 多クラス分類の場合: |
| | F1スコア | - | 適合率と再現率の調和平均です。2*(precision*recall)/(precision+recall)= に相当します。 F1-Score = 2 * TP / (2 * TP + FP + FN) |
| | 予測パリティ | - | 異なるグループ(性別、人種など)において、正クラスと予測されたサンプルのうち実際に正クラスである割合(すなわち正の予測値、PPV)が等しいことをモデルに要求します。その核心的な考え方は、モデルが正クラスを予測する際に、異なるグループに対する正確率が同じであるべき、つまり正しく正クラスと予測された正サンプルの割合が一致するべきであるということです。 指定したグループ属性のPPVを算出します。例えば、すべての白人、黒人の与信審査結果をそれぞれ抽出してppvを計算します: 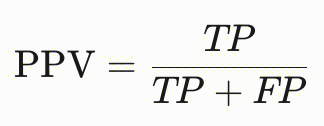 |
| | 予測平等性 | - | 異なるグループ(性別、人種などのセンシティブ属性で区分されたグループ)における偽陽性率(FPR)の一貫性を測定するために使用されます。その核心的な考え方は、モデルが負クラスを予測する際に、異なるグループに対する誤判定率が同じであるべき、つまり誤って正クラスと予測された負サンプルの割合が一致するべきであるということです。 指定したグループ属性のFPRを算出します。例えば、すべての白人、黒人の与信審査結果をそれぞれ抽出してFPRを計算します: 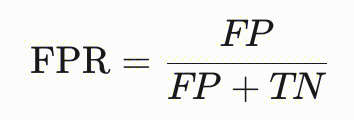 |
| | 機会均等性 | - | 異なるグループ(性別、人種などのセンシティブ属性で区分されたグループ)における真陽性率(TPR)の一貫性を測定するために使用されます。その核心的な考え方は、モデルが「実際に正クラスである」サンプルに対して、異なるグループにおける正クラス予測確率が同じであるべきであり、優勢グループと劣勢グループが同等の機会を得られることを保証するということです。 指定したグループ属性のTPRを算出します。例えば、すべての白人、黒人の与信審査結果をそれぞれ抽出してTPRを計算します: 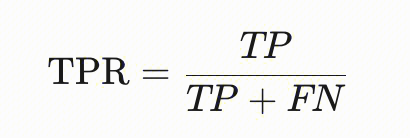 |
| | 統計的パリティ | - | 異なるグループ(性別、人種などのセンシティブ属性で区分されたグループ)における予測結果の分布の均衡性を測定するために使用されます。その核心的な考え方は、モデルが異なるグループに対して正クラスと予測する確率が同じであるべきであり、つまりグループ属性に関係なく、正の予測を得る機会が均等であるべきであるということです。 指定したグループ属性の統計的均等性を算出します。例えば、すべての白人、黒人の与信審査結果をそれぞれ抽出してselection rateを計算します: 例えば白人のselection rate=白人で正クラスと予測されたサンプル数/白人の総数 |
| 回帰モデル | 平均二乗誤差(MSE) | - | 値は0から無限大までで、低いほど良好です。予測値と実測値の間の乖離度を反映し、値が小さいほど精度が高くなります。yiはlabel値で、上付き三角が付いているもう一方はpredict値です。 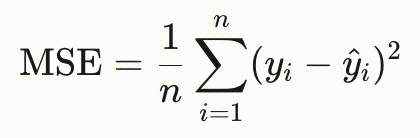 |
| | 平均二乗平方根誤差(RMSE) | - | 値は0から無限大までで、低いほど良好です。MSEの平方根であり、異常値に敏感で、値が小さいほど精度が高くなります。yiはlabel値で、上付き三角が付いているもう一方はpredict値です。 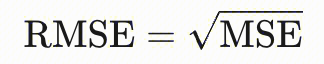 |
| | 平均絶対誤差(MAE) | - | 値は0から無限大までで、低いほど良好です。予測誤差の絶対値を直接測定します。yiはlabel値で、上付き三角が付いているもう一方はpredict値です。 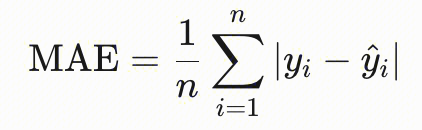 |
| | 平均絶対パーセント誤差(MAPE) | - | 値は0から無限大までで、低いほど良好です。過小評価誤差(予測値 < 実測値)に対するペナルティは過大評価誤差よりも高くなります。yiはlabel値で、上付き三角が付いているもう一方はpredict値です。 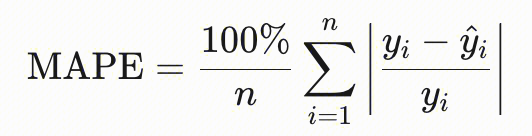 |
| | 決定係数r2スコア | - | r2スコアは0から1の間の値をとり、1に近いほど回帰フィッティングの効果が良好です。yiはlabel値で、上付き三角が付いているもう一方はpredict値です。 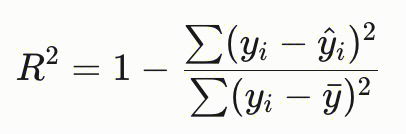 |
| モデルドリフト | カイ二乗検定 | カテゴリー | データ分布に有意な変化が発生しているかどうかを検出するための統計手法であり、特にカテゴリ変数や離散データの分布比較に適しています。その核心的な考え方は、実際の観測度数と理論上の期待度数との差を比較することにより、その差がランダムな変動によるものか、それとも実際の分布の偏移を反映しているのかを判断するというものです。 Oi:i番目のカテゴリの観測度数です。 Ei:i番目のカテゴリの期待度数(基準分布に基づく) 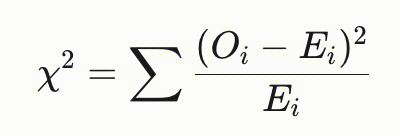 |
| | KS検定 | 数値 | ノンパラメトリック統計手法であり、2つのデータグループの分布に有意な差があるかどうかを検出するために使用されます。 KS検定は、2つのデータグループの累積分布関数(CDF)を比較し、その最大垂直距離(D値)を統計量として計算し、分布が一致しているかどうかを判断します: F1(x)とF2(x)は、それぞれ2つのグループのデータのCDFです。 D値が大きいほど、分布の差は顕著になります。p値が0.05未満の場合、帰無仮説を棄却します(つまり分布のシフトが存在するとみなします)。 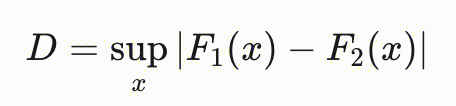 |
| | 全変動距離 | カテゴリー | 2つの確率分布の差を測定するための中核的な指標であり、特にデータ分布の偏移の検出に適しています。 |
| | チェビシェフ距離 | カテゴリー | 2つの確率分布またはデータサンプル間の最大単一次元差を測定するための指標であり、特に極端な値や局所的な顕著な偏移の検出に適しています。 |
| | ジェンセン・シャノン情報量 | カテゴリー | 2つの確率分布間の差を測定する対称化された指標であり、Kullback-Leibler(KL)ダイバージェンスに基づいて構築されます。分布偏移の検出においてデータ分布の変化度合いを定量化するためによく使用され、特に機械学習モデルの監視やデータドリフト分析において重要な用途があります。 |
| | ワッサースタイン距離 | 数値 | 2つの数値分布間の偏移を計算します。 |
| | 群体安定性指数 | 数値 | 2つのグループ(訓練セットとテストセット、異なる期間のサンプルなど)の分布差を測定する指標であり、リスク管理モデルの監視や特徴量の安定性評価に広く応用されています。 |
使用説明
名詞 | 説明 | |
監視対象 | テーブルレベル | 監視対象が通常のテーブルである場合、テーブル行数、テーブルサイズ、テーブルデータ生成の適時性(テーブル行数と同等)を監視できます。 監視対象がモデル推論テーブルである場合、モデルドリフト、モデル分類、モデル回帰の3つの次元からテーブルの複数の特徴を監視できます。 |
| フィールドレベル | 監視対象がフィールドレベルの場合、フィールドの数値(平均値、最大値、最小値、中央値、合計値を含む)、フィールドの値形式(携帯電話番号、メールアドレス、身分証明書番号)、フィールドが空かどうかを監視できます。 |
ルールディメンション | - | ルールディメンションは品質スコアを計算するためのものであり、異なるタイプのルールの品質割合を示します。 システムには6つのルールディメンションが組み込まれています:正確性、一意性、完全性、一貫性、即時性、有効性。 |
検証方式 | 数値型 | 主に数値の大小比較、数値範囲の比較が含まれます。 |
| 変動率型 | 用語説明: 変動率型は数値の変動を示すために使用されます。つまり、ある時点と比較した、今回の上昇/下降幅を表します。 計算式: 変動率 = 今回のスキャン結果/ある時点のスキャン結果 * 100%。 説明: ボラティリティの計算結果はパーセントです。ボラティリティテンプレートを使用する際は、パーティションを指定する必要があります。 例1:7日前の周期変動 パーティションを指定し、基準値として7日前のデータを選択した場合、計算結果が100%であれば、 今回のパーティションデータが、7日前のパーティションデータと比較して1倍増加したことを示します。 例2:前周期変動: パーティションを指定し、基準値として前回の実行周期を選択し、ルールを本番スケジュールタスク(例:あるオフライン開発タスク)に関連付けた場合、計算結果が100%であれば、 今回のオフライン開発タスクの実行終了後の統計データが、前回の実行終了後の統計データと比較して1倍増加したことを示します。 例3:周期変動率+デフォルト周期: 周期変動率テンプレートを使用して品質ルールを設定する際に、デフォルト周期(例:7日前)を設定します。このルールが本番スケジュールタスクに関連付けられていない場合、計算結果が100%であれば、 今回のパーティションデータが、7日前のパーティションデータと比較して1倍増加したことを示します。つまり、当期データを7日前のデータと比較することを意味します。 |
| 標準スコア型 (分散変動) | 用語説明: 標準スコアは重要な統計概念であり、ある値が信頼できる区間範囲内にあるかどうかを示すことができます。 計算結果が大きすぎるか小さすぎる場合、このデータが異常値である可能性が極めて高いことを示します。 計算式: 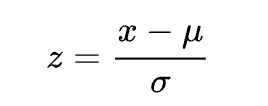 説明: 標準スコアの計算結果は単位のない小数であり、データがデータセット内で異常かどうかを示すことができます。 一般的に、標準スコアの絶対値が3より大きい場合は異常値とみなされ、その時の正常である可能性はわずか0.28%です。 [-1,1]:正常である可能性:68.26% [-2,2]:正常である可能性:95.44% [-3,3]:正常である可能性:99.72% [-3,3]に属さない:正常である可能性:0.28% |
| その他 | 検証フィールドのタイプを制限しません。 空/一意/重複:空値/一意値/重複値の個数または割合を統計します。 形式一致:形式に一致しない個数または割合を統計します。 列挙範囲:列挙値に含まれない個数を統計します。 説明: ここで入力するのは期待値です。フィールドが範囲内にない場合、アラートがトリガーされます。 フィールド相関性:別のデータベーステーブルのフィールド値と同じかどうかを統計します。 比較関係:より大きい、より小さい、等しい。 対象データ:データベーステーブル、フィールド、フィルタ条件。 関連条件:2つのテーブルの関連フィールド。 説明: 比較テーブルは検出テーブルのデータと1対1で対応する必要があります。 |
フィードバック