MCP Server
ダウンロード
フォーカスモード
フォントサイズ
1. ユースケース
対象ユーザー:CodeBuddy / Cursor / Claude DesktopなどのAIクライアントで、自然言語を使用してWeDataメタデータを直接クエリし、データ探索SQLを実行したい方。
プロトコル:MCP(Model Context Protocol)、転送方式はStreamable HTTP、サービスはWeDataプラットフォームでホスティングされるため、ローカルインストールは不要です。
現在、WeData MCP ServerはWeDataのメタデータクエリおよびデータ探索(SQL実行)機能を一連の標準MCPツールにカプセル化しています。設定完了後、AIクライアントで自然言語を使用して質問するだけで、モデルが自動的にツール呼び出しをオーケストレーションします。典型的なフローは以下の通りです:
プロジェクトを確認する → データソースを確認する → データベースを確認する → テーブルを確認する → フィールドを確認する → SQLを送信する → 結果をポーリングする
適用シナリオの例:
「私にはどのようなWeDataプロジェクトがありますか。このプロジェクトにはどのようなデータソースがありますか。」
「あるデータソースの特定のテーブルにはどのようなフィールドがあり、どれがパーティションフィールドですか。」
「SQLを1本実行して、各都市の1日あたりの売上が1000を超える日付を集計してください」
「まずデータベースとテーブルを作成し、次にデータを数件挿入して、それから集計してください」
2. 前提条件
プロジェクト | 要件 |
MCPクライアント | streamable-http 転送をサポートするクライアント(CodeBuddy、Cursor、Claude Desktop など)。 |
認証情報 | TencentCloud API キー SecretId / SecretKey、かつそのアカウントが WeData で対応するプロジェクト/データ権限を持っていること。 |
リージョン | WeData の所在地域と一致させます。例えば、ap-guangzhou、ap-singapore です。 |
ネットワーク | 公衆ネットワーク *.wedata.cloud.tencent.com にアクセスできます。 |
3. インストール手順
3.1 キーの取得
鍵の取得方法は2種類あり、ユーザーは自分のシナリオに応じてそのいずれかを選択できます:
3.1.1 長期AKSK方式
Tencent Cloud CAMコンソールでAPIキーを作成し、
SecretIdとSecretKeyを取得します。注意:
セキュリティに関する注意:キーはあなたのアカウントIDに相当し、ローカルの
mcp.jsonまたは環境変数にのみ保存されます。コードリポジトリに書き込まないでください。会話、ドキュメント、チケットに貼り付けないでください。3.1.2 Entra ID方式
entraIdでログインした後、以下のページでアクセス認証情報を取得します:
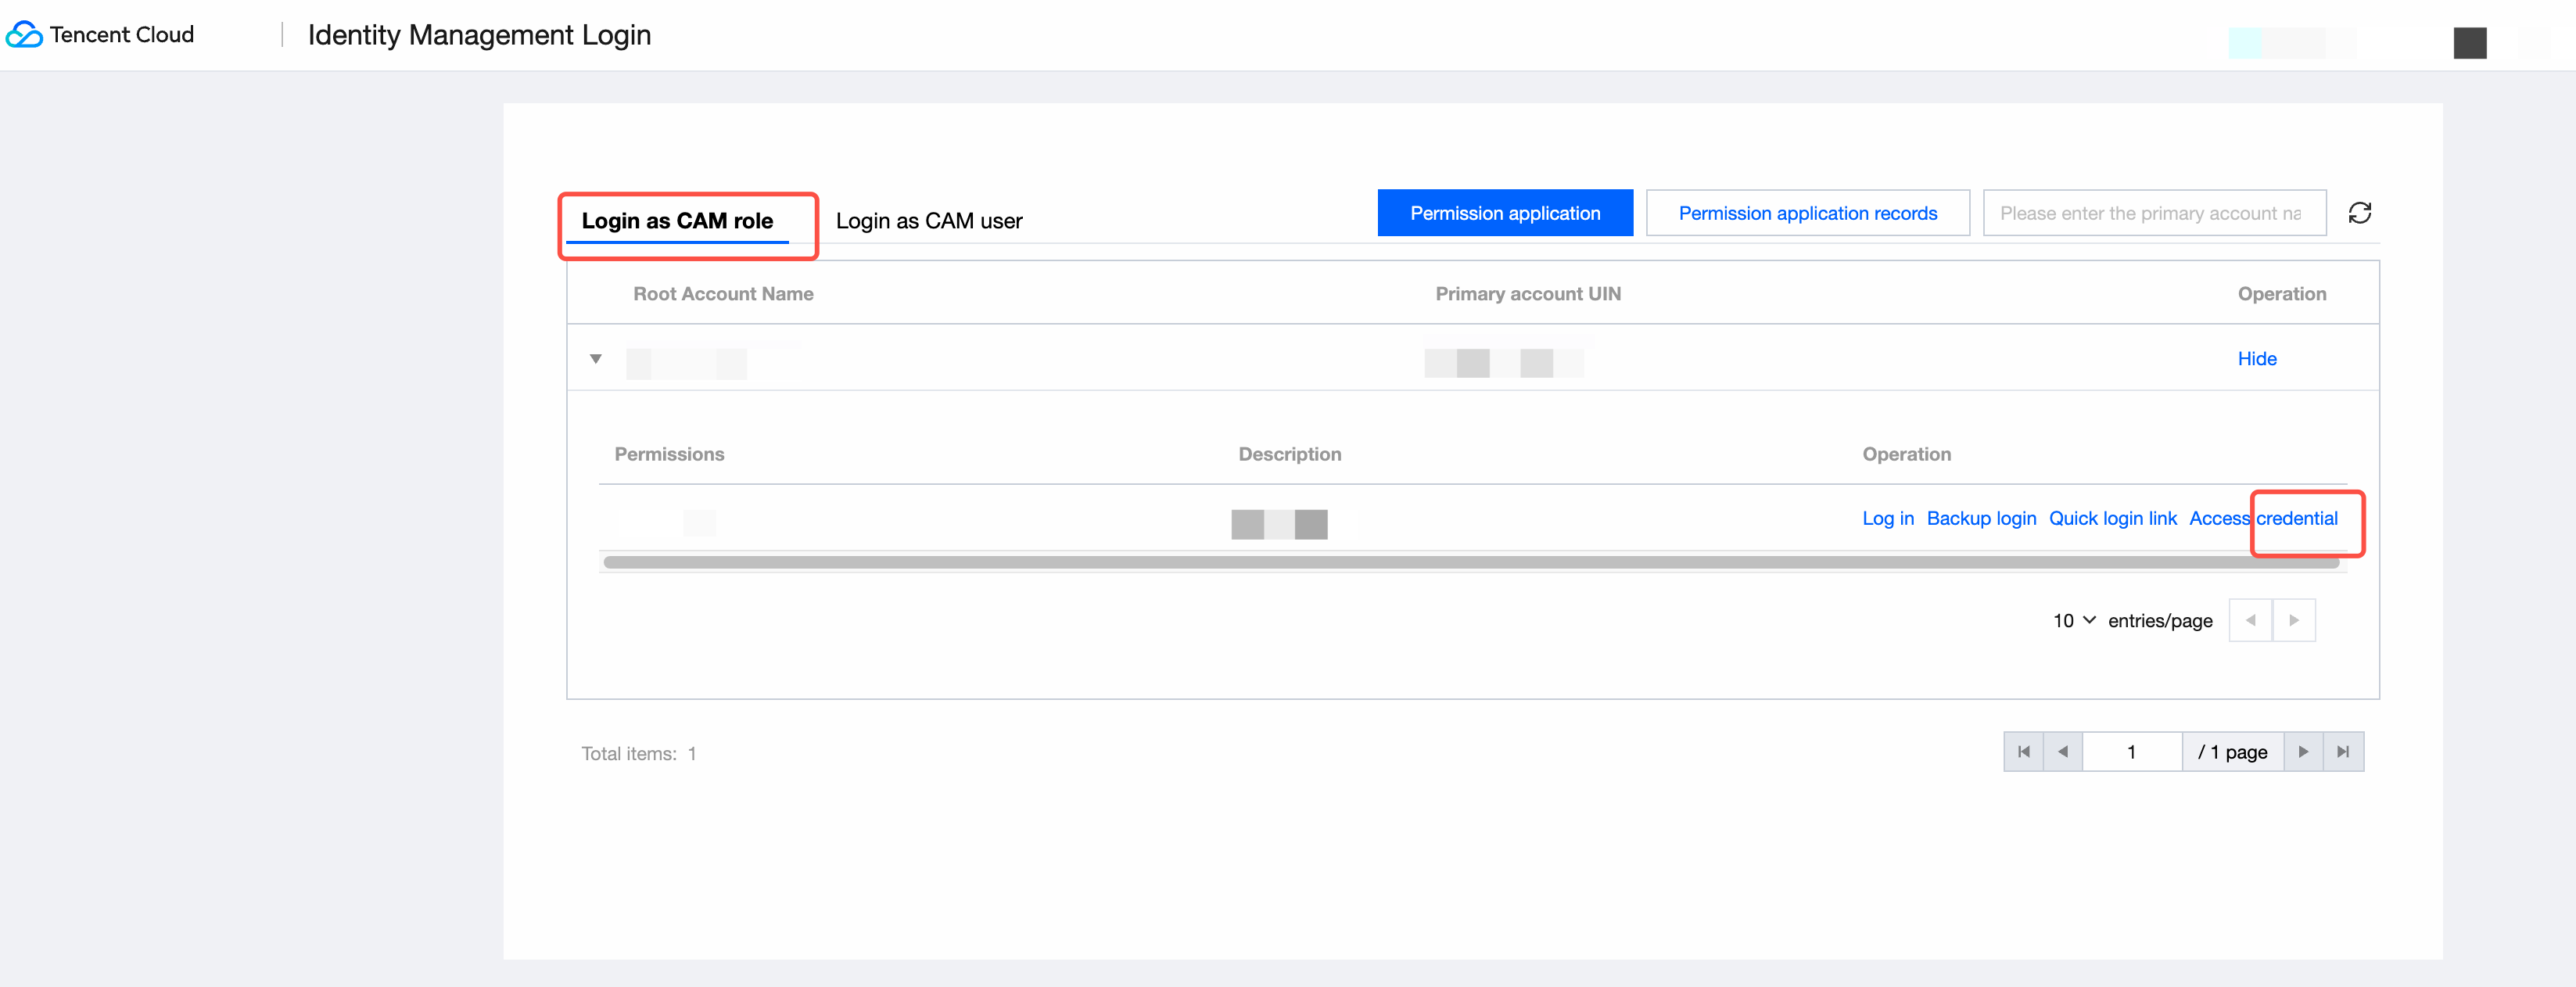
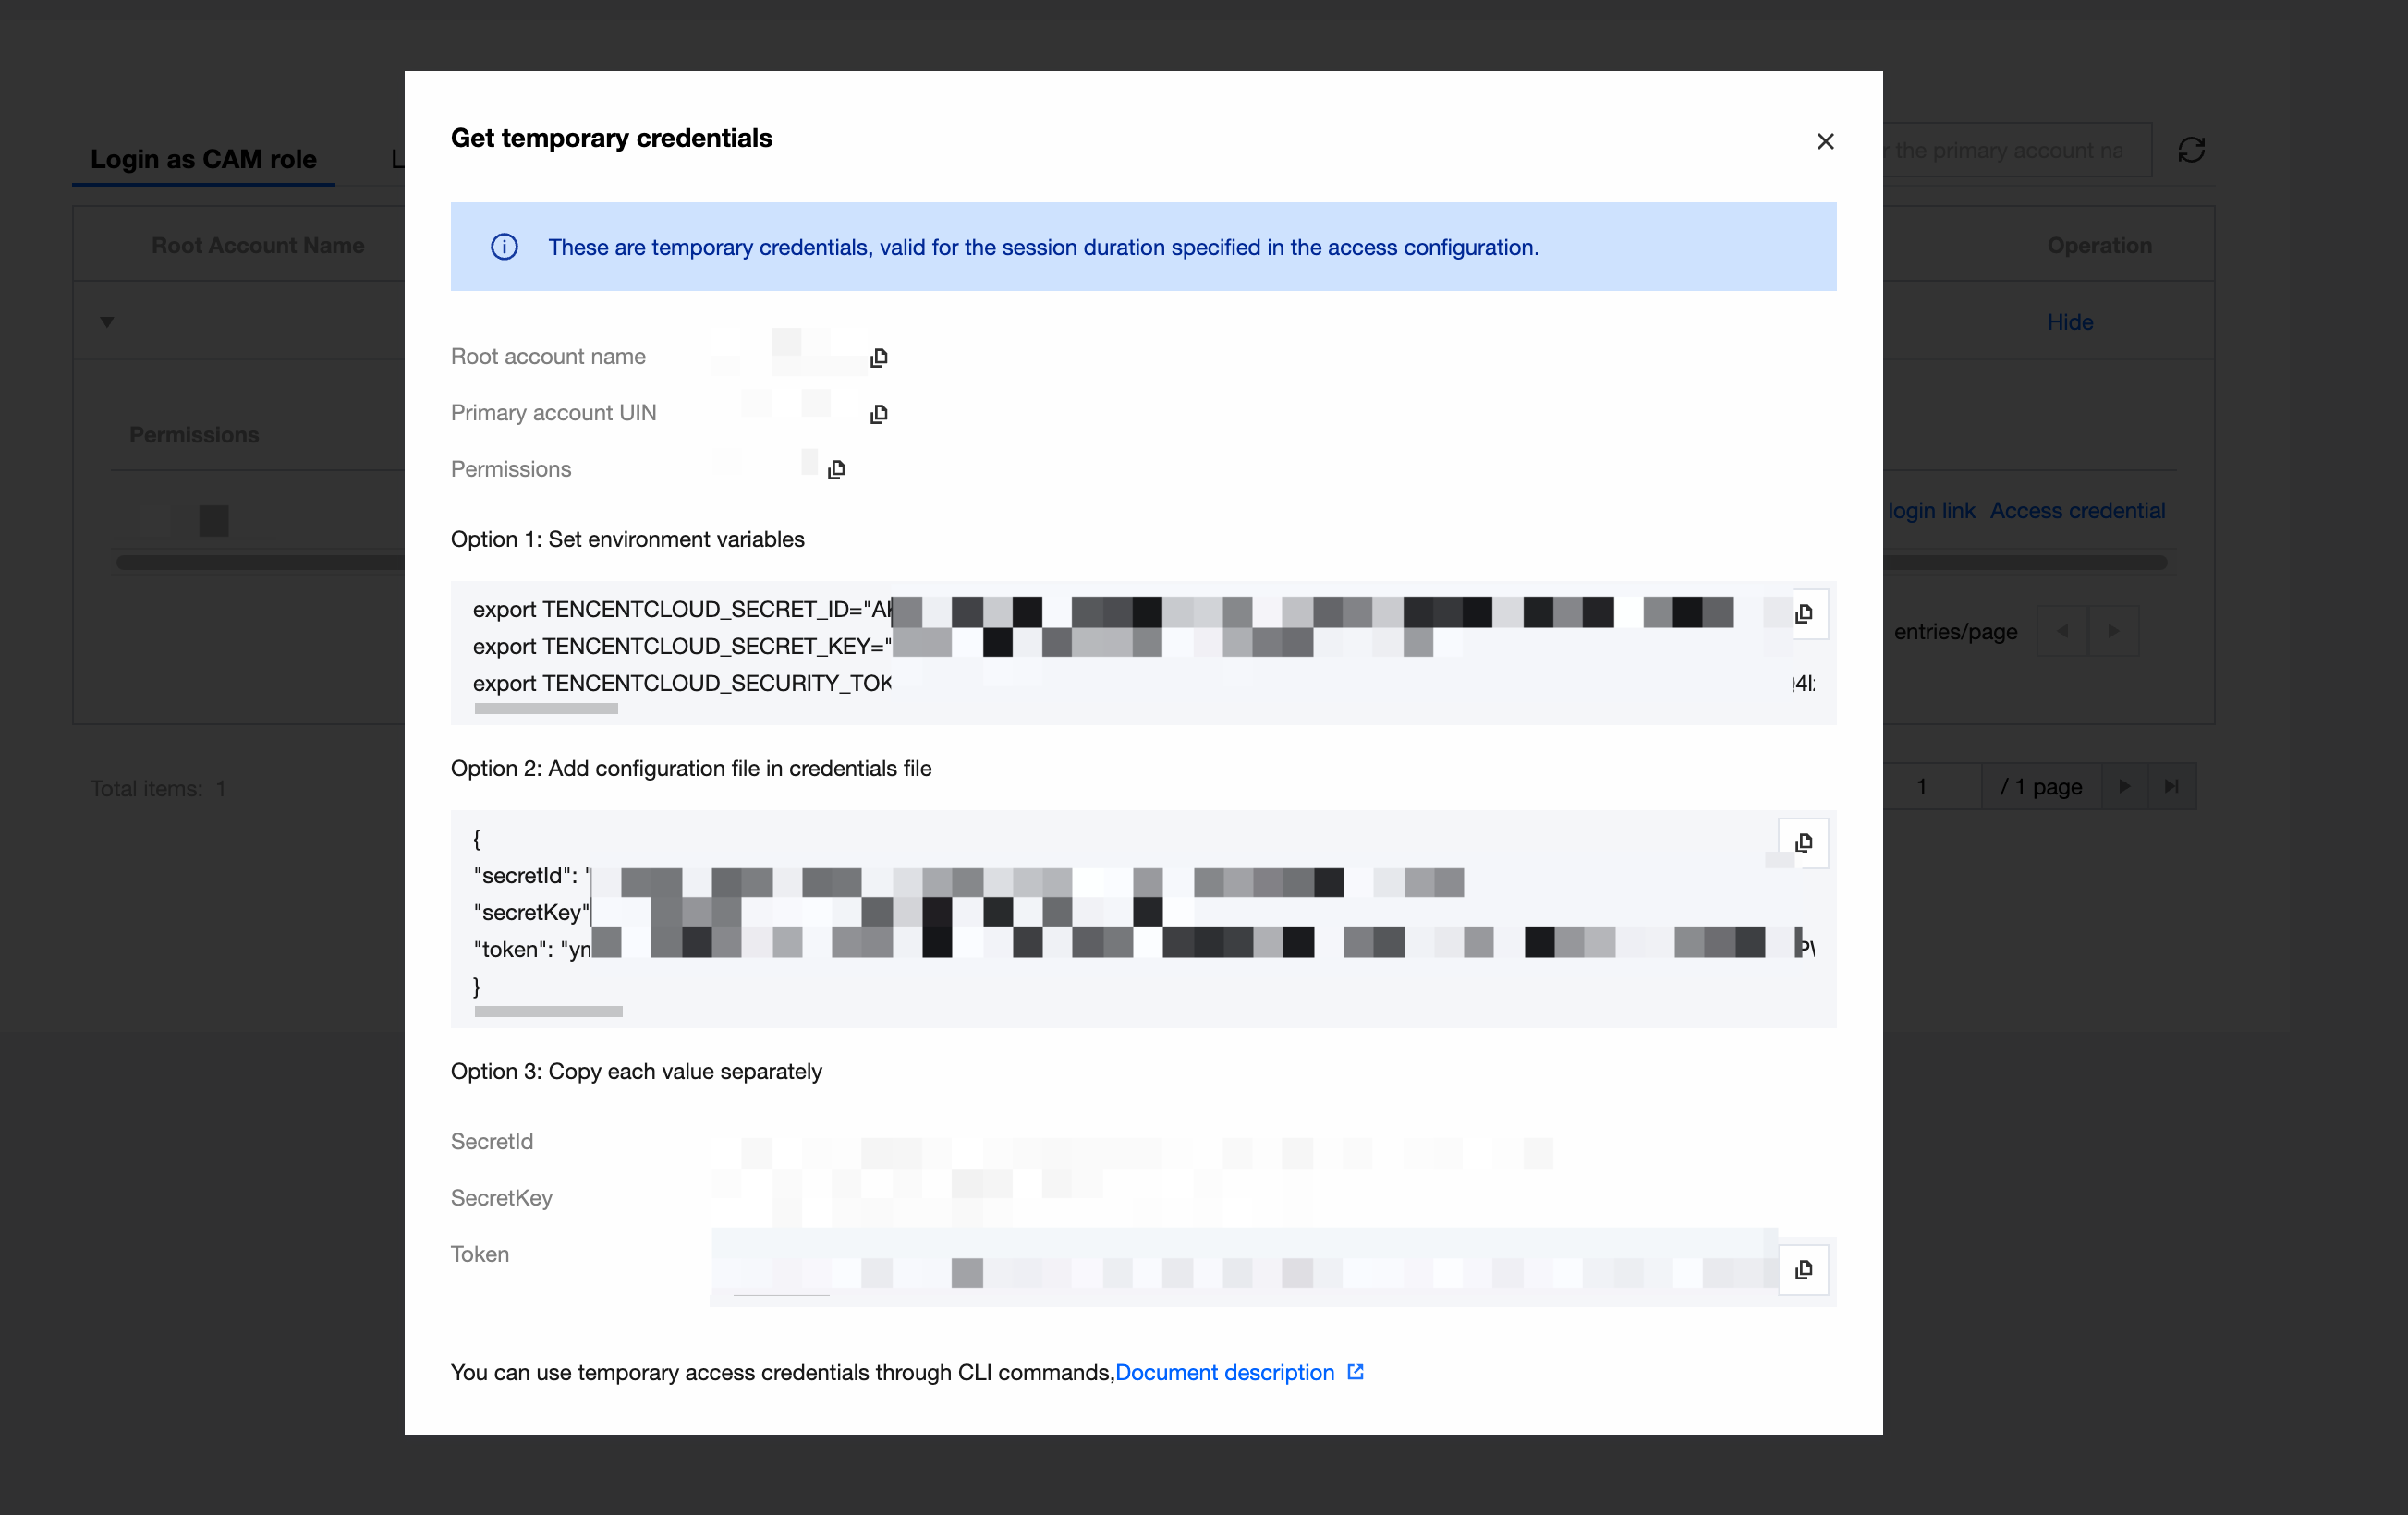
3.2 クライアントへのMCP設定の追加
クライアントのMCP設定ファイルを開き(CodeBuddyでは「設定 → MCP設定 → MCPの設定」から
mcp.jsonを開きます)、以下の内容を追加します:{"mcpServers": {"WeData-MCP-Server": {"url": "https://mcp.wedata.cloud.tencent.com/mcp/wedata/v1/all","timeout": 20000,"transportType": "streamable-http","headers": {"TENCENTCLOUD-SECRET-ID": "<あなたのSecretId>"、"TENCENTCLOUD-SECRET-KEY": "<あなたのSecretKey>"、"TOKEN": "<entraId方式のみ設定が必要です。取得方法は3.1.2を参照してください>"、"TENCENTCLOUD-REGION": "ap-guangzhou"},"disabled": false}}}
フィールドの説明:
フィールド | 必須 | 説明 |
url | はい | MCPサービスエンドポイント 国内環境: https://mcp.wedata.cloud.tencent.com/mcp/wedata/v1/all海外環境: https://mcp.wedata.tencentcloud.com/mcp/wedata/v1/all |
TENCENTCLOUD-SECRET-ID | はい | TencentCloud API キー SecretId |
TENCENTCLOUD-SECRET-KEY | はい | TencentCloud API キー SecretKey |
TOKEN | いいえ | |
TENCENTCLOUD-REGION | はい | リージョン。実際のリージョンに置き換える必要があります。 |
timeout | いいえ | 単位はミリ秒です。ツールの実行が遅い場合は適宜大きくしてください。 |
TOOL-SCOPE | いいえ |
3.3 TOOL-SCOPEによるツール範囲の制御(オプション)
headersにTOOL-SCOPEを追加すると、必要なツールのみを読み込み、モデル選択の干渉を減らすことができます:"TOOL-SCOPE": "data_assets"
複数の範囲は英語のカンマで区切ります:
"TOOL-SCOPE": "data_assets, data_analysis"
注意:
値の範囲はサーバー側が現在サポートしている能力ドメインに準じます(
data_assets、data_analysisなどが確認されています)。入力ミスやスペルの不一致があると、ツールを読み込めません。不明な場合は、最初は設定せず、デフォルトで全てのツールを読み込むことをお勧めします。3.4 接続の検証
設定を保存してクライアントに戻り、
WeData-MCP-Serverのステータスが接続済みと表示され、ツールリストが表示されれば、設定は成功です。その後、そのまま会話するだけで、私が持っているwedataプロジェクトを調べてください。4. サポートツール
ツール | 用途 | 主要パラメータ | 備考 |
list_projects | テナント配下のWeDataプロジェクトをページングで一覧表示します。 | PageNumber、PageSize。オプション:ProjectName、ProjectIds、ProjectModel、Status | Status:0=已停用、1=已启用。ProjectModel:SIMPLE/STANDARD |
list_data_sources | 指定プロジェクト配下のデータソースを一覧表示します。 | ProjectId(必須)。オプション:Name、DisplayName、Type、Creator、PageNumber、PageSize | Typeの値は、MYSQL、HIVE、ICEBERG、DLC、StarRocks、SuperSQLなどです。 |
list_database | ライブラリ(アセット)を一覧表示します。 | PageNumber、PageSize(必須)。オプション:DatasourceId、Keyword、CatalogName | データベース名、Catalog、ストレージサイズ、所属データソースなどを返します。 |
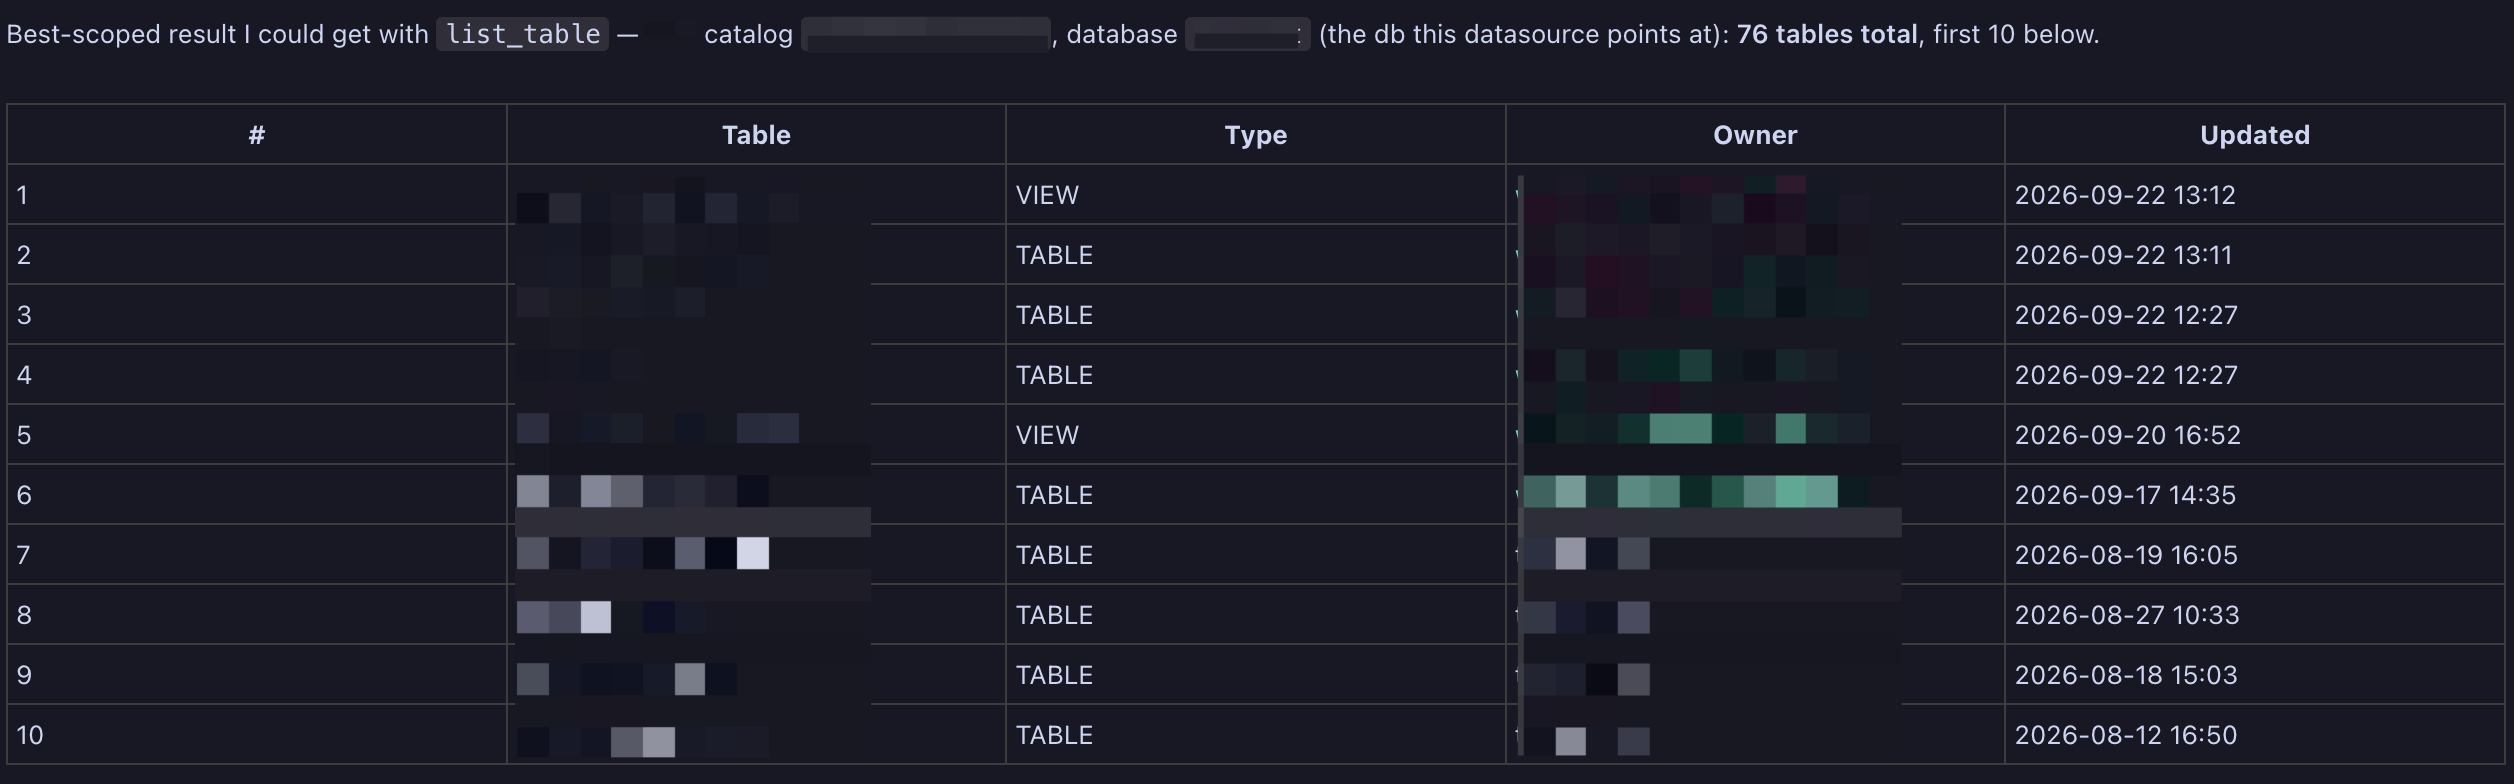
list_table | 指定ライブラリ配下のテーブルを一覧表示します。 | PageNumber、PageSize(必須)。オプション:DatabaseName、DatasourceId、Keyword、CatalogName、SchemaName | テーブル名、タイプ、担当者、ストレージサイズ、更新日時などを返します。 |
get_table_columns | テーブルのフィールドリストを照会します。 | TableGuid(必須) | フィールド名、タイプ、説明、長さ、シーケンス番号、パーティションフィールドかどうかを返します。TableGuidはlist_tableから取得します。 |
list_resource_groups | 実行リソースグループを一覧表示します。 | PageNumber、PageSize(必須)。オプション:Type、ProjectIds、Id、Name | Type:Schedule(スケジュール)/ Integration(統合)/ DataService(データサービス)。SQLを実行するにはScheduleタイプが必要です。 |
execute_sql | SQLをデータ探索に送信し、非同期で実行します。 | ProjectId、ScriptContent、ScriptConfig(DatasourceId、ExecutorGroupIdを含む) | タスクを送信するだけで、すぐにJobIdが返されます。このときのステータスは通常QUEUEDです。 |
poll_sql_result | SQL実行結果とステータスを照会します。 | ProjectId、JobId。オプション:JobExecutionId | 未終了状態の場合、QUEUED/RUNNINGが返され、結果は空です。ポーリングが必要です。 |
5. 典型的なユースケース
5.1 メタデータ探索
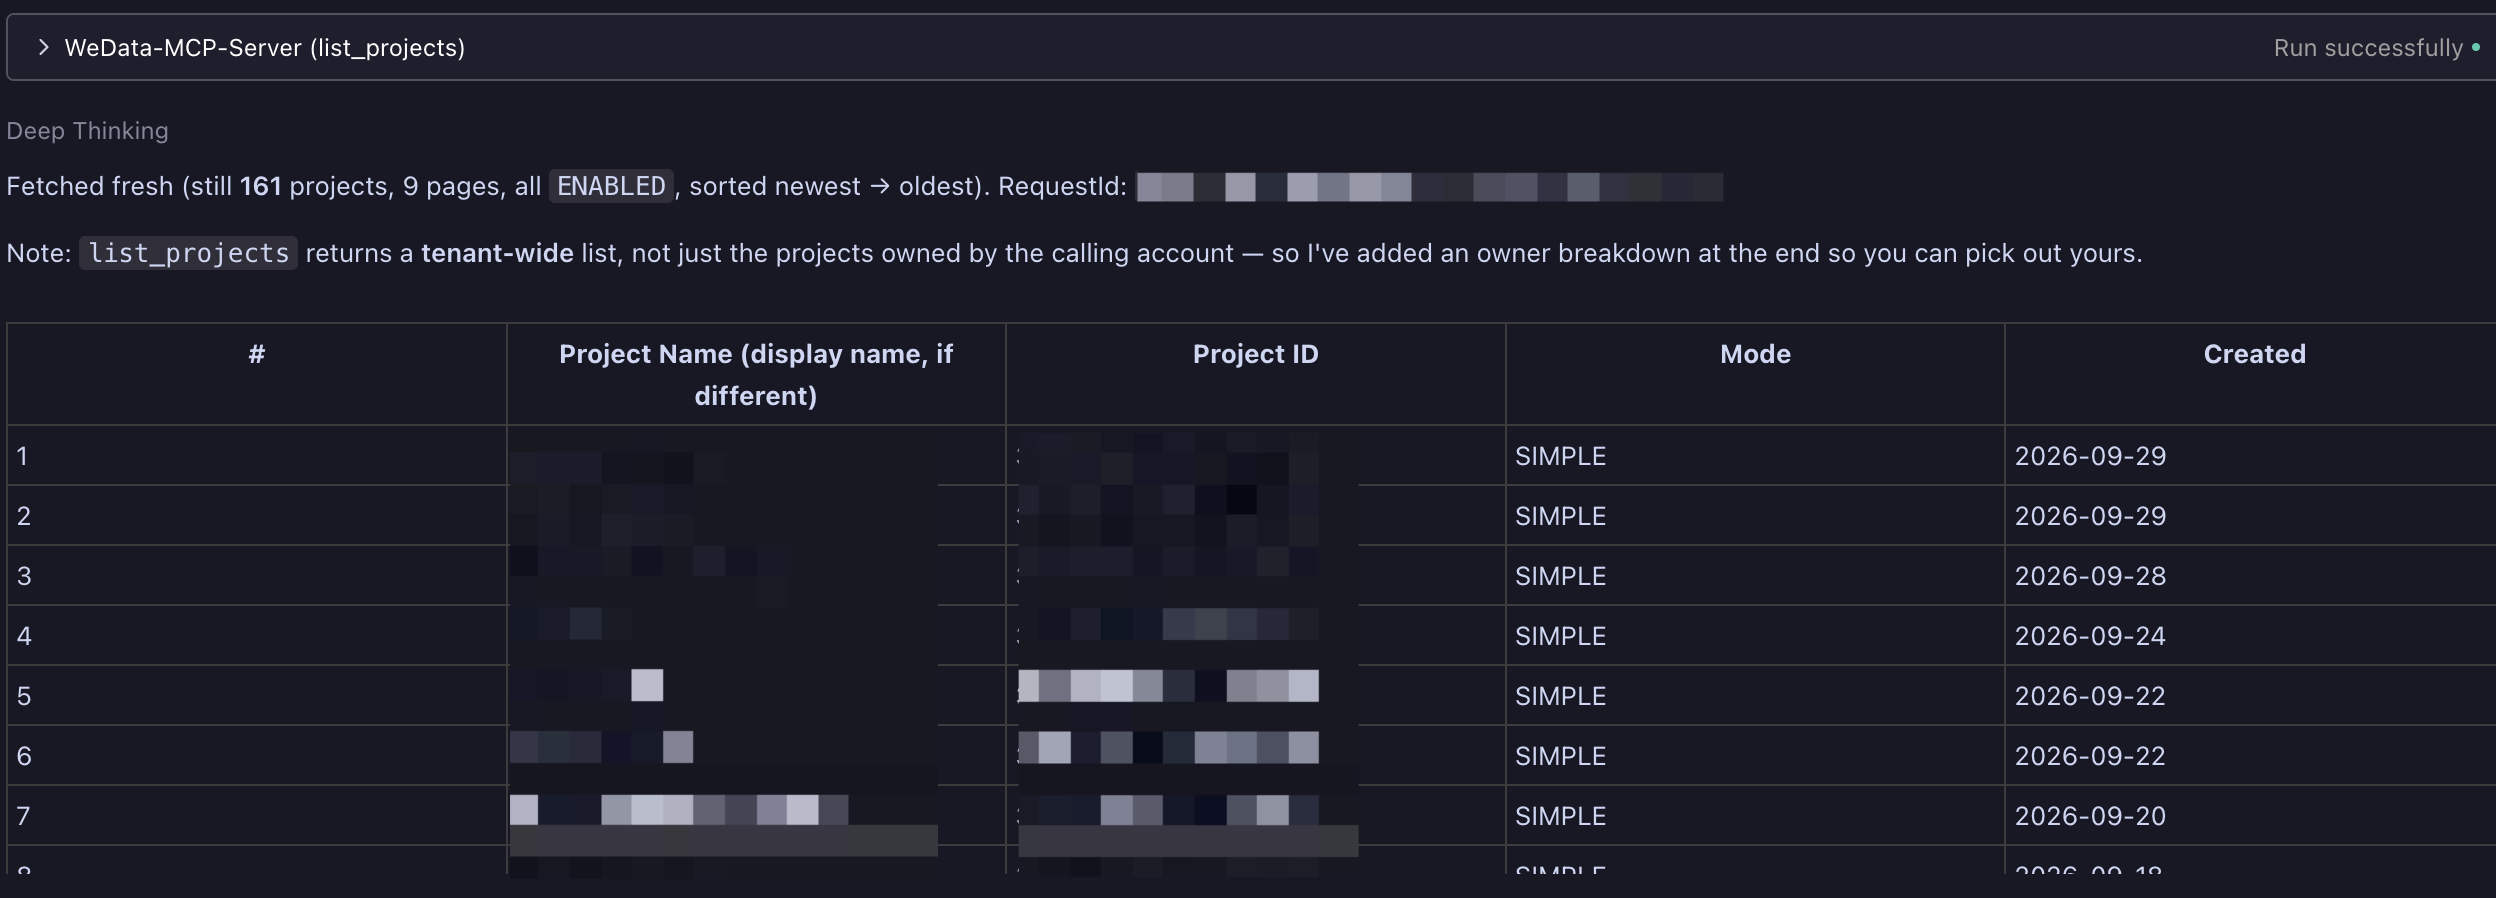
prompt:私が持っているwedataプロジェクトを調べてください:
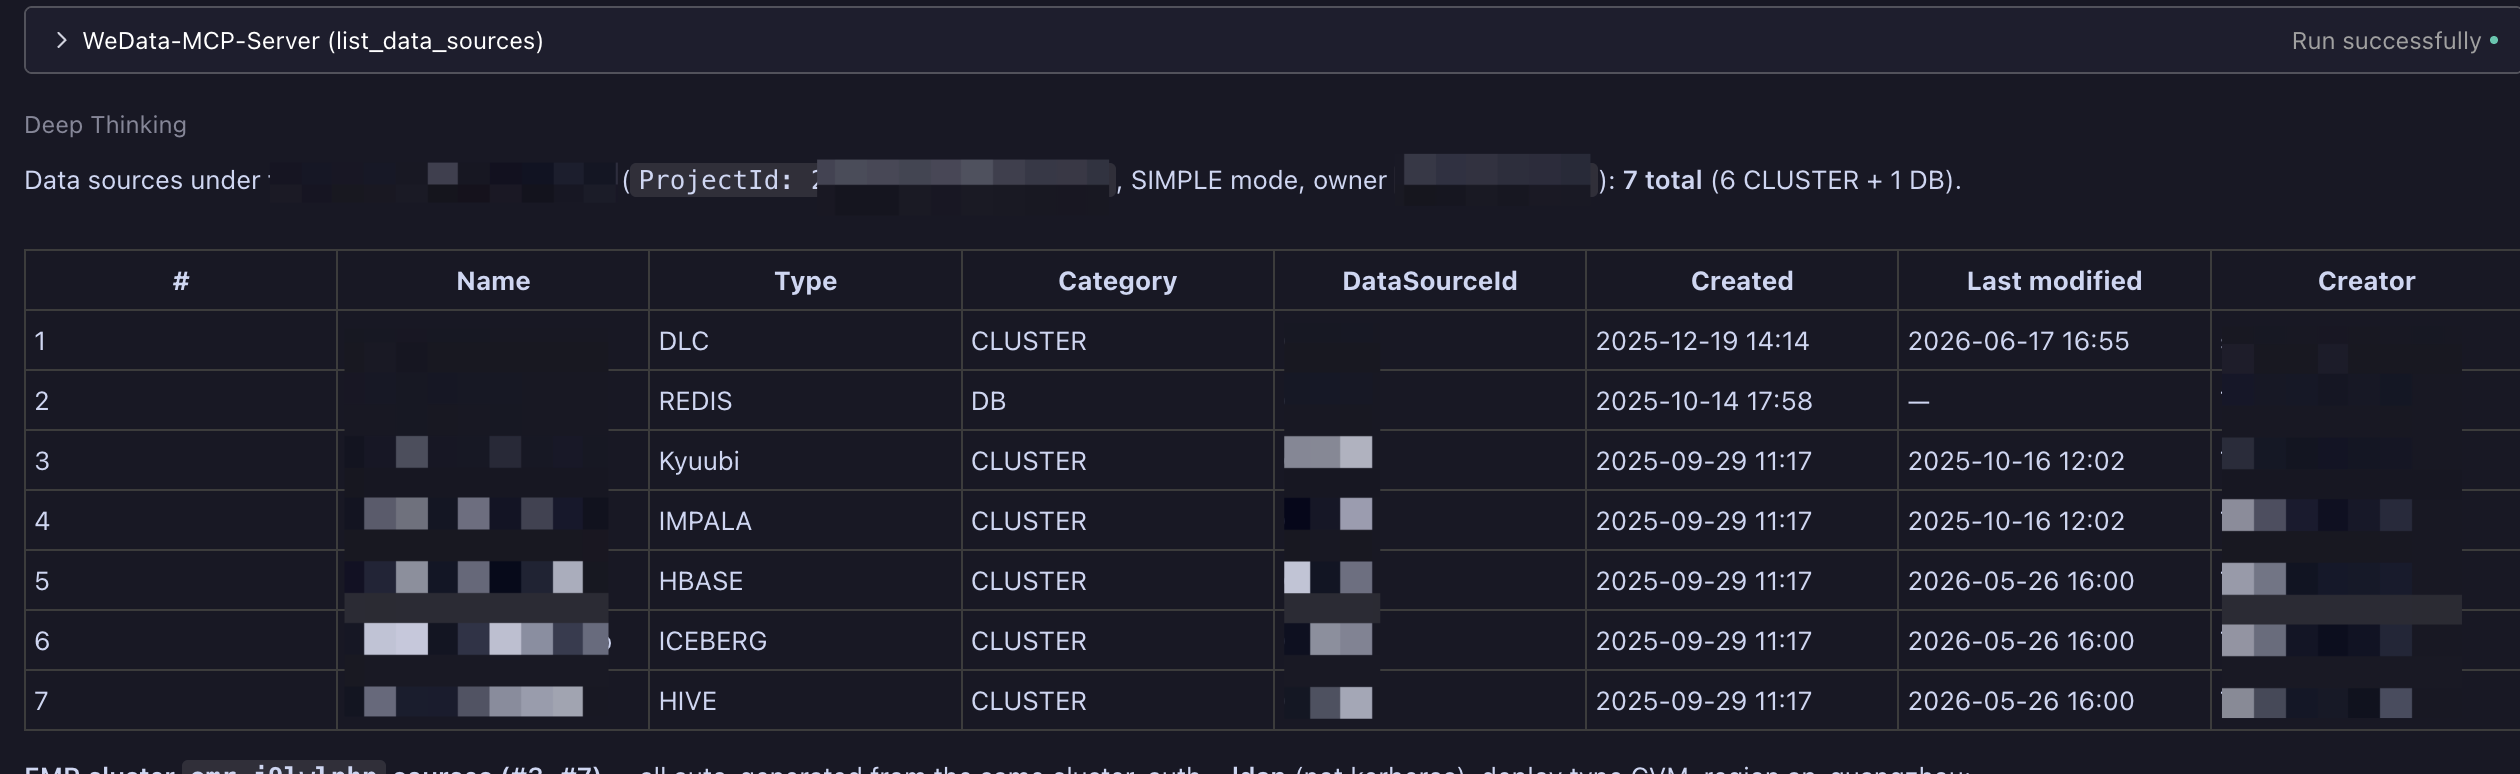
prompt:「プロジェクト名」プロジェクトにある私のwedataデータソースを確認してください:
prompt:「プロジェクト名」プロジェクトの「データソース名」というデータソースにどのようなテーブルがあるか調べてください:
5.2 SQLの実行
1. まずモデルに必要なパラメータを取得させます(直接指定することもできます):
prompt:プロジェクト「プロジェクト名」にどのようなスケジュールリソースグループがあるか調べてください。
2. SQLを送信します:
prompt:
パラメータは以下の通りです。このSQLを実行してください:show databases
ProjectId:「プロジェクトID」
DatasourceId:「データソースID」
ExecutorGroupId:「スケジュールリソースグループID」
3. 結果の取得:モデルは返された
JobIdを使用してpoll_sql_resultを呼び出してポーリングし、ステータスがSUCCESSになるまで繰り返してから、結果を整理して通知します。モデルが自動でポーリングしない場合は、追加で問い合わせることができます:prompt:
タスク「JobId」の実行結果を照会します。
主要パラメータの例:
{"ProjectId": "プロジェクトID"、"ScriptContent": "show databases;","ScriptConfig": {"DatasourceId": "データソースID"、"ExecutorGroupId": "スケジュールリソースグループID"、}}
5.3 エンドツーエンドのシナリオ
prompt:
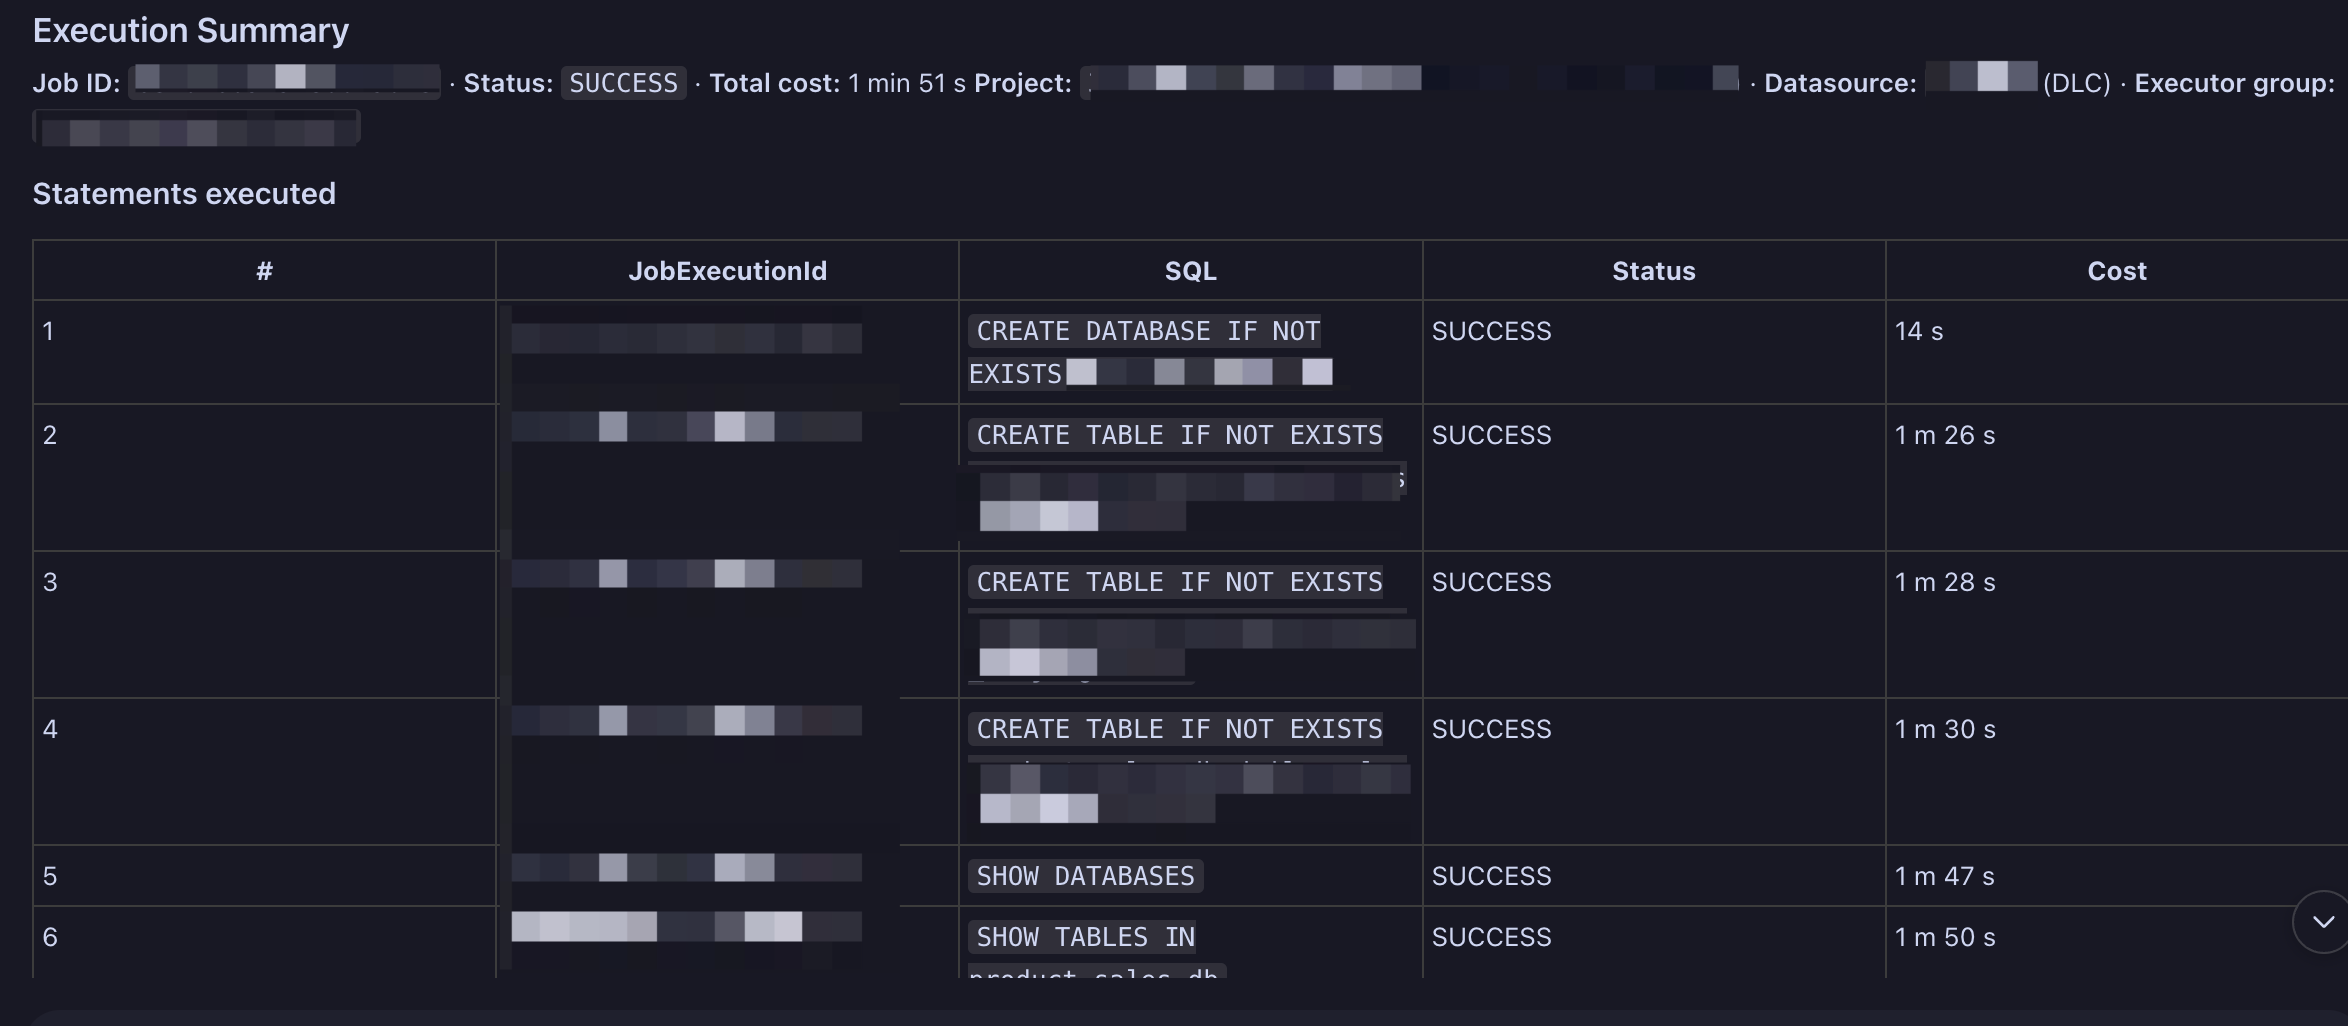
「データソース名」というデータソースの下に商品販売用のデータベースを作成して、そのデータベースの下に3つのテーブルを作成してください。
それぞれ成都、北京、上海の3都市における毎日の販売商品数と収入です:
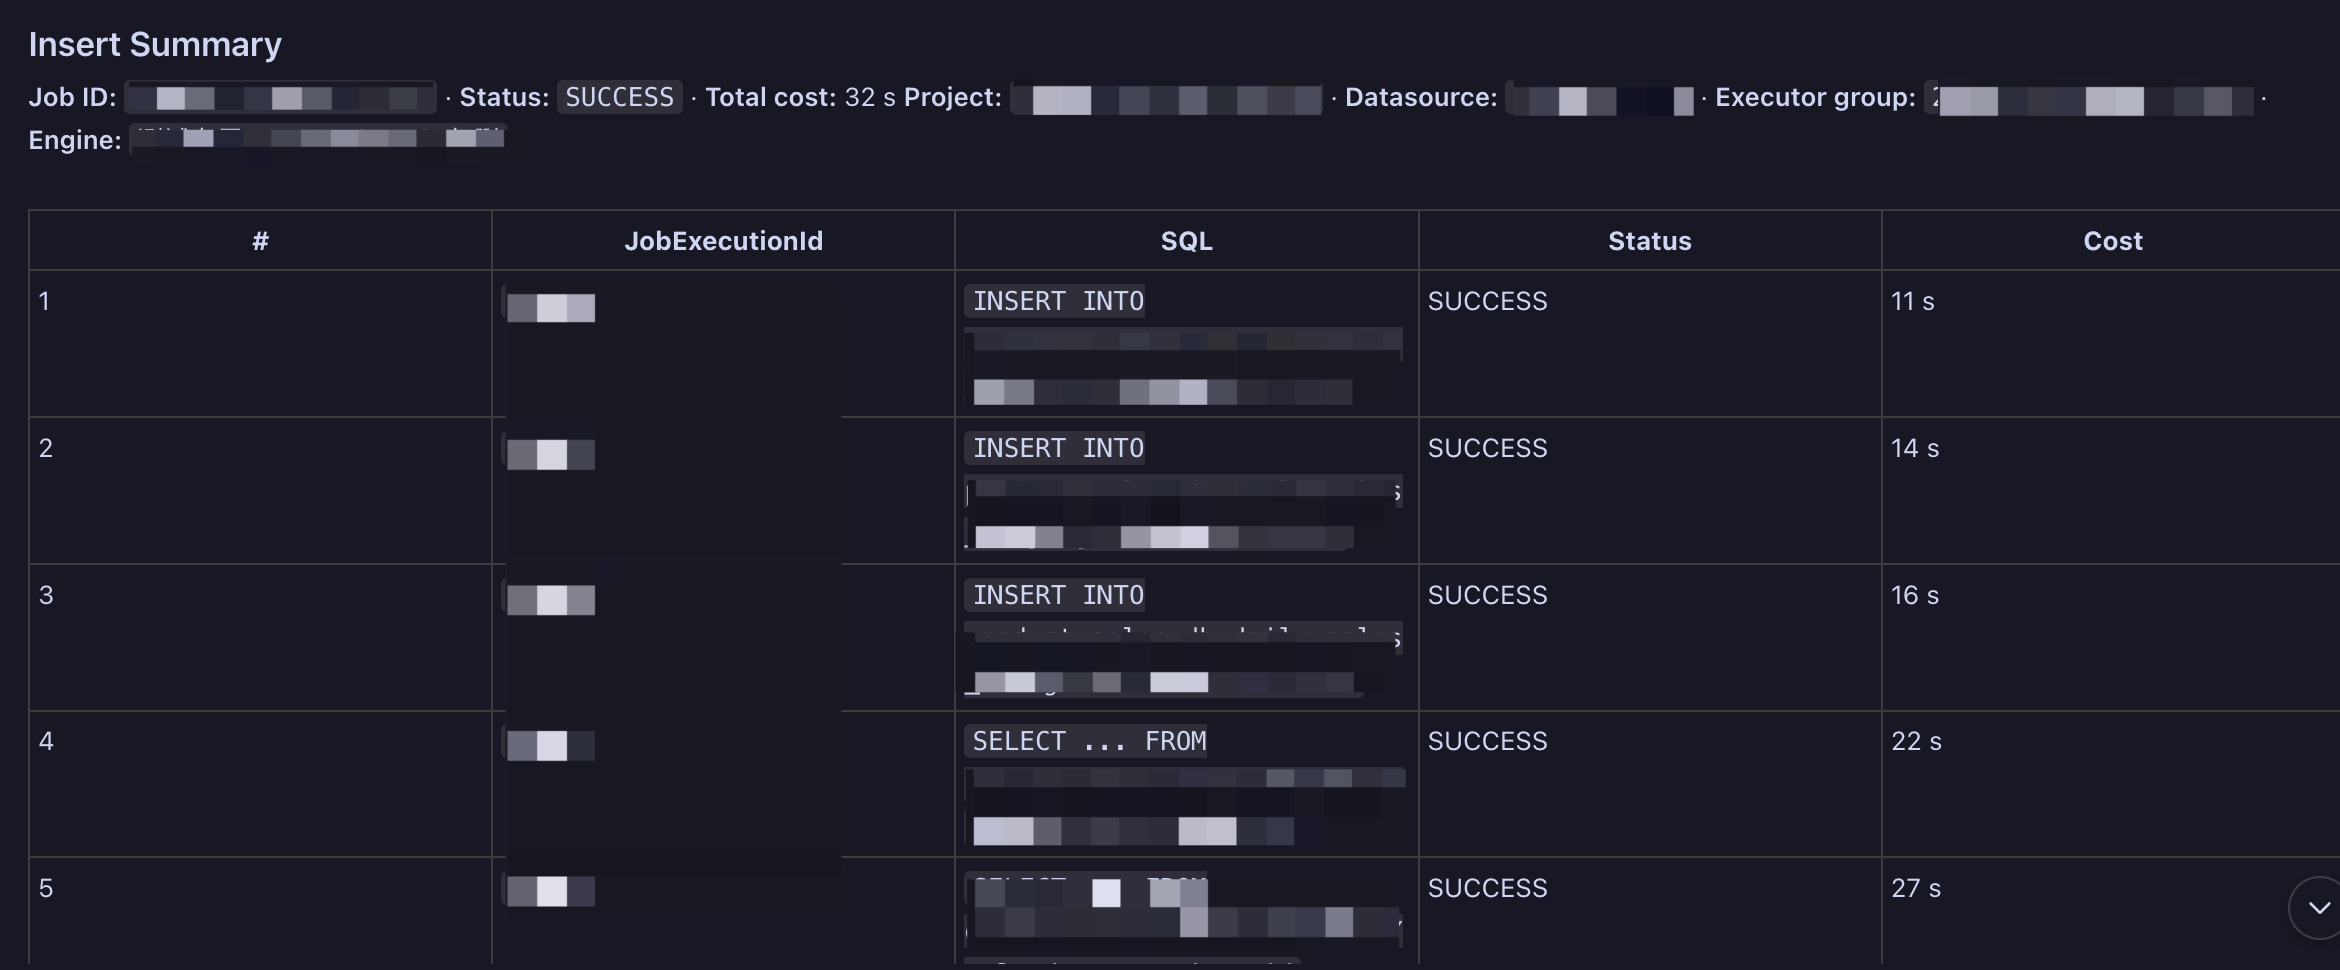
prompt:この3つのテーブルにそれぞれ数件のテストデータを挿入してください:
prompt:
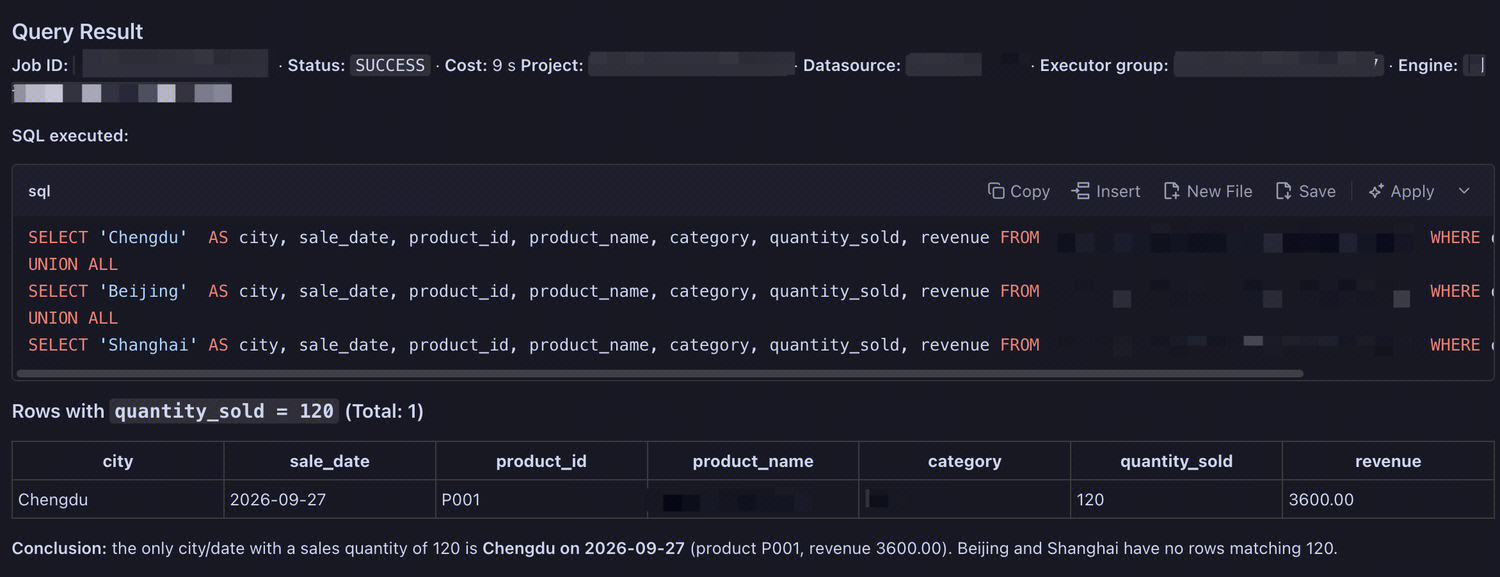
「プロジェクト名」プロジェクトの「データソース名」データソースで、「コンピューティングリソース名」コンピューティングリソースを使用し、
ExecutorGroupId「スケジュールリソースグループID」を使用して、商品販売データベースで各都市の1日あたりの販売数が1000を超えた具体的な日付を集計します。
6. 注意事項
1. SQLは非同期で実行されます:
execute_sqlは送信のみを担当し、JobIdを返します。送信後はpoll_sql_resultでポーリングし、ステータスがSUCCESS / FAILED / TERMINATED / CANCELEDになるまで繰り返します。2. 複数のステートメントは複数のサブ実行に分割されます:SQLを
;で区切る場合、各ステートメントが1つのサブ実行を生成します。poll_sql_resultでJobExecutionIdを渡さない場合は、すべてのサブ実行結果を順番に返します。渡した場合は、指定したサブ実行のみを返します。3. 結果には切り捨てと有効期限があります:プレビュー行数は「プロジェクト管理 - データ分析設定 - プレビュー行数制限」の制約を受け、総量は10MBを超えません。超えた場合は
Truncated=trueになります。結果は限られた時間のみ保持され、期限切れになるとResourceNotFound.ResultExpiredが返されるため、SQLを再実行する必要があります。4. 戻り値はすべて文字列です:プレビュー結果の基盤はCSVであり、型情報はありません。
5. パラメータは必ずセットで使用する必要があります:
DatasourceIdは渡されたProjectIdに属している必要があり、そうでない場合はInvalidParameterが報告されます。ExecutorGroupIdはそのプロジェクトで利用可能なScheduleタイプのリソースグループである必要があります(list_resource_groupsで照会できます)。6. 権限:このキーに対応するアカウントが権限を持つプロジェクト、データソース、テーブルにのみアクセスできます。特定のテーブルが表示されない場合は、通常、権限またはメタデータの可視範囲の問題です。まずデータマップ/データセキュリティ側で権限を確認してください。
7. 書き込み操作は慎重に行ってください:データベースやテーブルの作成、データの挿入は変更操作に該当します。モデルに実行予定のSQLを先に出力させ、問題がないことを確認してから実行することをお勧めします。
7. よくある問題のトラブルシューティング
現象 | 考えられる原因と対処 |
クライアント側に「接続中」または接続失敗が表示され続けます。 | URL、TENCENTCLOUD-REGIONがWeDataのリージョンと一致しているか確認してください。ネットワークがパブリックエンドポイントにアクセスできるか確認してください。timeoutを適宜大きくしてください。 |
ツールリストが空であるか、ツール数が明らかに少ない場合 | TOOL-SCOPEの値のスペルを確認してください。不明な場合は、先に該当Headerを削除して全量ロードしてください。 |
呼び出しで認証エラーが発生しました。 | キーが間違っている、無効になっている、またはWeDataへのアクセス権限がありません。キーを再生成して設定を更新してください。 |
execute_sqlでInvalidParameterが発生しました。 | DatasourceIdが該当ProjectIdに属していないか、またはExecutorGroupIdがそのプロジェクト配下のスケジューリングリソースグループではありません。 |
QUEUED/RUNNINGが継続的に返されます。 | 正常な現象です。ポーリングを継続してください。リソースグループのキューで待ち時間が長い場合は、より空いているリソースグループに切り替えることができます。 |
結果が空であるか、一部のデータのみが含まれています。 | 返却されたTruncatedフィールドを確認してください。または、子実行が多い場合はJobExecutionIdを指定して個別に確認してください。 |
結果の有効期限が切れたことが通知されます。 | 結果のretentionが既に期限切れです。SQLを再実行してください。 |
検索したいテーブルが見つかりません。 | アカウントが該当テーブルに対する権限を持っているか、およびプロジェクトでメタデータの可視範囲が設定されているかを確認してください。 |
フィードバック