モデルサービス
ダウンロード
フォーカスモード
フォントサイズ
モデルサービスの概要
モデルサービスは、MLOpsの全ライフサイクルを閉ループ化するための鍵です。モデル管理内のモデルをワンクリックでAPIサービスとして公開することにより、リアルタイム予測とオンライン推論をサポートし、充実したサービス監視と運用保守機能を提供します。また、モデルサービスはデータサイエンスの他の中核モジュールと深く統合されており、モデルをワンクリックで標準REST APIとして公開し、多次元のトラフィック監視、リソース監視、および実行ログの追跡機能を提供します。
機能操作ガイド
WeDataのモデルサービスは、新規サービス作成、サービス監視、サービスデバッグなどの機能を提供し、サービスをより効率的に管理し、本番環境での有効性を確保できます。
新しいモデルサービスの作成
モデルサービスを新規作成をクリックし、以下の情報を入力します:
サービスタイプ:機械学習サービス。
基本設定:サービス名、サービスバージョン、サービス名の説明。
モデルリソース:モデル、イメージリソースを選択します。
詳細設定:認証を有効にするかどうか、サービスログ配信を有効にするかどうか、COSストレージアドレスを設定します。
リソース設定:従量課金、CVMリソースグループを選択します。

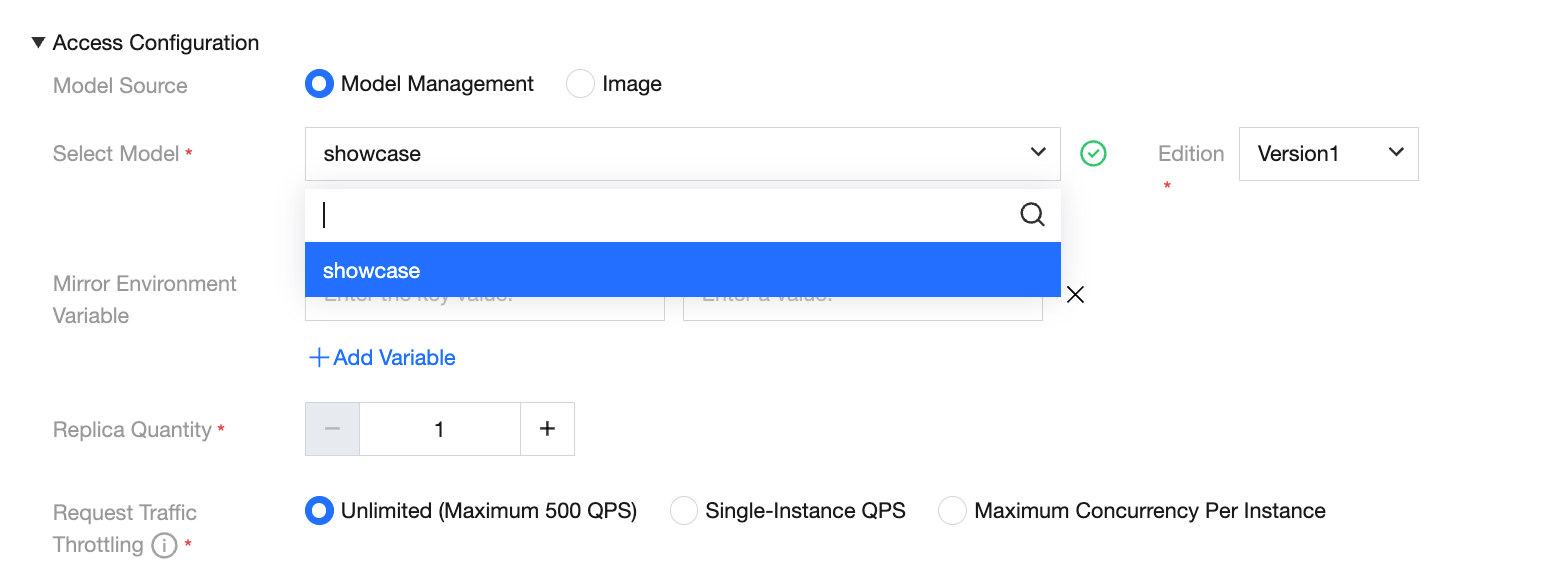
モデルソース - モデル管理
ローカル開発環境またはWeData Notebookでトレーニングが完了したモデルは、ユーザーがまずMLflowプラグインを通じてモデル管理モジュールに登録する必要があります。登録が成功すると、そのモデルはエンタープライズレベルの標準化されたモデル資産に変換され、モデルサービスモジュールから直接呼び出してワンクリックでオンラインAPIとして公開できます。
モデルソース - カスタムイメージ
WeDataは、ユーザーがカスタムイメージを使用してモデルサービスをデプロイし、環境の高度なカスタマイズと推論ロジックの深い統合を実現することをサポートします。詳細については、カスタムイメージを使用したオンラインサービス公開開発ガイドを参照してください。
コアバリュー:
環境の高度なカスタマイズ:非標準の機械学習フレームワークや特定バージョンのシステムライブラリを組み込むことができます。
前処理ロジック統合:イメージ内に「データ連結」または「特徴オンラインアクセス」のコードを直接パッケージ化し、「特徴 -> モデル -> 推論」のエンドツーエンドのクローズドループを実現できます。
コードマウントと柔軟な起動:カスタム起動コマンドを使用することで、イメージのデフォルト動作を上書きし、異なる推論エンジンを柔軟に起動できます。
インポート方法:
TCR Enterprise Edition:企業内部で管理されたイメージ資産管理に適しており、リージョンやインスタンスによるフィルタリングをサポートし、名前空間とリポジトリアドレスまで正確に指定できます。
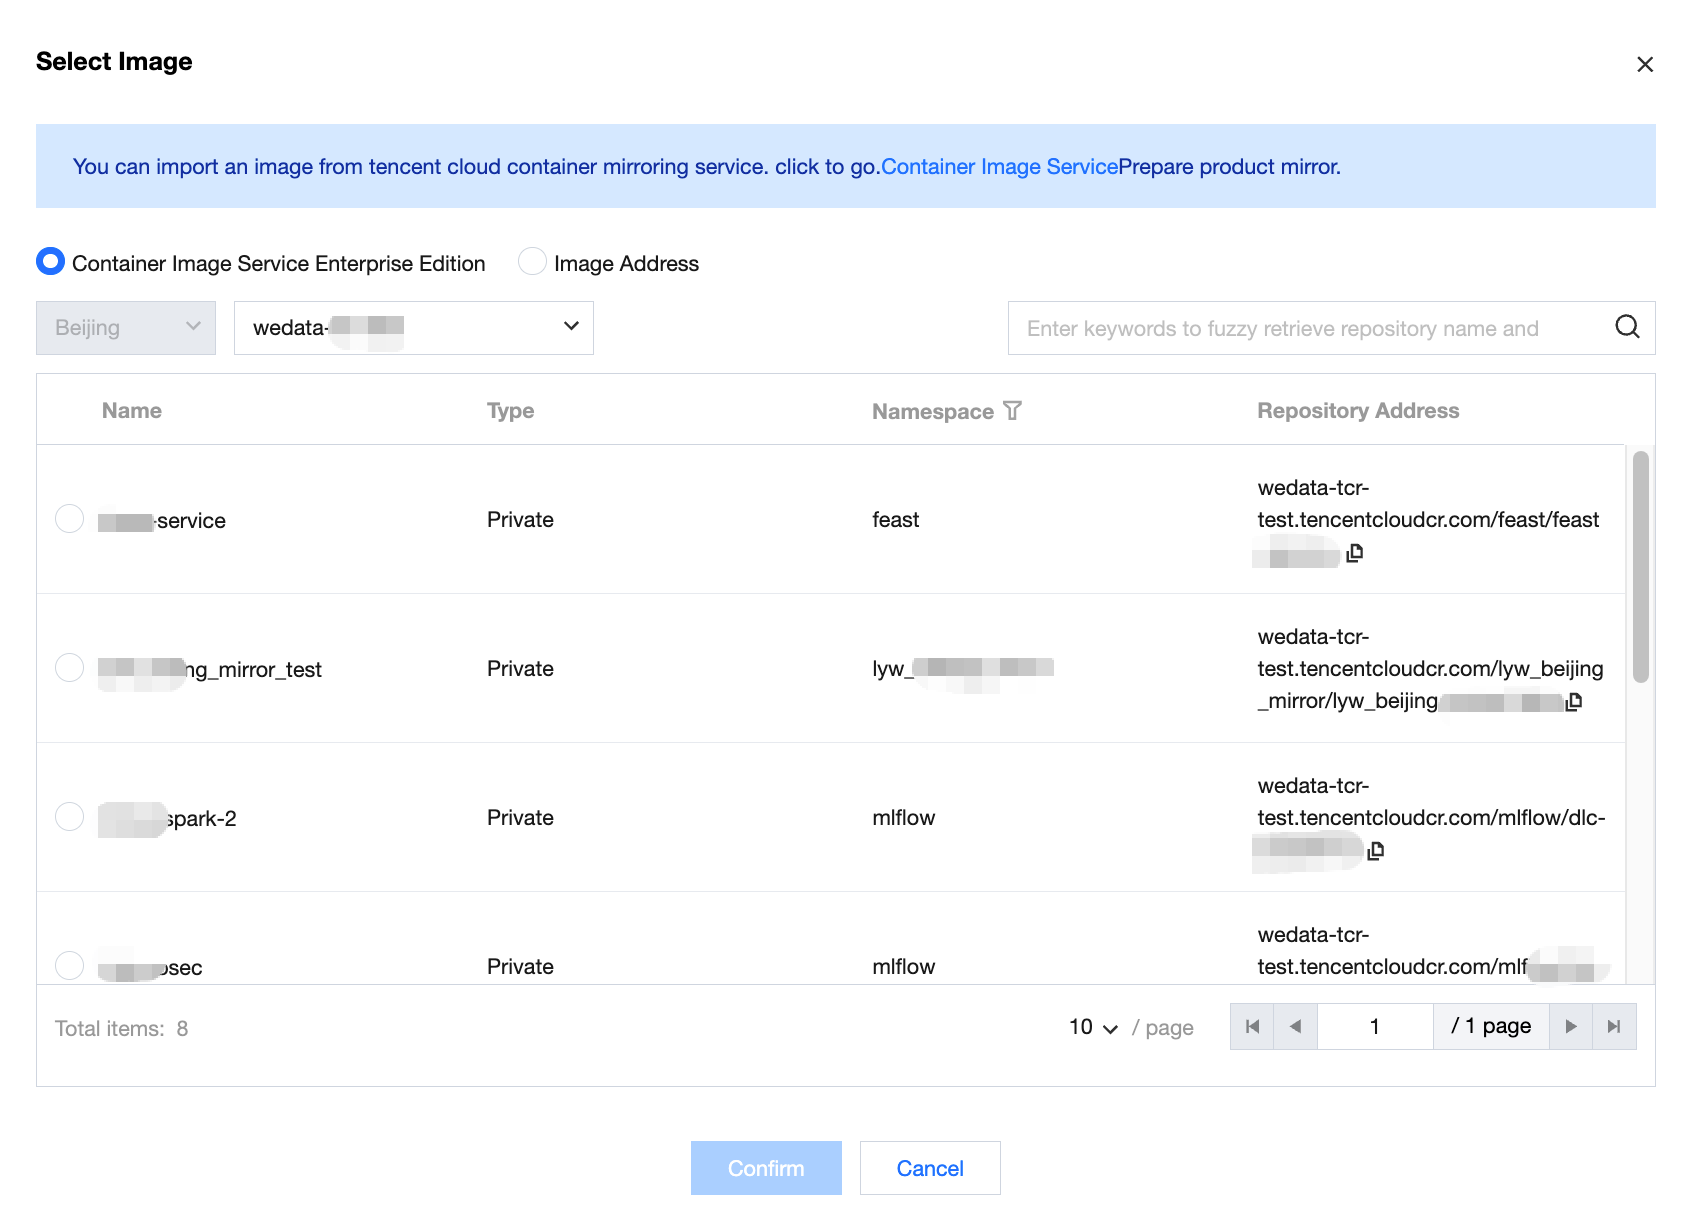
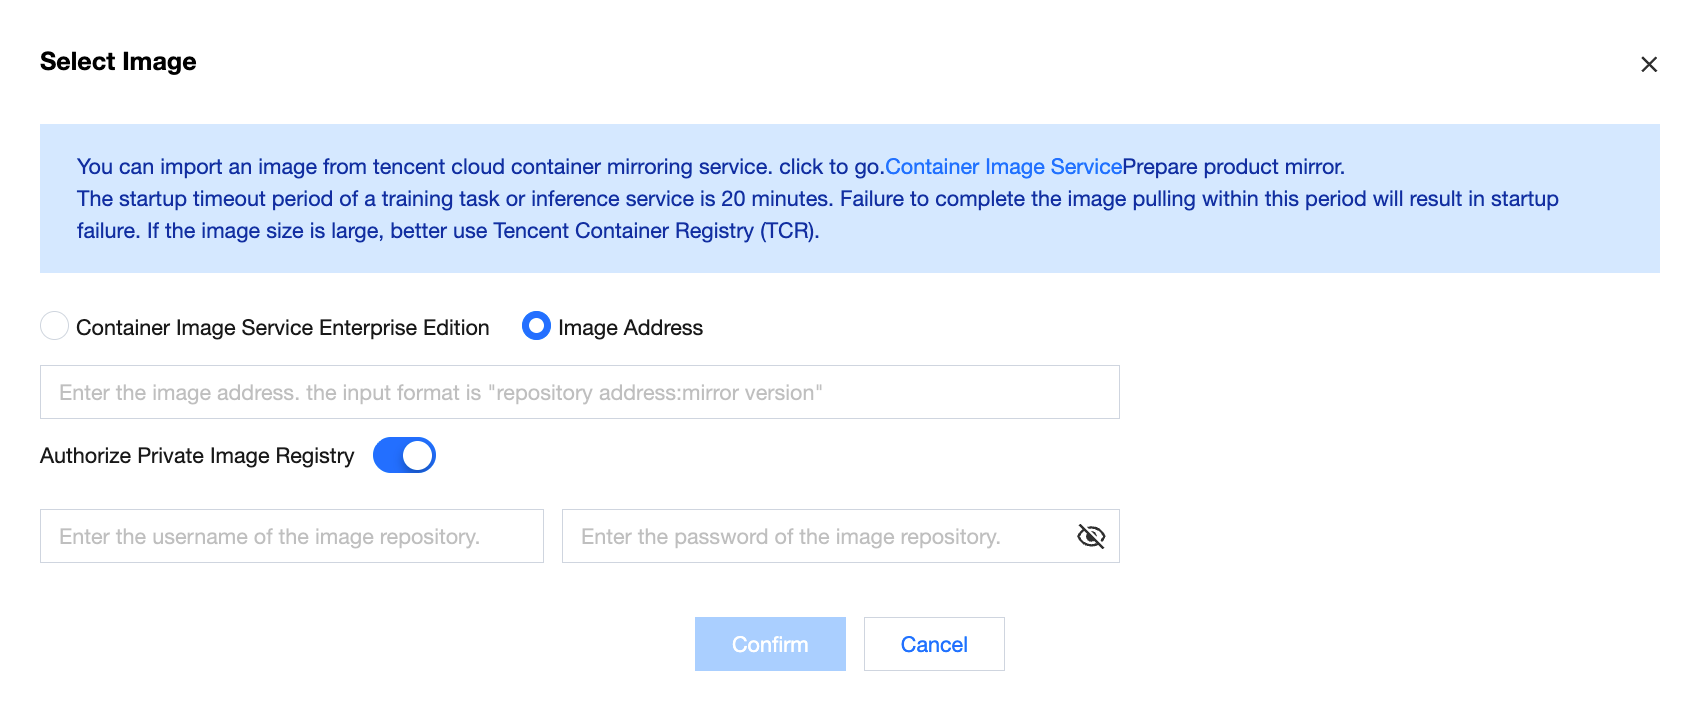
イメージアドレス:Tencent Cloud TCRからのイメージのインポートをサポートします。
説明:
承認済みプライベートイメージリポジトリの有効化をサポートします。デフォルトでは無効です。手動で有効にした後、イメージリポジトリのユーザー名とパスワードを入力できます。
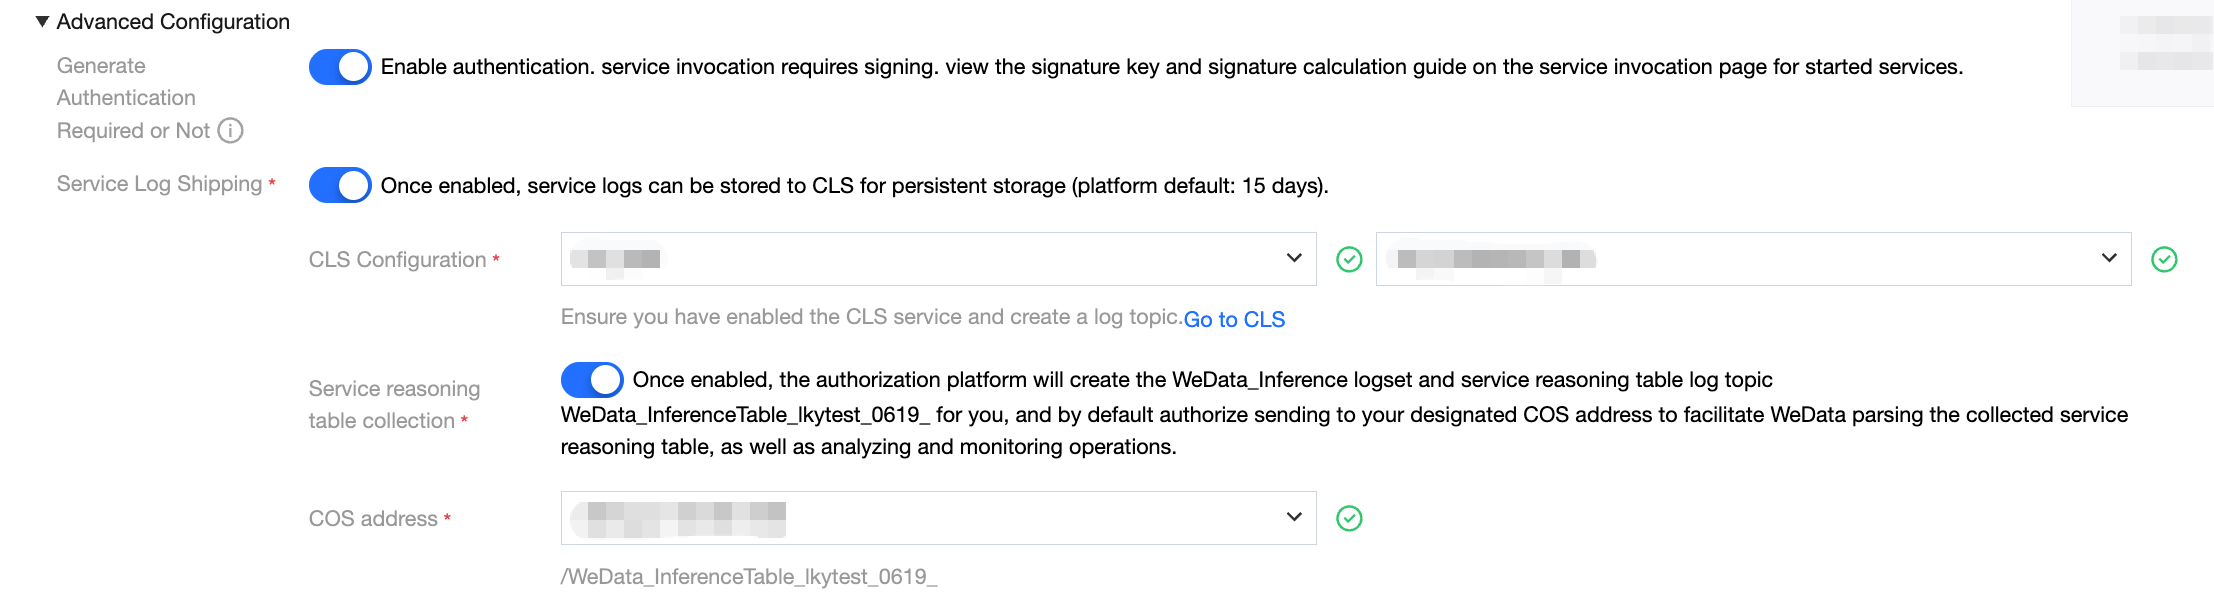
推論テーブル収集を有効にする(対応リージョン:北京、上海、重慶、国際-シンガポール)
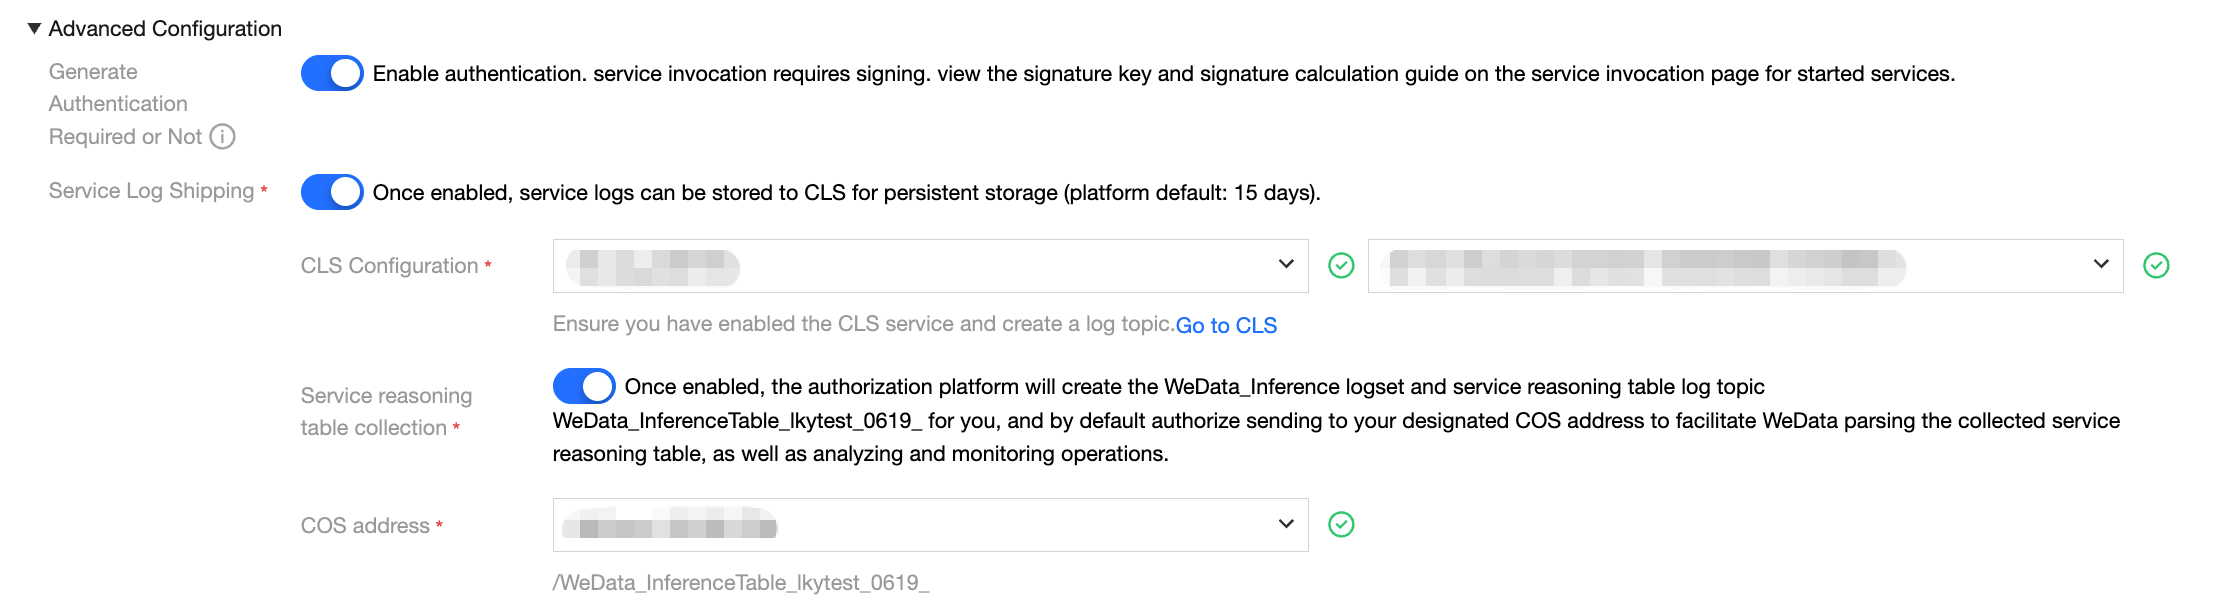
モデルサービスを作成する際に、詳細設定オプションから完全なログ収集を有効にできます:
サービスログ配信設定:まずサービスログ配信機能を有効にし、ターゲットログセットと対応するログトピックを指定する必要があります。設定が完了すると、モデルサービスによって生成されたすべてのリクエストログは、指定されたログトピックに自動的に配信されます。
推論テーブルログ収集設定:同時にサービス推論テーブルログ収集オプションを有効にし、適切なCOSストレージバケットをデータストレージターゲットとして選択します。この機能を有効にすると、システムは専用のログ加工タスクを自動的に作成します。このタスクは、収集された全量ログデータに対してフィルタリングと構造化処理を行い、事前に指定されたCOSストレージアドレスに配信します。
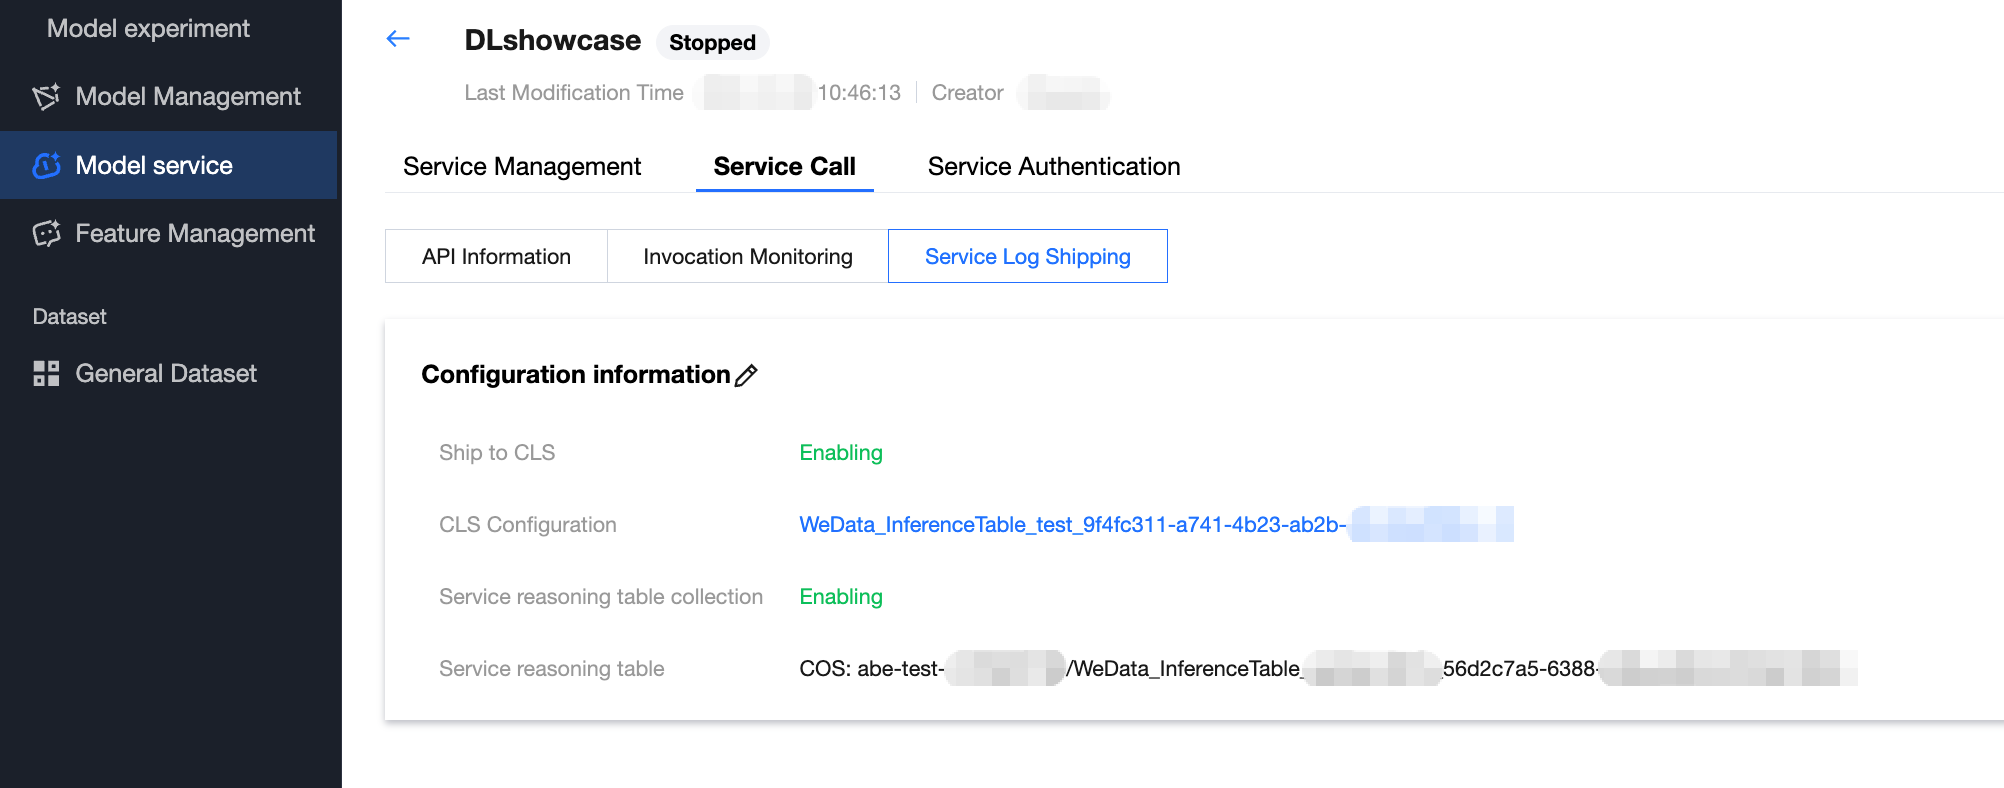
リソースソース - プラットフォーム従量課金
プラットフォーム従量課金は、WeDataが提供するマネージド型共有リソースプールです。ユーザーは基盤サーバーのメンテナンスを気にする必要がなく、必要に応じてコンピューティングスペックを申請するだけです。
操作ガイド:
「リソースソース」で「プラットフォーム従量課金リソース」を選択します。
「リソーススペックの選択」ドロップダウンリストで、モデルの複雑さに応じて対応するスペックを選択します。
使用シーン:
開発デバッグ:サービスを迅速に起動してロジックを検証します。
潮汐ビジネス:トラフィックの変動が激しく不定期であり、実際の使用時間に基づいて決済し、コストを最適化したいというニーズがあります。
軽量推論:モデルが小さく、物理マシン全体のリソースを占有する必要はありません。
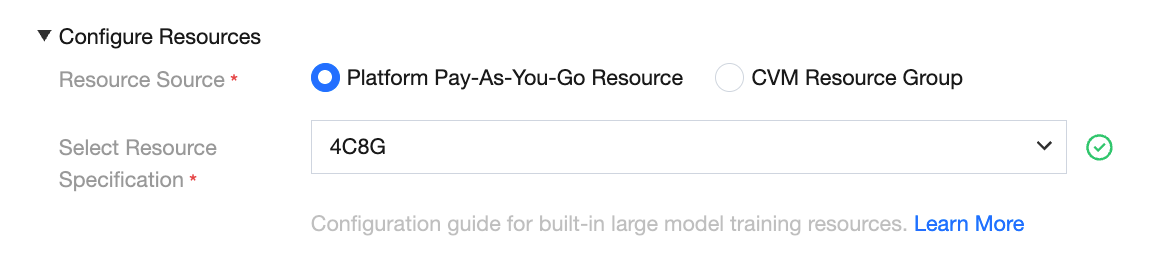
リソースソース - CVMリソースグループ
CVMリソースグループでは、ユーザーが自社購入のTencent Cloudサーバー(CVM)をWeDataにインポートしてプール管理を行い、コンピューティングリソースの物理的な分離を実現できます。
操作ガイド:
「リソースソース」で「CVMリソースグループ」を選択します。
ドロップダウンリストで作成済みかつバインド済みのリソースグループを選択します。
注意:
1つのリソースグループは1つのサービスにのみ関連付けることができ、リソースの完全な占有と安定性を確保します。
適用シーン:
コア生産業務:遅延に極めて敏感であり、共有環境における「騒がしい隣人」による干渉を回避する必要があります。
高並列推論:長期間にわたり高い$QPS$で稼働する場合、月額・年額プランのCVMを利用することでコスト面でより優位になります。
GPU専用タスク:特定モデルのGPUコンピューティングカード(T4、A100など)を指定して高性能な推論を実行する必要があります。
モデルサービスグループ一覧
ユーザーが新しいサービスを作成すると、サービスリストに作成済みのすべてのモデルサービスが表示されます。表示内容には、サービス名、サービスステータス、説明、作成者、作成時間、操作方法が含まれます。

フィールド分類 | | 説明 | 説明 |
サービス名 | | モデルサービスの一意の識別名です。 | 業務用途に応じた命名を推奨します。クリックしてサービス詳細ページへ移動できます。 |
サービス状態 | | サービス現在の実行ライフサイクル状態です。 | 一般的な状態には、草稿(起動中)、実行中、停止済みなどがあります。 |
サービスタイプ | | サービスが属するアプリケーション分野を識別します。 | 例:機械学習サービスです。 |
実行中バージョン/バージョン数 | | 現在アクティブなサービスバージョン/総バージョン数 | サービスグループのマルチバージョン管理状況を表示します。例えば0/1は、合計1バージョンが存在するが未起動であることを示します。 |
サービスグループの説明 | | このサービスグループに関する説明です。 | チーム間のコラボレーション時に、このサービスグループの用途をすばやく把握するのに役立ちます。 |
作成者 | | このサービスを作成したユーザーアカウントです。 | 監査および権限の追跡に使用されます。 |
作成時間 | | サービスが初めて作成された時間です。 | 時間順に並べ替えることができ、最近のサービスをすばやく見つけるのに役立ちます。 |
操作 | デバッグ | オンラインデバッグ画面に入り、モデルインターフェースをテストします。 | 標準化されたREST API呼び出しアドレスを提供します(サービスグループが実行状態である必要があります)。 |
| バージョン追加 | 同じサービスに新しいモデルバージョンをデプロイします。 | モデルのグレーリリースまたはA/Bテストのシナリオを実現し、最大2つのサービスバージョンをサポートします。 |
| 権限設定 | サービスの権限を設定します。 | 読み取り、書き込み、管理の権限を設定できます。(エンティティ権限管理モードを有効にした場合のみ有効です) |
| 削除 | モデルサービス資産およびその関連リソースを完全に削除します。 | 操作は元に戻せません。削除前に、このサービスグループが停止していることを確認してください。 |
サービスグループのオンラインデバッグ
サービス展開後、システムは標準化されたREST API情報を提供します:
インターフェース基本情報
標準サフィックスアドレス:すべてのサービスの呼び出しアドレスのサフィックスは統一して/predictに固定されます。
リクエスト方法:統一してPOST方式で呼び出します。
データ形式:リクエストとレスポンスはいずれもapplication/json形式を採用します。
入力仕様の説明
オンラインテストおよび実際の呼び出し時には、入力パラメータは特定のJSON構造に従う必要があります:
client_request_id:リクエストを一意に識別する文字列です。
dataframe_split:特徴データ本体を格納するために使用される固定キー名です。
columns:文字列リストであり、モデルトレーニング時に定義された特徴フィールド名を含みます(その内容は特定のモデルと強く関連します)。
data:ネストされたリスト構造です。内側のリストは1回の推論の特徴値を表します(columnsの順序に対応する必要があります)。内側に複数のリストを並列に配置することで、1回のリクエストで複数回の推論を実行できます。
オンラインデバッグリクエスト例
「赤ワイン品質予測」モデルを例にとると、その入力JSONの例は以下の通りです:
単一推論リクエストボディ:
{"client_request_id": "123456","dataframe_split": {"columns": ["fixed_acidity", "volatile_acidity", "citric_acid", "residual_sugar", "chlorides", "free_sulfur_dioxide", "total_sulfur_dioxide", "density", "pH", "sulphates", "alcohol"],"data": [[1, 0.8, 0.7, 0.5, 1, 1.5, 0.8, 0.7, 0.5, 0.8, 0.5]]}}
複数回推論(バッチ)リクエストボディ: 2組のデータを同時に予測する必要がある場合は、data配列に特徴値リストを追加するだけで可能です:
{"client_request_id": "123456","dataframe_split": {"columns": ["fixed_acidity", "volatile_acidity", "citric_acid", "residual_sugar", "chlorides", "free_sulfur_dioxide", "total_sulfur_dioxide", "density", "pH", "sulphates", "alcohol"],"data": [[1, 0.8, 0.7, 0.5, 1, 1.5, 0.8, 0.7, 0.5, 0.8, 0.5],[0.9, 0.7, 0.6, 0.4, 0.9, 1.2, 0.7, 0.6, 0.4, 0.7, 0.4]]}}
curlコマンドの呼び出し
curlコマンドを使用して入力します。呼び出しアドレス、認証情報(ある場合)、コンテンツタイプ、入力内容は以下の通りです:
curl -X POST https://[サービス呼び出しアドレス]/predict \\-H 'Authorization: [認証Token]' \\-H 'Content-Type: application/json' \\-d '{"client_request_id":"123456","dataframe_split":{"columns":["fixed_acidity","volatile_acidity","citric_acid","residual_sugar","chlorides","free_sulfur_dioxide","total_sulfur_dioxide","density","pH","sulphates","alcohol"],"data":[[1,0.8,0.7,0.5,1,1.5,0.8,0.7,0.5,0.8,0.5]]}}'
呼び出しデモ:
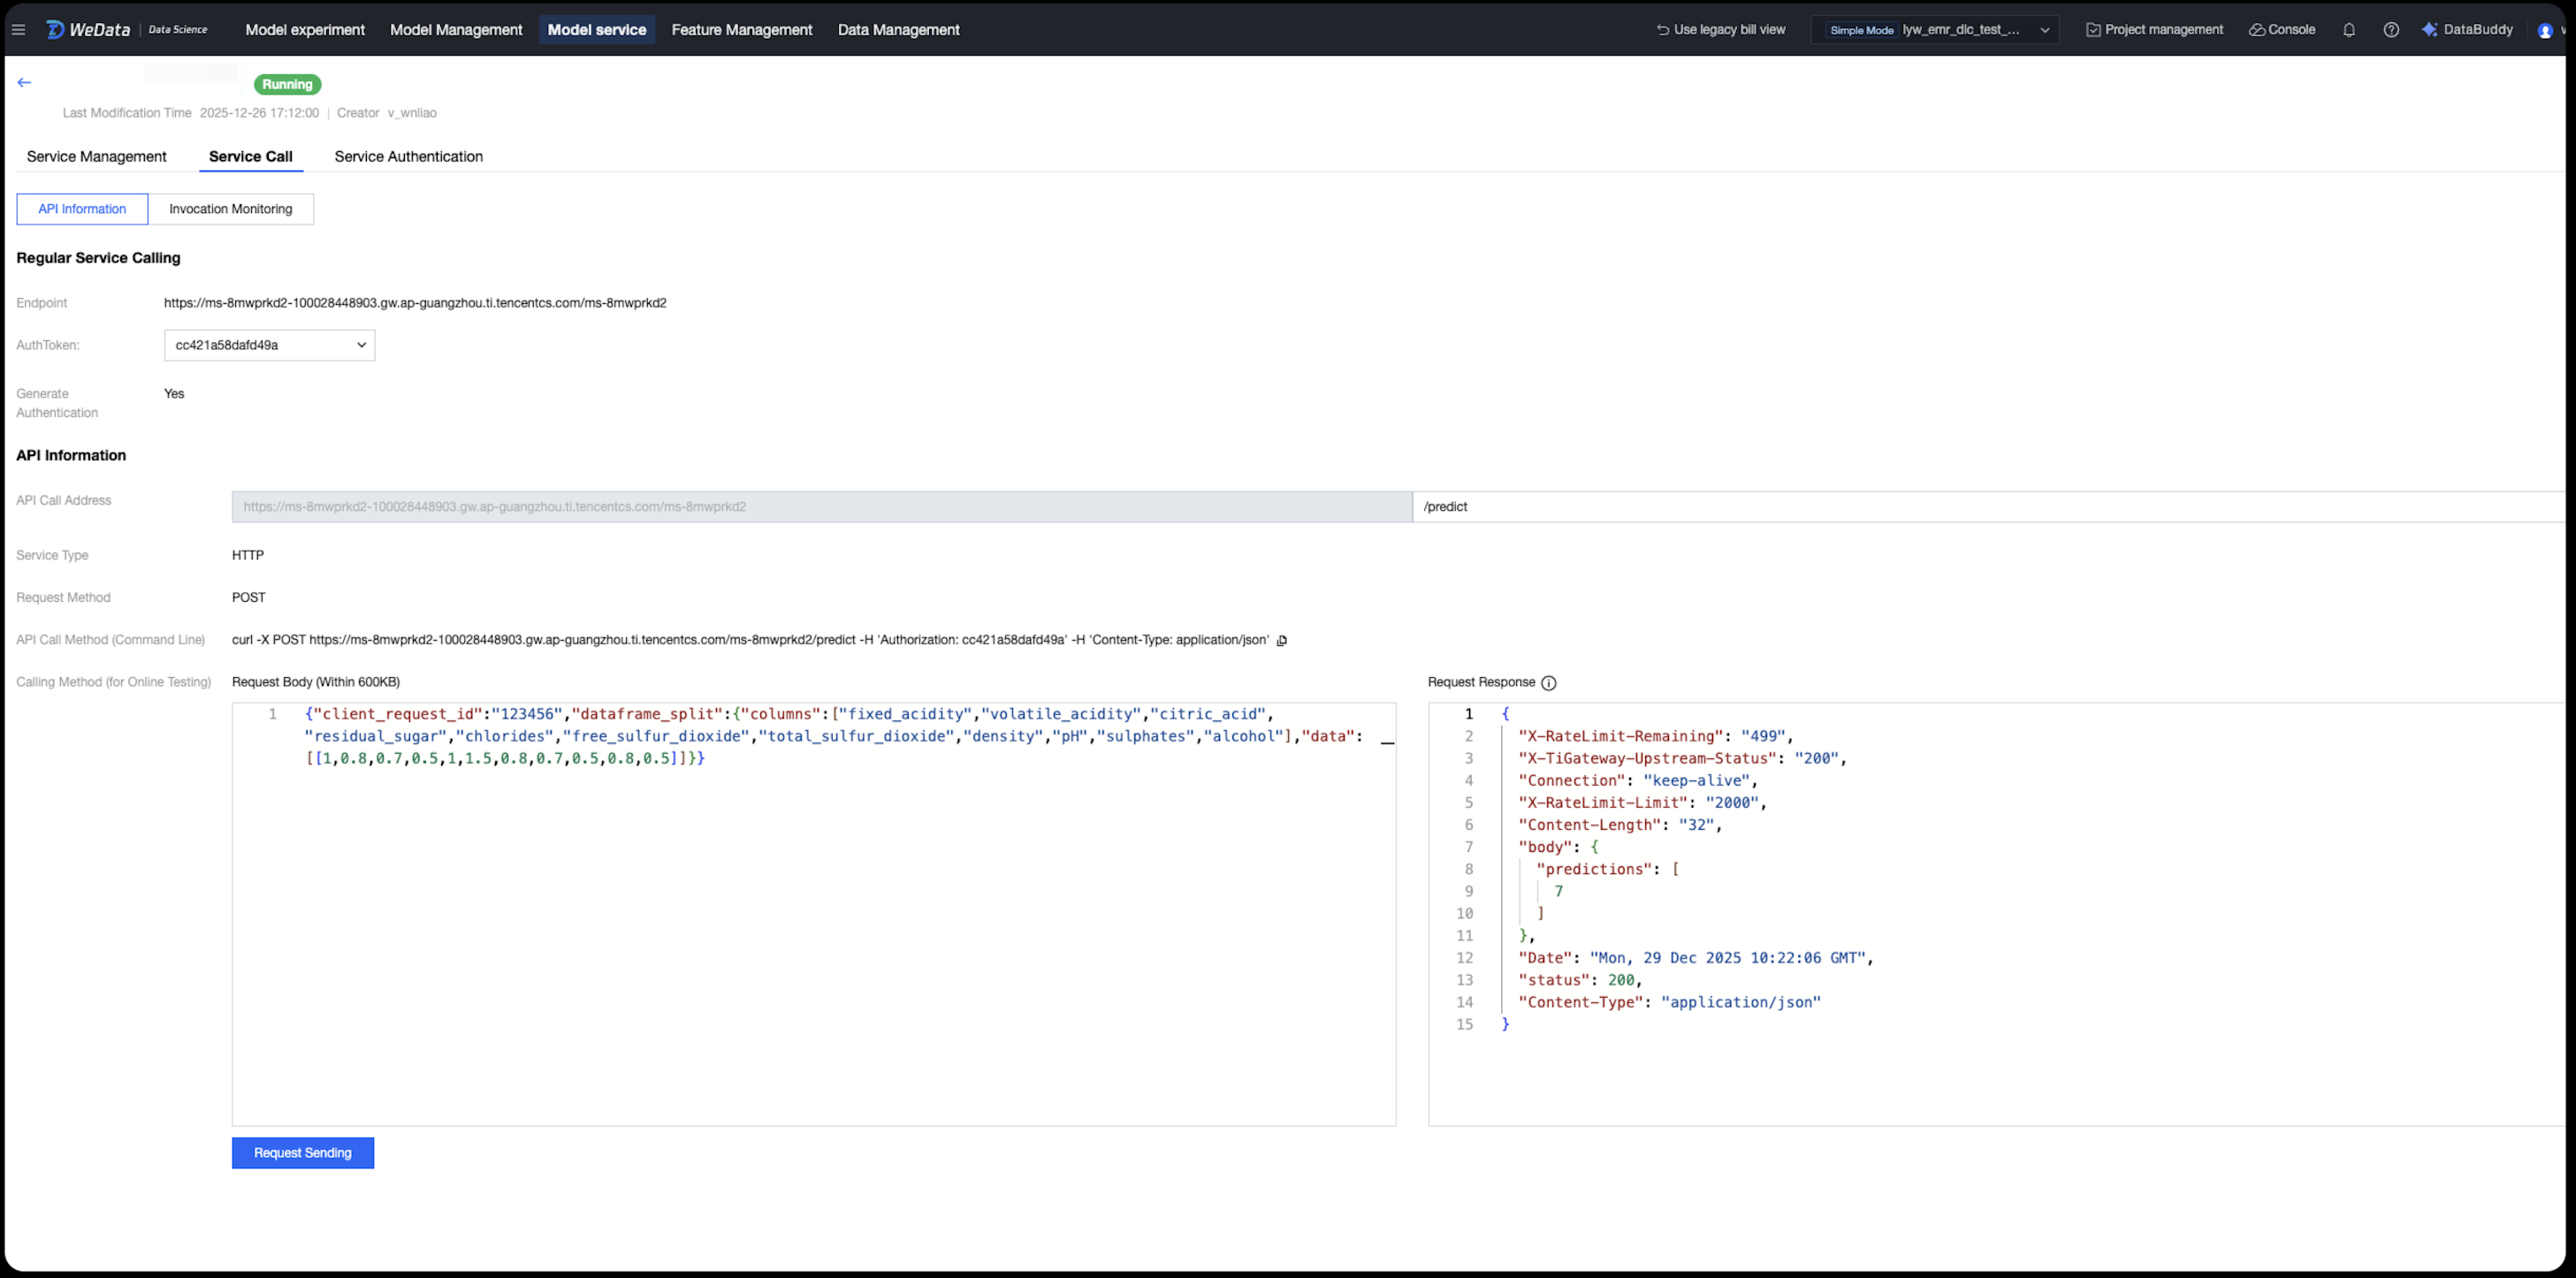
サービスグループのパフォーマンス監視と運用保守
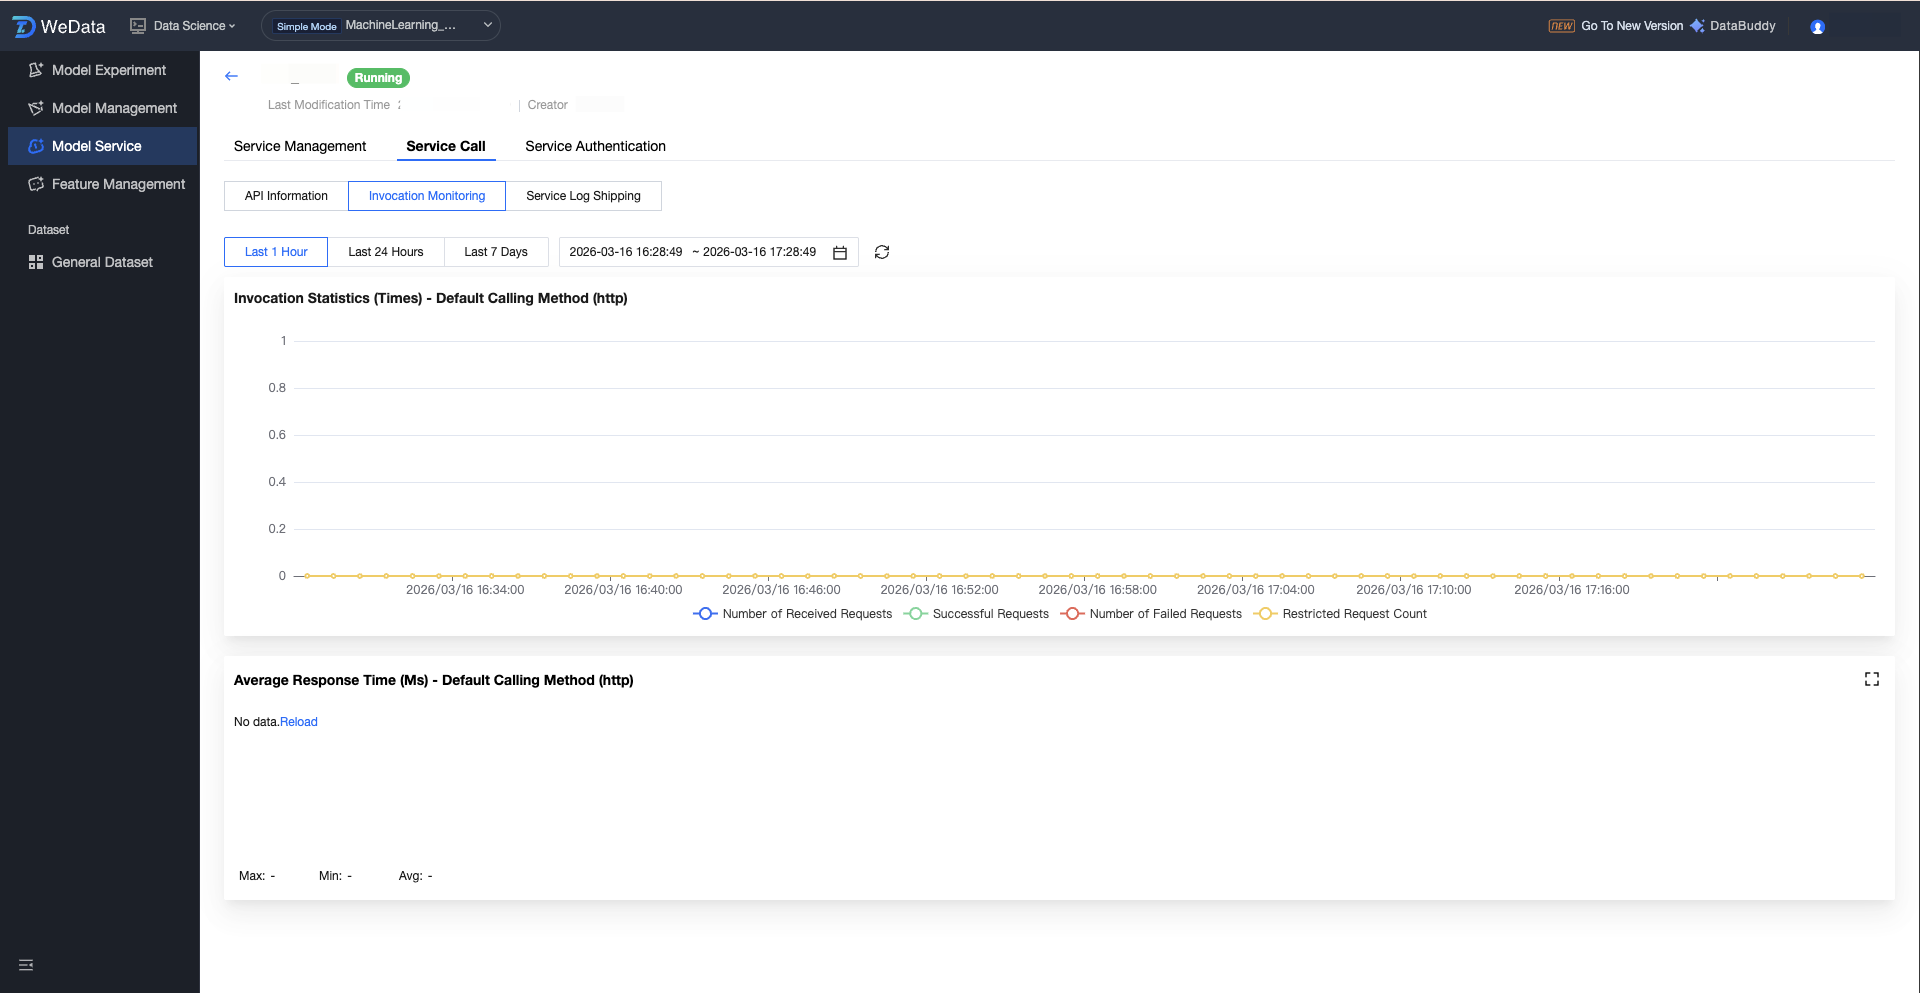
モデルサービスは多次元の監視ビューを提供し、監視情報(1時間、24時間、7日間、カスタム期間)の表示をサポートし、時間粒度(1分、5分)の調整もサポートします:
トラフィック監視:ネットワークトラフィック、QPS、QPS制限、同時リクエスト数。
リソース監視:CPU使用率、MEM使用率、ビデオメモリ使用率、GPU使用率。
インスタンス管理:インスタンス数、実行中インスタンス数。
サービスイベント:Podスケジューリング、イメージプルなどのシステムイベントを記録し、起動失敗のトラブルシューティングに役立ちます。
実行ログ:モデルコードが出力するログ情報のリアルタイム更新と検索をサポートします。
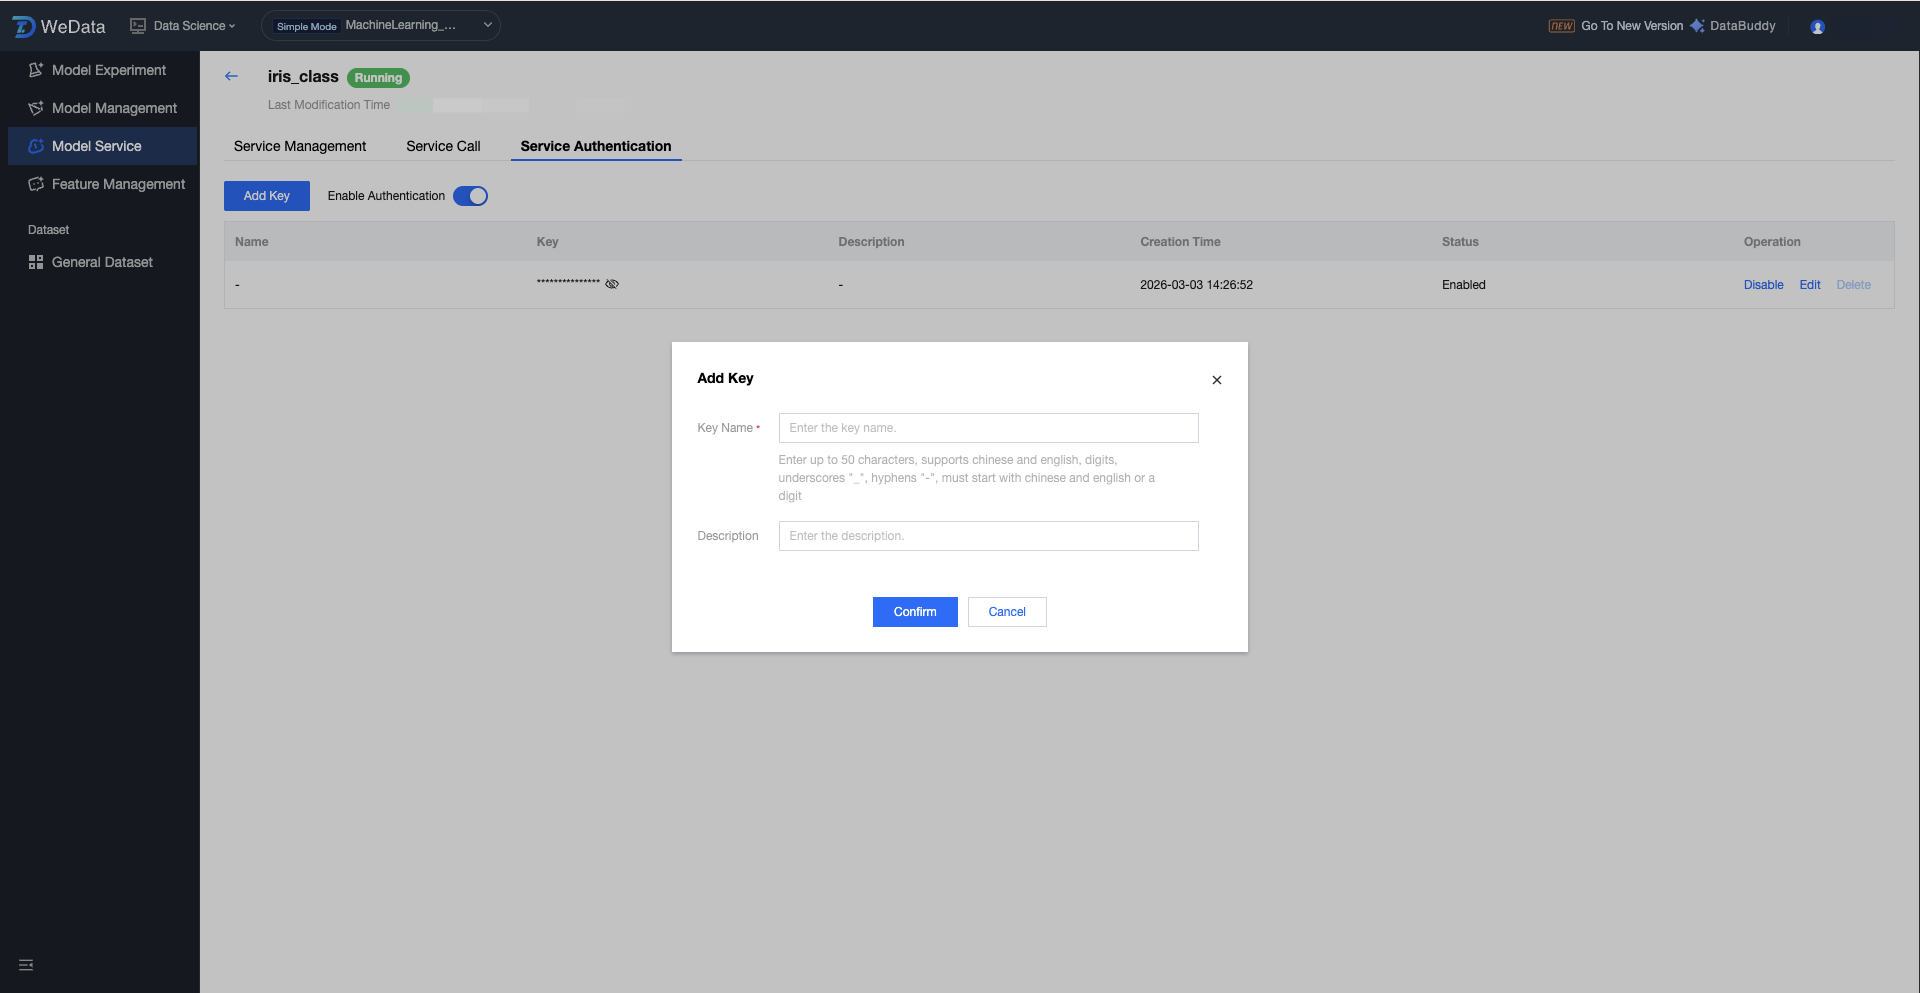
サービスグループの認証設定を有効にする
サービス認証は、モデルサービス呼び出しの安全を保障する中核的なメカニズムです。認証を有効にすると、システムはこのモデルサービスアクセスポイント(Endpoint)に入るすべてのリクエストに対して身元確認を行います。有効なキー(API Key)を持つリクエストのみがモデルへのアクセスを許可され、モデルインターフェースの不正呼び出しや悪意のある攻撃を防ぎます。サービスバージョン詳細ページで、「サービス認証」タブに切り替えると設定できます:
認証を有効にした後:すべてのREST APIリクエストはHeaderにキーを含める必要があります。
認証を無効にした後:インターフェースは公開状態となり、呼び出しアドレスを持つすべてのユーザーが直接アクセスできます。
サービスバージョン操作設定
サービスグループ名をクリックすると、サービスバージョンリストに入り、このサービスグループ配下のすべてのバージョン情報が表示されます:ID、サービス名、サービスバージョン、ステータス、説明、モデルソース、リソースソース、トラフィック割り当て、作成者、作成時間、更新時間、操作(更新/監視/ログ/起動/削除など)。

フィールド分類 | 説明 | 説明 | |
ID | | サービスバージョンインスタンスの一意の識別子です。 | システムによって自動生成される一意の文字列で、異なるサービスバージョンを正確に特定し区別するために使用されます。 |
サービス名 | | 当該サービスの具体的な名前です。 | マルチバージョン管理とグレーリリースを容易に行えます。 |
サービスバージョン | 当該サービス | 当該サービスのバージョン番号です。 | マルチバージョン管理とグレーリリースを容易に行えます。 |
ステータス | | サービスバージョンの現在の実行ライフサイクル状態です。 | このバージョンの実行状態を表示します:草稿/実行中/停止済みなど。 |
サービスの説明 | | 当該サービスバージョンの用途または特性について説明します。 | チームでのコラボレーション時に各サービスバージョンの違いを理解するのに役立ちます。 |
モデルソース | | 当該サービスに関連付けられた基盤モデルアセットを公開します。 | このサービスがモデル管理モジュール内のどの具体的なモデル名を使用しているかを表示します(例:ml_wine_db_wine_model)。 |
リソースソース | | 当該バージョンの実行に消費されるコンピューティングリソースのタイプです。 | リソースが「プラットフォーム従量課金リソース」または「CVMリソースグループ」のいずれから来ているかを識別します。 |
トラフィック割り当て | | マルチバージョンが併存する場合に、当該バージョンが受け取るトラフィックの重みです。 | A/Bテストまたはグレーリリースのシナリオにおいて、当該バージョンに割り当てられたトラフィックの割合を表示します。 |
作成者 | | 当該サービスバージョンを初期化したユーザーアカウントです。 | このバージョンの作成者を記録し、権限管理と操作監査に使用します。 |
作成時間 | | 当該サービスバージョンが初めて作成された時間です。 | システムが自動的に記録するため、時間軸に沿ってモデルの反復プロセスを追跡しやすくなります。 |
更新日時 | | 当該サービスバージョンが最後に更新された時間です。 | システムが自動的に記録するため、時間軸に沿ってモデルの反復プロセスを追跡しやすくなります。 |
操作 | 更新します。 | 現在のサービスバージョンの設定情報を変更します。 | サービスバージョンの詳細を表示し、サービスバージョンの説明、リソース設定などのパラメータを更新できます。 |
| 監視 | 当該バージョンのリアルタイムパフォーマンス指標を表示します。 | QPS、呼び出し遅延、CPU/GPU使用率などの可視化監視ビューにアクセスします。 |
| ログ | 当該サービスインスタンスの実行ログを検索します。 | モデルコードのエラー、入出力異常などの実行時問題を調査するために使用します。 |
| 起動/停止 | サービスインスタンスの実行状態を手動で制御します。 | 「起動」をクリックするとサービスグループが実行状態に変更され、「停止」をクリックするとサービスリソースが解放されます。 |
| 削除 | 当該サービスバージョンを完全に削除します。 | 操作は元に戻せません。削除前に、このバージョンが停止していることを確認してください。 |
サービスバージョン詳細
サービスバージョン詳細ページは、この特定バージョンのモデルサービスの包括的なビューを提供し、基本構成、接続パラメータから基盤となるコンテナインスタンスの実行状態までを網羅します。ユーザーはこのページを通じて、サービスのライフサイクル管理(起動/停止)、リアルタイム監視の確認、および基盤問題の詳細な調査を行うことができます。
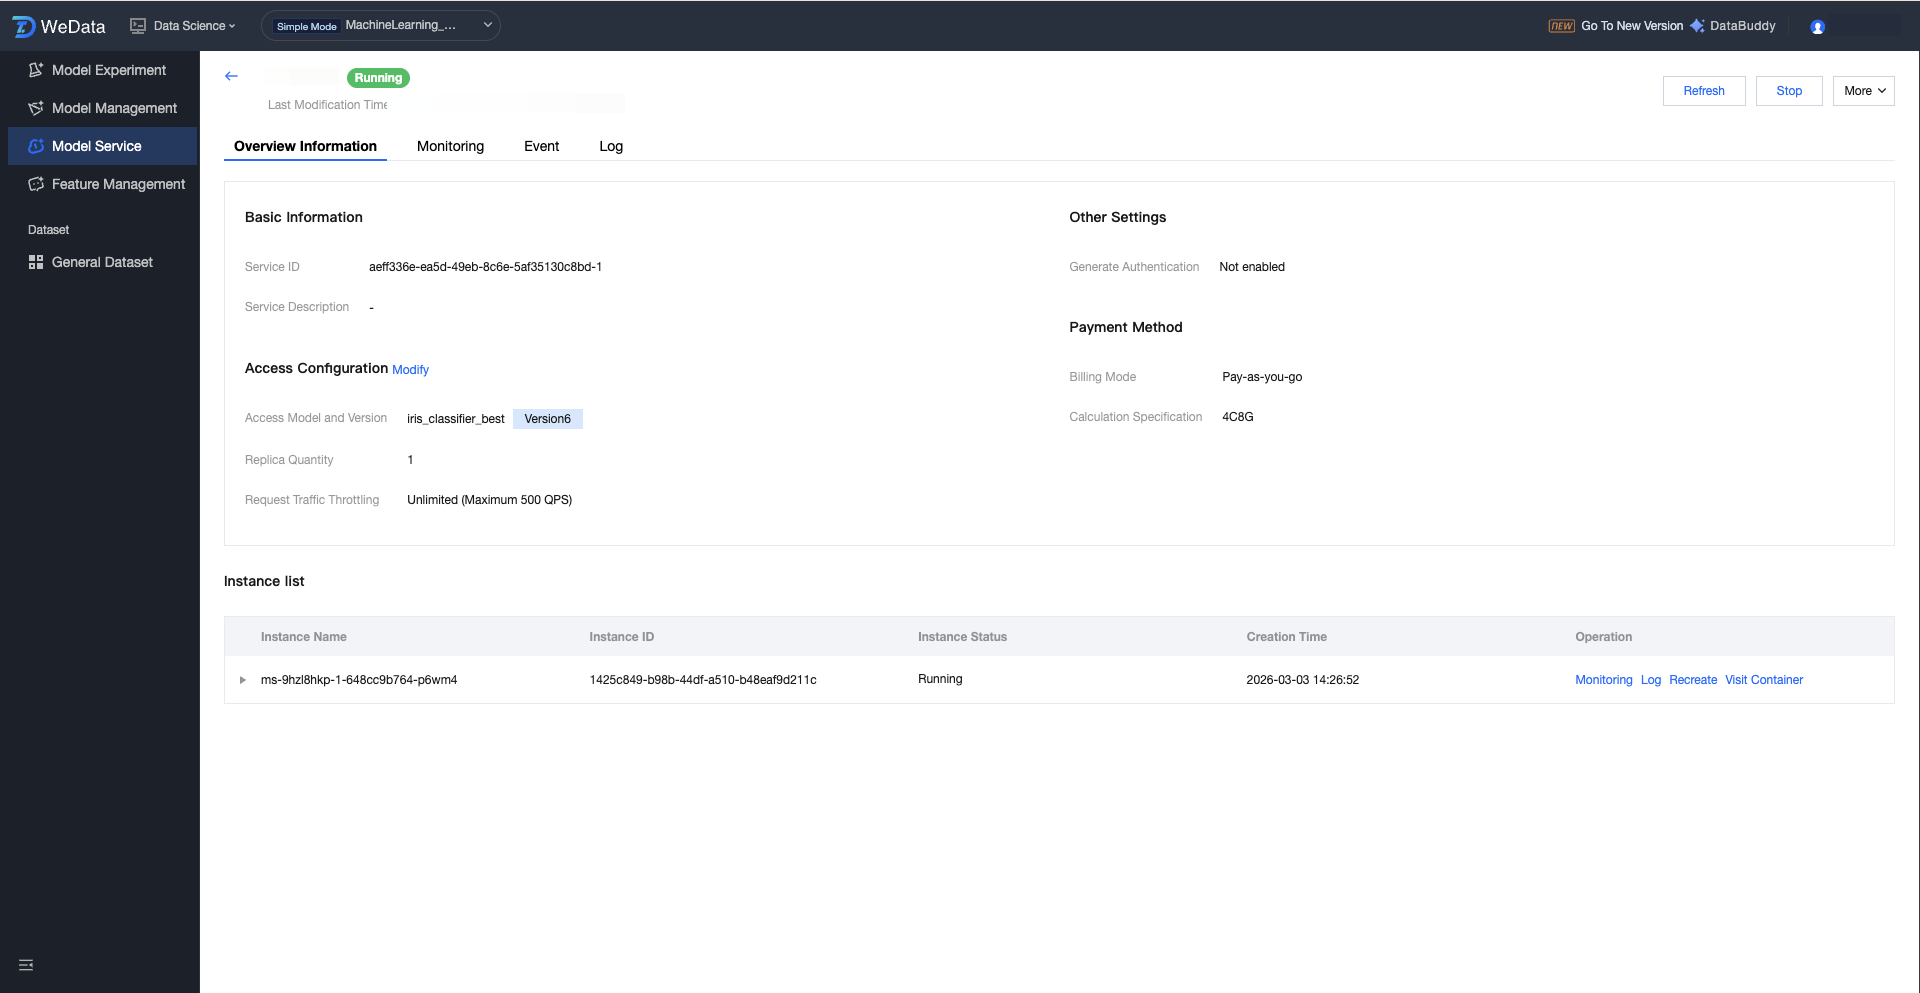
サービスバージョン詳細:
フィールド名称 | 説明 | 説明 |
サービス名 | 当該サービスの具体的なバージョン識別子です。 | マルチバージョン管理とグレーリリースを容易に行えます。 |
サービスID | サービスバージョンインスタンスの一意の識別子です。 | システムによって自動生成される一意の文字列で、異なるサービスバージョンを正確に特定し区別するために使用されます。 |
サービスの説明 | 当該サービスバージョンの用途または特性について説明します。 | チームでのコラボレーション時に各サービスバージョンの違いを理解するのに役立ちます。 |
課金モデル | リソースの課金方式 | 例えばPay-as-you-go(従量課金)は、モデル実行のコスト構造を示しています。 |
リソース仕様 | 当該バージョンに割り当てられるコンピューティングリソースのサイズです。 | 例えば4C8Gの場合、このバージョンが対応できるモデルの複雑さと同時実行数の上限を決定します。 |
接続モデルとバージョン | 関連するモデルアセットの詳細です。 | モデル管理内のモデル名と具体的なMLflowバージョン番号(例:Version2)を表示します。 |
レプリカ数 | 実行中のコンテナインスタンスの総数です。 | サービスの高可用性を決定します。複数のレプリカはトラフィックを分散し、災害復旧保護を提供できます。 |
リクエスト制限 | トラフィック保護のしきい値です。 | $QPS$の上限を表示します。しきい値に達した場合、システムはパケット破棄またはキューイング保護をトリガーします。 |
認証生成 | サービスセキュリティ制御スイッチです。 | 署名認証(API Key)が有効かどうかを表示します。無効の場合、アドレスに直接アクセスできます。 |
実行インスタンス詳細:
フィールド/操作 | 説明 | 運用保守ガイド |
インスタンス名称 | 基盤となるコンピューティングユニット(Pod)の識別子。 | 実行中のマイクロサービスノードを一意に識別します。 |
インスタンスの状態 | インスタンスの物理的な状態。 | Waitingはイメージのプル中またはスケジュール待ちを示します。Runningはサービスが準備完了であることを示します。 |
再起動回数 | コンテナが異常終了する頻度。 | コアとなる障害切り分け指標です。回数が継続的に増加する場合、モデルにメモリリークまたはコードエラーが存在する可能性を示します。 |
監視 | インスタンスレベルの監視入口です。 | 単一インスタンスの$CPU/MEM$消費量を確認し、リソースの偏りが存在するかどうかを判断します。 |
ログ | コンテナの標準出力ストリーム。 | モデル読み込みロジック、予測エラースタックを確認するための最も直接的な手段です。 |
再起動 | インスタンスを強制的に再起動します。 | インスタンスがハングしたり応答が極端に遅くなった場合に、サービスを迅速に復旧させるための緊急手段です。 |
コンテナにアクセス | 対話型ターミナル。 | コンテナ内部に入ってコマンドを実行し、ファイルパス、権限、または環境依存関係を確認することを許可します。 |
サービスバージョン監視
監視ページは、モデルサービスの実行状態をリアルタイムに把握する機能を提供し、ビジネストラフィック、システムリソース、基盤インスタンスの3つの次元からサービスのパフォーマンスを追跡します。可視化チャートを通じて、アルゴリズムエンジニアと運用保守担当者がパフォーマンスのボトルネックを迅速に特定し、スケールアウト/スケールインの効果を検証し、モデルの応答品質を評価するのを支援します。
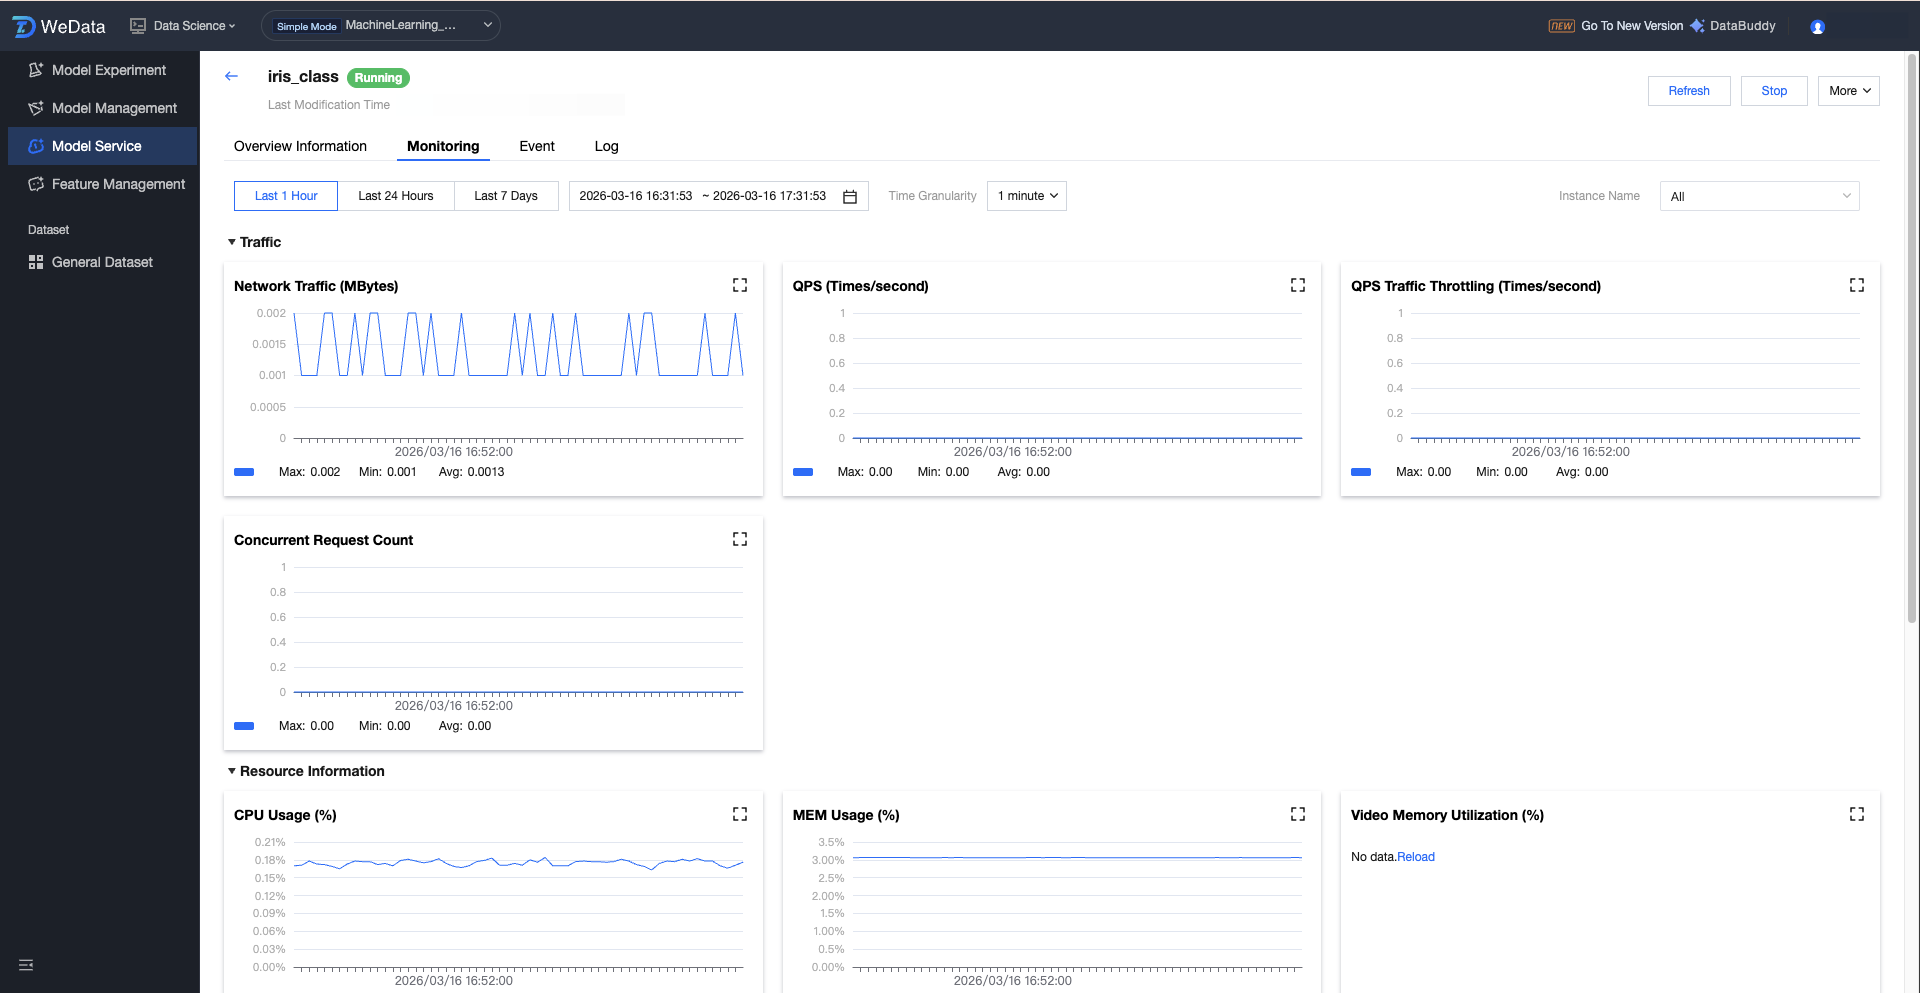
指標分類 | 主要指標項目 | ビジネス価値の説明 |
トラフィック情報 | ネットワークトラフィック、QPS、QPS制限回数、同時リクエスト数 | API呼び出しの負荷を評価します。同時リクエスト数とレート制限回数は、レプリカ数を増やす必要があるかどうかを判断するための重要なシグナルです。 |
リソース情報 | CPU使用率、MEM使用率、ビデオメモリ使用率、GPU使用率 | 基盤となるハードウェアの負荷を監視します。これにはビデオメモリ使用率とGPU使用率が含まれます。 |
インスタンス情報 | インスタンス総数、実行中のインスタンス数 | サービスの可用性を直感的に表示し、実際に稼働しているコンテナ数が設定の期待値と一致しているかどうかを確認します。 |
サービスバージョンのイベントとログ
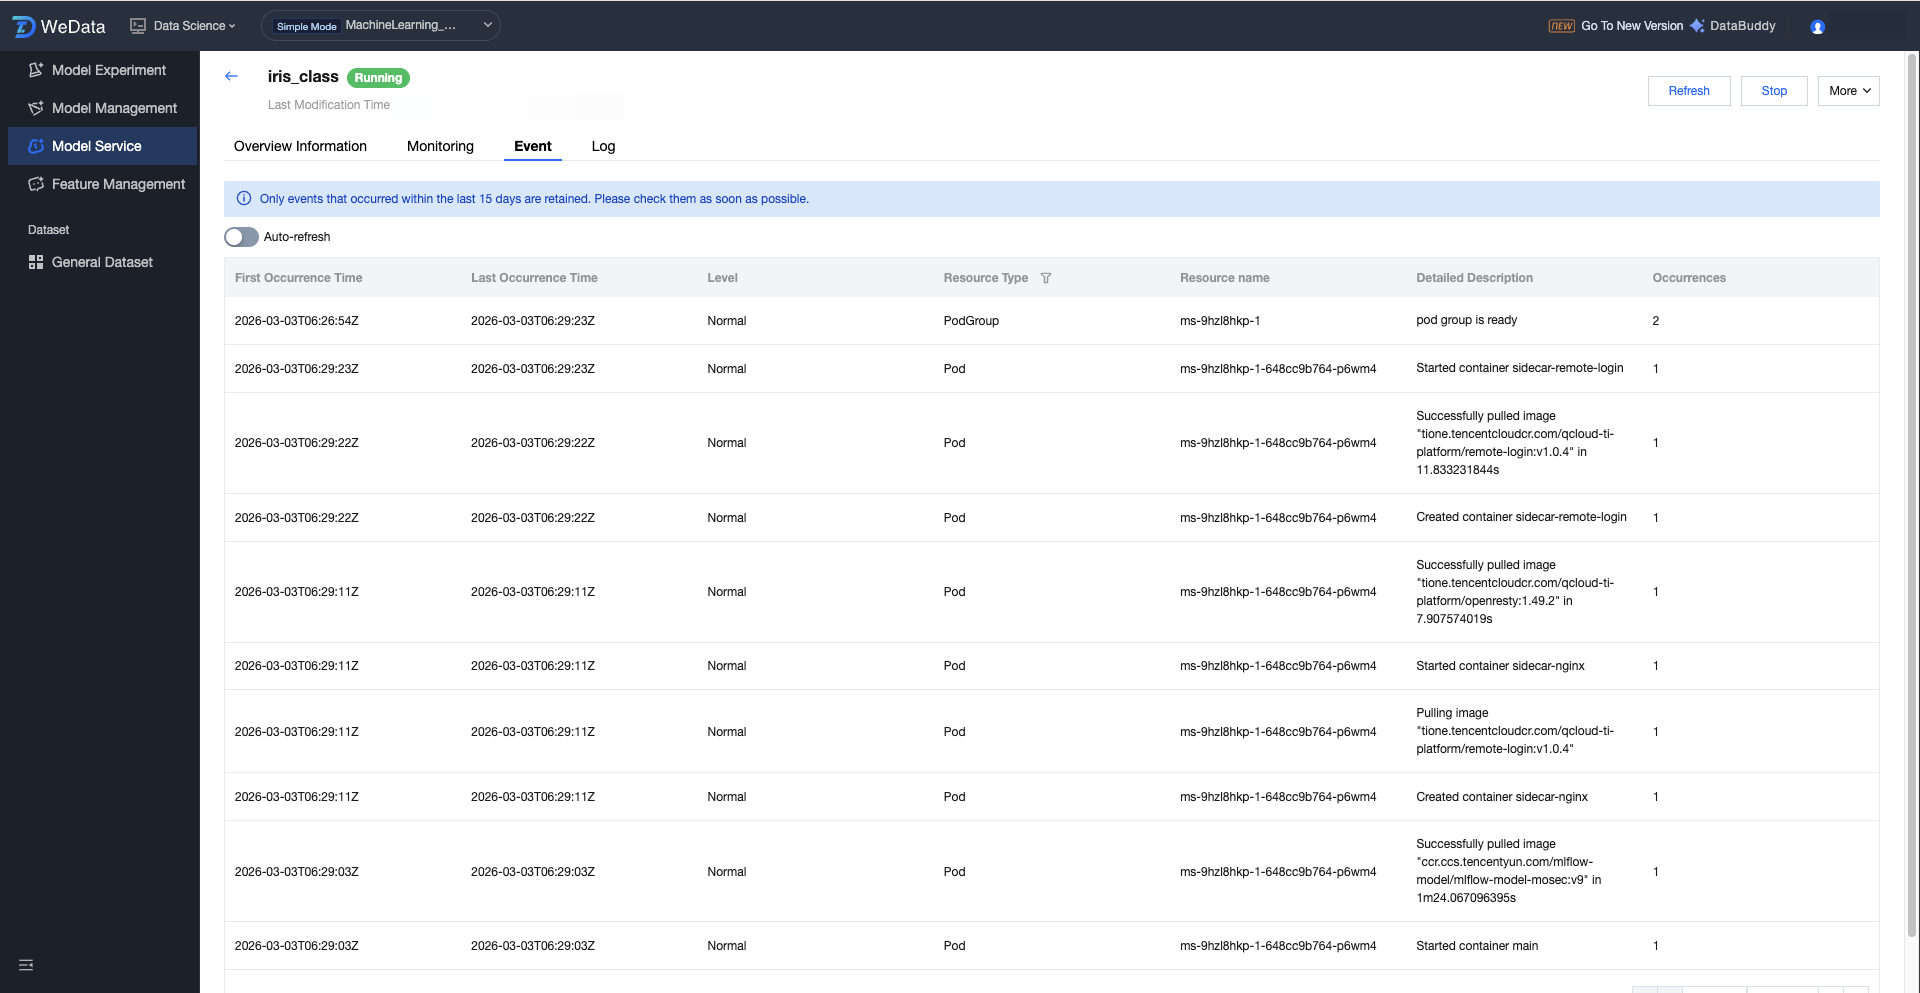
サービス実行イベント:
サービス実行中のイベントの表示をサポートし、初回発生時間、最終発生イベント、レベル、リソースタイプ、リソース名、詳細説明、発生回数などの情報が含まれます。
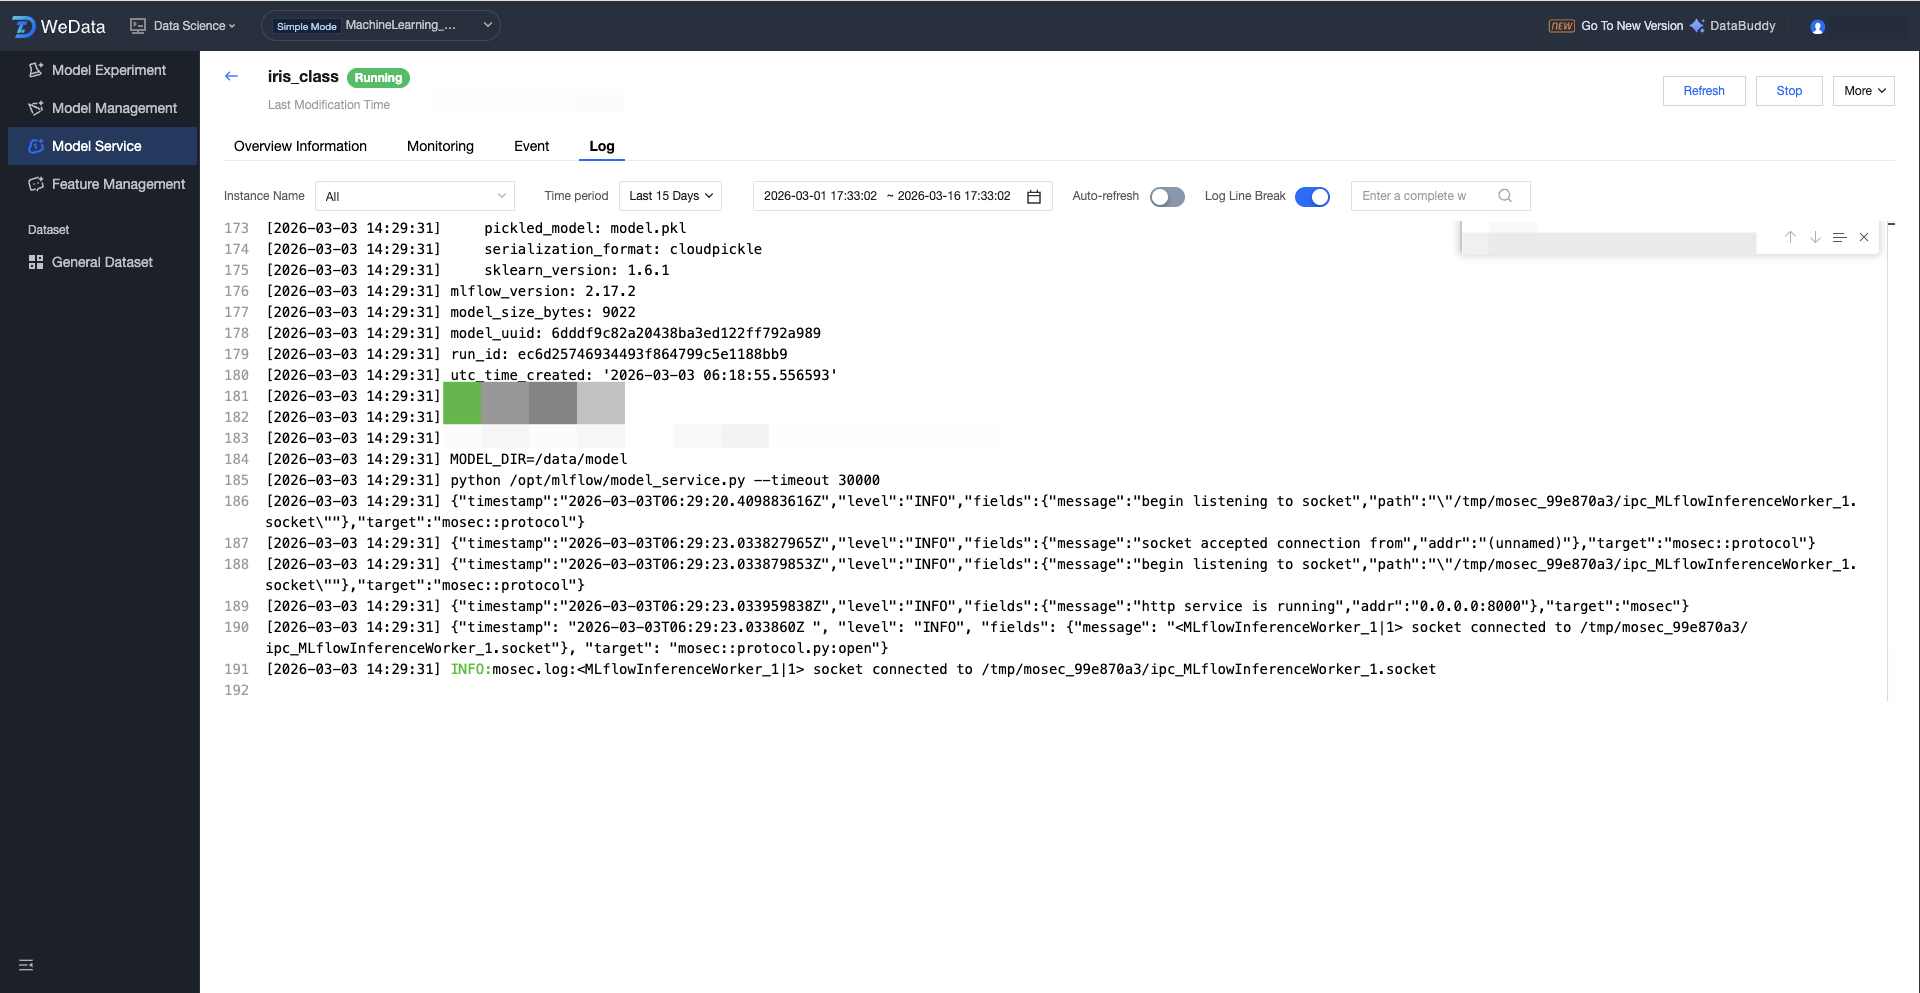
サービス実行ログ:
サービスログの表示をサポートし、インスタンス、時間範囲(1時間、24時間、7日間、15日間、カスタム期間)によるフィルタリング、自動更新、検索、ログの折り返しなどをサポートします。
付録
モデル監視のベストプラクティス
推論テーブルとは何ですか?
推論テーブルは、機械学習モデルの品質監視における重要なツールであり、運用保守チームがオンラインモデルの実行状態とパフォーマンスをリアルタイムに把握するのを支援します。図に示す典型的なワークフローでは、モデルサービスで推論テーブル監視機能を有効にすると、システムはモデル推論プロセスにおける入力特徴データ、モデル出力結果、推論時間などの重要な指標を自動的に取得し記録します。
これらの記録データはリアルタイムで推論テーブルに書き込まれ、後続の品質分析にデータ基盤を提供します。データ品質監視モジュールと連携することで、推論テーブル内のデータに対してデータ分布変化の検出、モデル予測精度の監視、異常値の識別など、多次元の品質チェックを実行できます。監視システムがモデル品質の低下傾向や異常状況を検出した場合、直ちにアラートメカニズムをトリガーし、モデルパラメータの調整、トレーニングデータセットの更新、モデルの再トレーニングなど、関係者に対応する最適化措置を講じるよう通知します。
プロセス全体は、データ収集、品質監視から問題対応までの完全なクローズドループを形成し、オンラインモデルが高品質なサービスを継続的かつ安定的に提供できることを保証するとともに、モデルの継続的な最適化と反復のためのデータ基盤を提供します。
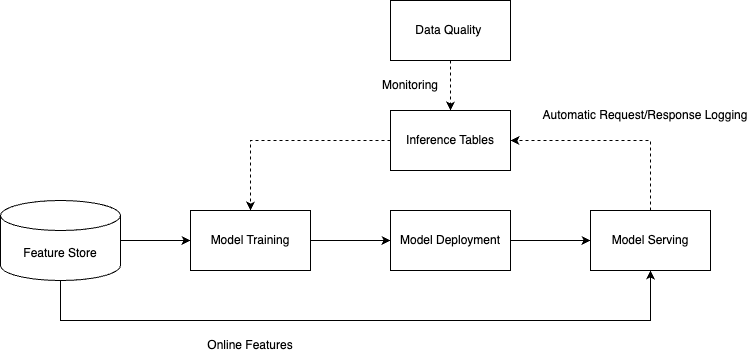
推論テーブル監視フロー:
下図は、推論テーブルデータ監視の完全な技術フローを示しています。プロセス全体は、データ収集、データ処理、品質監視の3つのコアステージに分かれています:
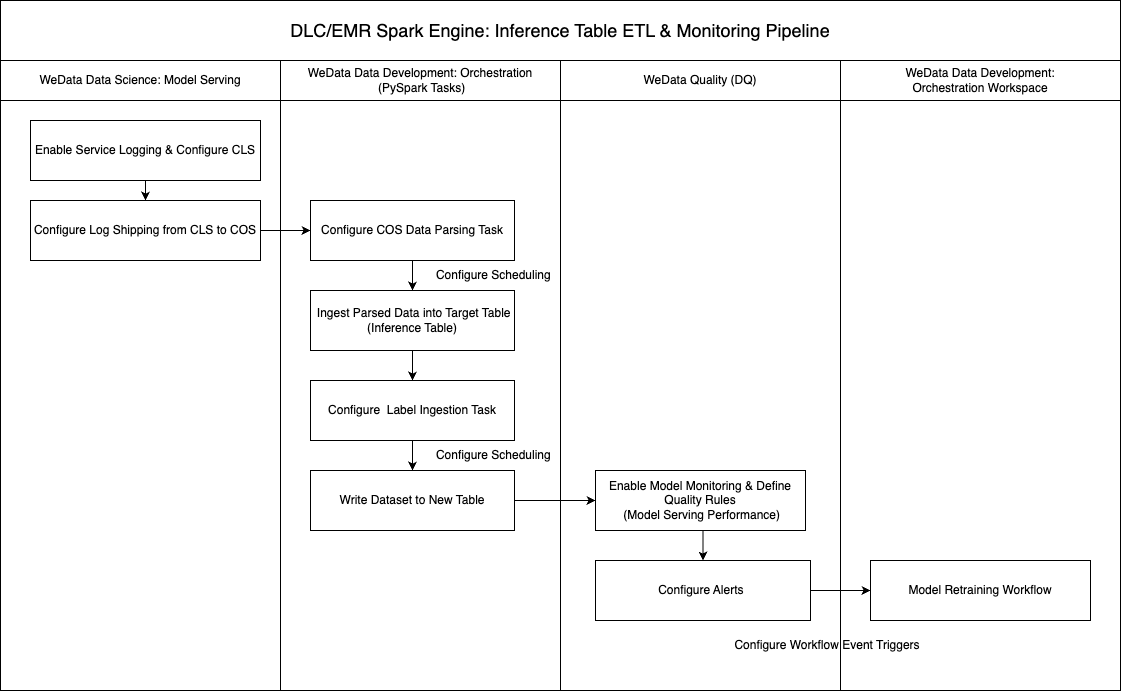
データ収集段階:モデルサービスをデプロイする際に、サービスログ収集機能とログ配信メカニズムを有効にする必要があります。システムはモデル推論プロセス中に生成される各種ログ情報を自動的に収集し、設定された配信ポリシーを通じてこれらの生ログデータをCOSオブジェクトストレージに安全に転送します。
データ処理段階:ログデータがCOSに正常に配信された後、WeDataオフライン開発のオーケストレーションスペースでPySparkデータ加工タスクを設定できます。対応するデータ処理ロジックを作成し、生の推論ログに対してクリーニング、変換、構造化処理を行い、モデル入力特徴、予測結果、応答時間、エラー情報などの主要指標を抽出し、最終的に標準化処理された推論データを専用の推論テーブルに書き込みます。
品質監視段階:推論テーブル内の構造化データに基づき、WeDataデータ品質モジュールでモデルサービス品質監視ルールを設定し、多層的な監視指標とアラート閾値を設定します。モデル性能の異常、データドリフト、サービス品質低下などの問題が検出された場合、システムは自動的にアラート通知をトリガーします。さらに、アラートイベントの重大度とタイプに応じて、対応するモデル再トレーニングワークフローを自動的にトリガーし、問題発見から自動修復までのインテリジェントな運用保守クローズドループを実現します。
データ収集:
モデルサービスを作成する際に、詳細設定オプションから完全なログ収集を有効にできます:
サービスログ配信設定:まずサービスログ配信機能を有効にし、ターゲットログセットと対応するログトピックを指定する必要があります。設定が完了すると、モデルサービスによって生成されたすべてのリクエストログは、指定されたログトピックに自動的に配信されます。
推論テーブルログ収集設定:サービス推論テーブルログ収集オプションを有効にし、適切なCOSストレージバケットをデータストレージターゲットとして選択します。この機能を有効にすると、システムは専用のログ加工タスクを自動的に作成します。このタスクは、収集された全量ログデータに対してフィルタリングと構造化処理を行い、事前に指定されたCOSストレージアドレスに配信します。
データ加工:
COS推論ログデータの加工
このステップの目的は、元のモデル入出力情報を解析し、非構造化ログデータを標準化された特徴データと予測結果に変換し、処理済みデータを専用の推論テーブルに書き込み、後続のデータ分析とTag関連付け作業に構造化データ基盤を提供することです。
技術実装ソリューション:
ストリーミング処理アーキテクチャ:リアルタイムストリーミングデータ処理にはSpark Streamingの採用を推奨します。この方式は、COSバケット内の新規ログファイルを継続的に監視し、データの解析と変換をリアルタイムに実行することで、推論データの即時性を確保します。
増分処理メカニズム:データ書き込みプロセス中にCheckpointチェックポイントメカニズムを設定し、処理進捗と状態情報を記録します。定時実行ポリシーを設定することで、システムは増分データを自動的に識別して処理し、既存データの重複処理を回避すると同時に、データ処理の完全性と一貫性を確保します。
フォールトトレランス保障:Checkpointメカニズムは障害復旧機能も提供します。処理タスクが異常により中断された場合、最近のチェックポイントから実行を再開でき、データ処理の信頼性を確保します。
異なるエンジンに応じて、以下の実装コードを参照できます:
DLC Sparkエンジン
"""このサンプルは、Spark Streamingを使用してCOSストレージ内の推論テーブルをストリーミング読み取りし、主要フィールド(特徴、予測値)を加工処理した後、DLC内部テーブルに書き込む処理プロセスを示しています。"""## 前提条件1. このDLCエンジンに関連付けられたCOSアクセス認証情報に、推論テーブルストレージバケットへのアクセス権限があることを確認してください。2. モデルサービスが推論テーブル監視を有効にしていることを確認してください。## 実行方法チュートリアルのパラメータを変更した後、オフライン開発->オーケストレーションスペースでDLC PySparkタスクを選択して実行します。## 定時スケジュール対応するパラメータを変更してデバッグを完了した後、このタスクを定時実行に設定し、推論テーブルデータを継続的に加工できます。また、加工後の推論テーブルデータをTagデータと関連付け、Tagデータを含む推論テーブルを生成し、データ品質モジュールで推論テーブルに機械学習関連の監視指標を設定して、モデル品質を継続的に監視できます。"""from pyspark.sql import DataFrame, SparkSessionfrom pyspark.sql import functions as Ffrom pyspark.sql import types as Tfrom typing import Union, List, Dict, Optional, Sequence, Anyfrom pyspark.sql.streaming import StreamingQueryfrom pyspark.sql.types import (StructType, StructField, StringType, LongType, DoubleType,ArrayType, TimestampType)"""### 元の推論テーブルデータ形式の定義元の推論テーブルデータは特定の構造に従ってJSON形式でユーザー指定のCOSバケットに保存されます。request_schemaはユーザー入力リクエスト構造を表し、response_schemaはモデル出力構造を表します。モデルサービスに対応する実際の入出力形式に応じて調整してください。その他のフィールドは推論テーブルの固定構造であるため、通常は調整不要です。"""request_schema = StructType([StructField("client_request_id", StringType(), True),StructField("dataframe_split", StructType([StructField("columns", ArrayType(StringType()), True),StructField("data", ArrayType(ArrayType(DoubleType())), True),]), True),])request_metadata_schema = StructType([StructField("model_name", StringType(), True),StructField("model_version", StringType(), True),StructField("service_id", StringType(), True),])response_schema = StructType([StructField("predictions", ArrayType(LongType()), True),])schema = StructType([StructField("client_request_id", StringType(), True),StructField("execution_duration_ms", LongType(), True),StructField("request", request_schema, True),StructField("request_date", StringType(), True),StructField("request_metadata", request_metadata_schema, True),StructField("request_time", TimestampType(), True),StructField("requester", StringType(), True),StructField("response", response_schema, True),StructField("sampling_fraction", DoubleType(), True),StructField("status_code", LongType(), True),StructField("wedata_request_id", StringType(), True),])# データソースパラメータSOURCE_PATH = "cosn://ストレージバケットパス/" # 推論テーブルストレージパスCHECKPOINT_PATH = "cosn://ストレージバケットパス/checkpoint" # check_pointストレージパス、推論テーブルストレージパスと一致させることを推奨します# 結果テーブルパラメータUNPACKED_TABLE_NAME = "DataLakeCatalog.test.unpacked_test_inference_table" # 結果テーブル名。DLC内部テーブルの3セグメント形式のテーブル名である必要があります:<データカタログ>.<データベース>.<データテーブル>MODEL_ID_COL = "model_id" # 結果テーブルモデルID列、モデルの識別に使用しますEXAMPLE_ID_COL = "example_id" # 結果テーブルレコードの一意のID列、ユーザー更新操作PREDICTION_COL = "prediction" # 予測値列名FEATURE_COLUMNS = ["sepal_length", "sepal_width", "petal_length", "petal_width"] # 特徴列名。モデルの特徴に応じて調整しますdef process_requests(requests_raw: DataFrame) -> DataFrame:"""リクエスト特徴を個別の列に展開し、対応する予測結果とペアリングします。Args:requests_raw: 処理対象データReturn:処理済みデータ"""# 成功したリクエストをフィルタリングしますrequests_success = requests_raw.filter(F.col("status_code") == 200).drop("status_code")# モデル識別子を生成しますrequests_identified = requests_success \\.withColumn(MODEL_ID_COL, F.concat(F.col("request_metadata").getItem("model_name"), F.lit("_"), F.col("request_metadata").getItem("model_version"))) \\.drop("request_metadata")# 特徴列と予測結果を展開します# 1. 特徴列名、特徴データ、予測値を取得しますrequests_with_features = (requests_identified.withColumn("feature_columns", F.col("request.dataframe_split.columns")).withColumn("feature_data", F.col("request.dataframe_split.data")).withColumn("predictions", F.col("response.predictions")))# 2. 各データ行を対応する予測結果とペアリングします。requests_exploded = (requests_with_features.withColumn("feature_prediction_pairs",F.arrays_zip(F.col("feature_data"), F.col("predictions"))).withColumn("feature_prediction_pairs",F.explode(F.col("feature_prediction_pairs"))).withColumn("feature_row", F.col("feature_prediction_pairs.feature_data")).withColumn(PREDICTION_COL, F.col("feature_prediction_pairs.predictions")))# 3. 特徴列を動的に作成しますrequests_with_feature_cols = requests_explodedfor i, col_name in enumerate(FEATURE_COLUMNS):requests_with_feature_cols = (requests_with_feature_cols.withColumn(col_name, F.col("feature_row")[i]))# 4. レコードの一意のIDを追加し、後続のupsert操作を容易にします。requests_with_example_id = requests_with_feature_cols \\.withColumn(EXAMPLE_ID_COL, F.expr("uuid()"))# 5. 一時列をクリーンアップします。requests_processed = (requests_with_example_id.drop("feature_columns", "feature_data", "feature_prediction_pairs", "feature_row", "predictions", "request", "response"))return requests_processeddef create_table(spark: SparkSession,table_name: str,df: Optional[DataFrame] = None,partition_expr: str = None,description: Optional[str] = None,):"""dlc内部テーブルを作成します。Args:spark:SparkSessionインスタンスtable_name: テーブル完全名(形式:データカタログ.データベース.データテーブル)df: 初期データ(スキーマ推論に使用)partition_expr: パーティション列(ストレージクエリを最適化)description: テーブル説明Raises:ValueError:異常作成時にスローされます。"""# テーブルスキーマを推論します。table_schema = df.schema# 列定義を構築します。columns_ddl = []for field in table_schema.fields:data_type = field.dataType.simpleString().upper()col_def = f"`{field.name}` {data_type}"if not field.nullable:col_def += " NOT NULL"columns_ddl.append(col_def)# 建表文を構築します。ddl = f"""CREATE TABLE IF NOT EXISTS {table_name} ({', '.join(columns_ddl)})USING icebergPARTITIONED BY ({partition_expr})TBLPROPERTIES ('comment'= '{description or ''}','format-version'= '2','write.metadata.previous-versions-max'= '100','write.metadata.delete-after-commit.enabled'= 'true','smart-optimizer.inherit' = 'none','smart-optimizer.written.enable' = 'enable')"""# sqlを出力します。print(f"create table ddl: {ddl}\\n")# DDLを実行します。try:spark.sql(ddl)except Exception as e:raise ValueError(f"Failed to create table: {str(e)}") from eprint(f"create table {table_name} done")spark = SparkSession.builder.appName("Operate DB Example").getOrCreate()# ストリーミングDataFrameを構築します。df = (spark.readStream.format("json").schema(schema).load(SOURCE_PATH))# ストリーミングデータを処理します。unpacked_df = process_requests(df)# 結果テーブルを作成し、request_timeをパーティションフィールドとして、日ごとにパーティションを作成します。モデルサービスのリクエスト量に応じて調整できます。create_table(spark, UNPACKED_TABLE_NAME, unpacked_df, 'days(request_time)')# データを書き込みます。query = unpacked_df.writeStream \\.format("parquet") \\.outputMode("append") \\.option("checkpointLocation", CHECKPOINT_PATH) \\.trigger(once=True) \\.toTable(UNPACKED_TABLE_NAME)query.awaitTermination()spark.sql(f"select * from {UNPACKED_TABLE_NAME}").show(10)
EMR Sparkエンジン
"""このサンプルは、Spark Streamingを使用してCOSストレージ内の推論テーブルをストリーミング読み取りし、主要フィールド(特徴、予測値)を加工処理した後、EMR Hiveテーブルに書き込む処理プロセスを示しています。## 前提条件1. このDLCエンジンに関連付けられたCOSアクセス認証情報に、推論テーブルストレージバケットへのアクセス権限があることを確認してください。2. モデルサービスが推論テーブル監視を有効にしていることを確認してください。## 実行方法チュートリアルのパラメータを変更した後、オフライン開発->オーケストレーションスペースでEMR PySparkタスクを選択して実行します。## 定時スケジュール対応するパラメータを変更してデバッグを完了した後、このタスクを定時実行に設定し、推論テーブルデータを継続的に加工できます。また、加工後の推論テーブルデータをTagデータと関連付け、Tagデータを含む推論テーブルを生成し、データ品質モジュールで推論テーブルに機械学習関連の監視指標を設定して、モデル品質を継続的に監視できます。"""from pyspark.sql import DataFrame, SparkSessionfrom pyspark.sql import functions as Ffrom pyspark.sql import types as Tfrom typing import Union, List, Dict, Optional, Sequence, Anyfrom pyspark.sql.streaming import StreamingQueryfrom pyspark.sql.types import (StructType, StructField, StringType, LongType, DoubleType,ArrayType, TimestampType)"""### 元の推論テーブルデータ形式の定義元の推論テーブルデータは特定の構造に従ってJSON形式でユーザー指定のCOSバケットに保存されます。request_schemaはユーザー入力リクエスト構造を表し、response_schemaはモデル出力構造を表します。モデルサービスに対応する実際の入出力形式に応じて調整してください。その他のフィールドは推論テーブルの固定構造であるため、通常は調整不要です。"""request_schema = StructType([StructField("client_request_id", StringType(), True),StructField("dataframe_split", StructType([StructField("columns", ArrayType(StringType()), True),StructField("data", ArrayType(ArrayType(DoubleType())), True),]), True),])request_metadata_schema = StructType([StructField("model_name", StringType(), True),StructField("model_version", StringType(), True),StructField("service_id", StringType(), True),])response_schema = StructType([StructField("predictions", ArrayType(LongType()), True),])schema = StructType([StructField("client_request_id", StringType(), True),StructField("execution_duration_ms", LongType(), True),StructField("request", request_schema, True),StructField("request_date", StringType(), True),StructField("request_metadata", request_metadata_schema, True),StructField("request_time", TimestampType(), True),StructField("requester", StringType(), True),StructField("response", response_schema, True),StructField("sampling_fraction", DoubleType(), True),StructField("status_code", LongType(), True),StructField("wedata_request_id", StringType(), True),])# データソースパラメータSOURCE_PATH = "cosn://ストレージバケットパス/" # 推論テーブルストレージパスCHECKPOINT_PATH = "cosn://ストレージバケットパス/checkpoint" # check_pointストレージパス、推論テーブルストレージパスと一致させることを推奨します# 結果テーブルパラメータUNPACKED_TABLE_NAME = "testdb.unpacked_test_inference_table" # 結果テーブル名。hiveテーブル名である必要があります:<データベース>.<データテーブル>MODEL_ID_COL = "model_id" # 結果テーブルモデルID列、モデルの識別に使用しますEXAMPLE_ID_COL = "example_id" # 結果テーブルレコードの一意のID列、ユーザー更新操作PREDICTION_COL = "prediction" # 予測値列名FEATURE_COLUMNS = ["sepal_length", "sepal_width", "petal_length", "petal_width"] # 特徴列名。モデルの特徴に応じて調整しますdef process_requests(requests_raw: DataFrame) -> DataFrame:"""リクエスト特徴を個別の列に展開し、対応する予測結果とペアリングします。Args:requests_raw: 処理対象データReturn:処理済みデータ"""# 成功したリクエストをフィルタリングしますrequests_success = requests_raw.filter(F.col("status_code") == 200).drop("status_code")# モデル識別子を生成しますrequests_identified = requests_success \\.withColumn(MODEL_ID_COL, F.concat(F.col("request_metadata").getItem("model_name"), F.lit("_"), F.col("request_metadata").getItem("model_version"))) \\.drop("request_metadata")# 特徴列と予測結果を展開します# 1. 特徴列名、特徴データ、予測値を取得しますrequests_with_features = (requests_identified.withColumn("feature_columns", F.col("request.dataframe_split.columns")).withColumn("feature_data", F.col("request.dataframe_split.data")).withColumn("predictions", F.col("response.predictions")))# 2. 各データ行を対応する予測結果とペアリングします。requests_exploded = (requests_with_features.withColumn("feature_prediction_pairs",F.arrays_zip(F.col("feature_data"), F.col("predictions"))).withColumn("feature_prediction_pairs",F.explode(F.col("feature_prediction_pairs"))).withColumn("feature_row", F.col("feature_prediction_pairs.feature_data")).withColumn(PREDICTION_COL, F.col("feature_prediction_pairs.predictions")))# 3. 特徴列を動的に作成しますrequests_with_feature_cols = requests_explodedfor i, col_name in enumerate(FEATURE_COLUMNS):requests_with_feature_cols = (requests_with_feature_cols.withColumn(col_name, F.col("feature_row")[i]))# 4. レコードの一意のIDを追加し、後続のupsert操作を容易にします。requests_with_example_id = requests_with_feature_cols \\.withColumn(EXAMPLE_ID_COL, F.expr("uuid()"))# 5. 一時列をクリーンアップします。requests_processed = (requests_with_example_id.drop("feature_columns", "feature_data", "feature_prediction_pairs", "feature_row", "predictions", "request", "response"))return requests_processeddef create_table(spark: SparkSession,table_name: str,df: Optional[DataFrame] = None,partition_expr: str = None,description: Optional[str] = None,):"""hiveテーブルを作成します。Args:spark:SparkSessionインスタンスtable_name: hiveテーブル完全名(形式:データベース.データテーブル)df: 初期データ(オプション、スキーマ推論に使用)partition_expr: パーティション列(ストレージクエリの最適化)description: テーブル説明Raises:ValueError:異常作成時にスローされます。"""# テーブルスキーマを推論します。table_schema = df.schemapart_col_nam = partition_expr.split(' ')[0]# 列定義を構築します。columns_ddl = []for field in table_schema.fields:# テーブル作成時にパーティション列を除外します。if field.name == part_col_nam:continuedata_type = field.dataType.simpleString().upper()col_def = f"`{field.name}` {data_type}"if not field.nullable:col_def += " NOT NULL"columns_ddl.append(col_def)# 建表文を構築します。ddl = f"""CREATE TABLE IF NOT EXISTS {table_name} ({', '.join(columns_ddl)})PARTITIONED BY ({partition_expr})TBLPROPERTIES ('comment'= '{description or ''}')"""# sqlを出力します。print(f"create table ddl: {ddl}\\n")# DDLを実行します。try:spark.sql(ddl)except Exception as e:raise ValueError(f"Failed to create table: {str(e)}") from eprint(f"create table {table_name} done")def write_batch_to_hive(batch_df: DataFrame, batch_id: int, table_name: str):# 小ファイルの制御:パーティション列による再パーティションout_df = batch_df.repartition(8, "dt")out_df.write.mode("append").format("hive").saveAsTable(table_name,partitionBy="dt")spark = SparkSession.builder.appName("Operate DB Example").enableHiveSupport().getOrCreate()# ストリーミングDataFrameを構築します。df = (spark.readStream.format("json").schema(schema).load(SOURCE_PATH))# ストリーミングデータを処理します。unpacked_df = process_requests(df)# パーティション列を挿入します。requests_with_dt = (unpacked_df.withColumn("dt", F.substring(F.col("request_date"), 1, 10)) # YYYY-MM-DD形式の日付を抽出します。)# 結果テーブルを作成します。create_table(spark, UNPACKED_TABLE_NAME, unpacked_df, 'dt STRING')# Hive動的パーティションを設定します。spark.sql("SET hive.exec.dynamic.partition=true")spark.sql("SET hive.exec.dynamic.partition.mode=nonstrict")# 結果テーブルにバッチで書き込みます。query = (requests_with_dt.writeStream.outputMode("append").option("checkpointLocation", CHECKPOINT_PATH).trigger(once=True).foreachBatch(lambda df, id: write_batch_to_hive(df, id, UNPACKED_TABLE_NAME)).start())query.awaitTermination()# 結果データを照会します。spark.sql(f"select * from {UNPACKED_TABLE_NAME}").show(10)
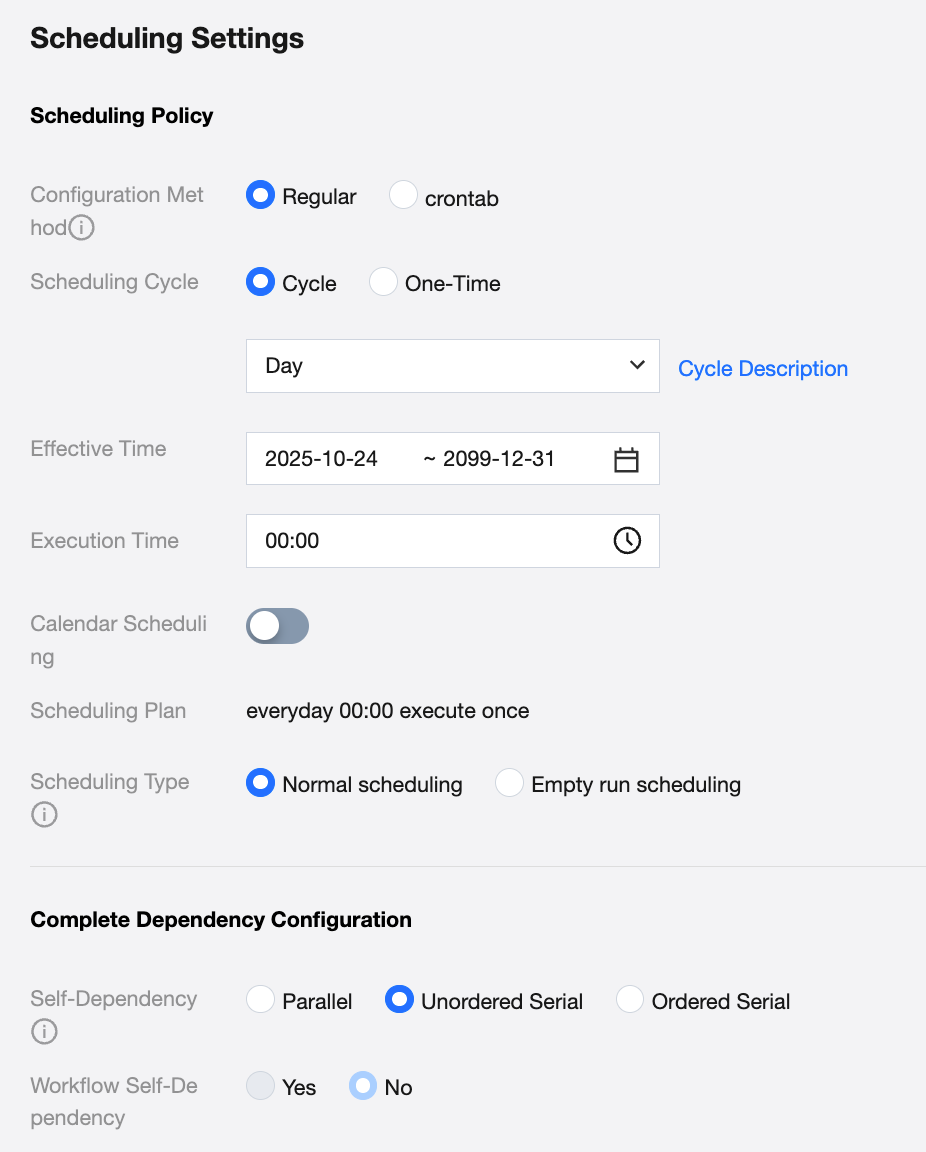
タスク周期実行の設定
タスクをデバッグし、手動実行が成功して処理済みデータが書き込まれたことを確認した後、スケジューリング設定でタスクを定期実行に設定できます。少なくとも週1回の設定を推奨します。これによりモデル品質を継続的に監視できます。
関連タグデータタスクの設定
完全なモデル監視・評価体系を構築するために、これらの推論データを実際のタグデータとさらに関連付け、入力特徴、モデル予測結果、実際のタグを含む完全な推論テーブルデータセットを取得する必要があります。このタグ関連付けプロセスはモデル効果評価の重要なステップであり、予測値と実際のタグを比較することで、モデルの精度、再現率などの主要な性能指標を計算でき、それによってモデル品質の定量監視と傾向分析を実現できます。タグデータの取得には通常、業務システムのフィードバックメカニズムまたは手動ラベリングプロセスを組み合わせる必要があります。使用するデータ処理エンジンと具体的な業務シナリオに応じて、対応するデータ加工コード実装を参照してタグデータの関連付け操作を完了し、包括的なモデル監視をサポートする完全なデータ基盤を形成できます。
DLC Sparkエンジン
from pyspark.sql import DataFrame, SparkSessionfrom typing import Union, List, Dict, Optional, Sequence, Any# タグを関連付ける推論テーブル名:DLC内部テーブルの3セグメント形式のテーブル名である必要があります:<データカタログ>.<データベース>.<データテーブル>UNPACKED_TABLE_NAME = "DataLakeCatalog.test.unpacked_test_inference_table"# タグデータテーブル設定:複数指定できます。各テーブルには構造(<テーブル名>、<joinで保持するフィールド名リスト>、<join時に等値条件で結合するフィールドリスト>)が含まれている必要があります。JOIN_TABLES = [('DataLakeCatalog.test.test_label_table', ['label', 'example_id'], ['example_id'])]# タグデータ関連付け後の推論テーブル名FULLY_QUALIFIED_TABLE_NAME = "DataLakeCatalog.test.test_fully_qualified_table_name"# ウィンドウサイズ: このNotebookスクリプトを実行するたびに処理するデータの最大期間を制限します。このウィンドウより前のデータで未処理のものは無視されます。すべてのデータが処理されるように、スケジュール周期はこのウィンドウサイズより小さくする必要があります。PROCESSING_WINDOW_DAYS = 10# 結果テーブル挿入時の主キーフィールドMERGE_COLS = ["request_time", "example_id"]def create_table(spark: SparkSession,table_name: str,df: Optional[DataFrame] = None,partition_expr: str = None,description: Optional[str] = None,):"""dlc内部テーブルを作成します。Args:spark: SparkSessionインスタンスtable_name: テーブル完全名(形式:データカタログ.データベース.データテーブル)df: 初期データ(スキーマ推論に使用)partition_expr: パーティション列(ストレージクエリの最適化)description: テーブル説明Raises:ValueError: 異常作成時にスローされます"""# テーブルスキーマを推論しますtable_schema = df.schema# 列定義を構築しますcolumns_ddl = []for field in table_schema.fields:data_type = field.dataType.simpleString().upper()col_def = f"`{field.name}` {data_type}"if not field.nullable:col_def += " NOT NULL"columns_ddl.append(col_def)# 建表文を構築しますddl = f"""CREATE TABLE IF NOT EXISTS {table_name} ({', '.join(columns_ddl)})USING icebergPARTITIONED BY ({partition_expr})TBLPROPERTIES ('comment'= '{description or ''}','format-version'= '2','write.metadata.previous-versions-max'= '100','write.metadata.delete-after-commit.enabled'= 'true','smart-optimizer.inherit' = 'none','smart-optimizer.written.enable' = 'enable')"""# sqlを出力しますprint(f"create table ddl: {ddl}\\n")# DDLを実行しますtry:spark.sql(ddl)except Exception as e:raise ValueError(f"Failed to create table: {str(e)}") from eprint(f"create table {table_name} done")def upsert_table(spark: SparkSession,target_table_name: str,merge_cols: list,df: DataFrame,):"""upsert方式でターゲットテーブルにデータを書き込みます。Args:spark: SparkSession インスタンスtarget_table_name: 結果テーブル完全名(形式:データカタログ.データベース.データテーブル)merge_cols: 更新時の主キーdf: 更新対象データRaises:ValueError:書き込み異常時にスローされます。"""merge_condition = " AND ".join([f"target.{col} = source.{col}" for col in merge_cols])# 一時ビューを作成します。df.createOrReplaceTempView("source_data")# MERGE操作を実行します。merge_sql = f"""MERGE INTO {target_table_name} AS targetUSING source_data AS sourceON {merge_condition}WHEN MATCHED THEN UPDATE SET *WHEN NOT MATCHED THEN INSERT *"""# DMLを実行します。try:spark.sql(merge_sql)except Exception as e:raise ValueError(f"Failed to create table: {str(e)}") from eprint(f"upsert table {target_table_name} done")spark = SparkSession.builder.appName("Operate DB Example").getOrCreate()# 毎回PROCESSING_WINDOW_DAYSのデータを読み取ります。requests_processed = spark.table(UNPACKED_TABLE_NAME) \\.filter(f"CAST(request_time AS DATE) >= current_date() - (INTERVAL {PROCESSING_WINDOW_DAYS} DAYS)")if requests_processed.count() > 0:# タグテーブルを関連付けます。for table_name, preserve_cols, join_cols in JOIN_TABLES:join_data = spark.table(table_name)requests_processed = requests_processed.join(join_data.select(preserve_cols), on=join_cols, how="left")# 結果テーブルを作成します。create_table(spark, FULLY_QUALIFIED_TABLE_NAME, requests_processed, 'days(request_time)')# 結果テーブルに書き込みます。upsert_table(spark, FULLY_QUALIFIED_TABLE_NAME, MERGE_COLS, requests_processed)spark.sql(f"select * from {FULLY_QUALIFIED_TABLE_NAME}").show(10)
EMR Sparkエンジン
from pyspark.sql import DataFrame, SparkSessionfrom typing import Union, List, Dict, Optional, Sequence, Any# タグを関連付ける推論テーブル名:Hiveテーブル名である必要があります:<データベース>.<データテーブル>UNPACKED_TABLE_NAME = "testdb.unpacked_test_inference_table"# タグデータテーブル設定:複数指定できます。各テーブルには構造(<テーブル名>、<joinで保持するフィールド名リスト>、<join時に等値条件で結合するフィールドリスト>)が含まれている必要があります。JOIN_TABLES = [('testdb.test_label_table', ['label', 'example_id'], ['example_id'])]# タグデータ関連付け後の推論テーブル名FULLY_QUALIFIED_TABLE_NAME = "testdb.test_fully_qualified_table_name"# ウィンドウサイズ: このNotebookスクリプトを実行するたびに処理するデータの最大期間を制限します。このウィンドウより前のデータで未処理のものは無視されます。すべてのデータが処理されるように、スケジュール周期はこのウィンドウサイズより小さくする必要があります。PROCESSING_WINDOW_DAYS = 10def create_table(spark: SparkSession,table_name: str,df: Optional[DataFrame] = None,partition_expr: str = None,description: Optional[str] = None,):"""hiveテーブルを作成します。Args:spark: SparkSessionインスタンスtable_name: hiveテーブル完全名(形式:データベース.データテーブル)df: 初期データ(オプション、スキーマ推論に使用)partition_expr: パーティション列(ストレージクエリの最適化)description: テーブルの説明Raises:ValueError: 作成異常時にスローされます。"""# テーブルスキーマを推論します。table_schema = df.schemapart_col_nam = partition_expr.split(' ')[0]# 列定義を構築します。columns_ddl = []for field in table_schema.fields:# テーブル作成時にパーティション列を除外します。if field.name == part_col_nam:continuedata_type = field.dataType.simpleString().upper()col_def = f"`{field.name}` {data_type}"if not field.nullable:col_def += " NOT NULL"columns_ddl.append(col_def)# テーブル作成文を構築します。ddl = f"""CREATE TABLE IF NOT EXISTS {table_name} ({', '.join(columns_ddl)})PARTITIONED BY ({partition_expr})TBLPROPERTIES ('comment'= '{description or ''}')"""# sqlを出力します。print(f"create table ddl: {ddl}\\n")# DDLを実行します。try:spark.sql(ddl)except Exception as e:raise ValueError(f"Failed to create table: {str(e)}") from eprint(f"create table {table_name} done")def partition_overwrite(spark, source_df, target_table):""""""try:# データが空かどうかを確認します。if source_df.count() == 0:print(f"警告: {target_table}に書き込むデータがありません。")return# 上書きするパーティションを表示します。partitions = source_df.select("dt").distinct().collect()partition_list = [row.dt for row in partitions]print(f"上書きするパーティション: {partition_list}")# パラメータを設定して書き込みます。spark.sql("SET hive.exec.dynamic.partition=true")spark.sql("SET hive.exec.dynamic.partition.mode=nonstrict")spark.conf.set("spark.sql.sources.partitionOverwriteMode", "dynamic")source_df.repartition(8, "dt") \\.write \\.mode("overwrite") \\.format("hive") \\.saveAsTable(target_table)print(f"{len(partition_list)} 個のパーティションをテーブル {target_table} に正常に上書きしました。")except Exception as e:print(f"テーブル {target_table} への書き込み中にエラーが発生しました: {str(e)}")raisespark = SparkSession.builder.appName("Operate DB Example").getOrCreate()# 毎回PROCESSING_WINDOW_DAYS分区のデータを読み取り、処理後に上書き書き込みを行います。requests_processed = spark.table(UNPACKED_TABLE_NAME) \\.filter(f"dt >= date_format(current_date() - INTERVAL {PROCESSING_WINDOW_DAYS} DAYS, 'yyyy-MM-dd')")for table_name, preserve_cols, join_cols in JOIN_TABLES:join_data = spark.table(table_name)requests_processed = requests_processed.join(join_data.select(preserve_cols), on=join_cols, how="left")create_table(spark, FULLY_QUALIFIED_TABLE_NAME, requests_processed, 'dt STRING')partition_overwrite(spark, requests_processed, FULLY_QUALIFIED_TABLE_NAME)spark.sql(f"select * from {FULLY_QUALIFIED_TABLE_NAME}").show(10)
タスク周期実行の設定
関連Tagタスクが手動で正常に実行され、データが書き込まれたことを確認した後、タスクを定期実行に設定できます。設定方法はステップ2を参照してください。実行周期はステップ2で設定したCOSデータ加工タスクの周期以上にすることを推奨します。
モデルサービスリソースグループの作成(CVMリソースグループ)
モデルサービスをデプロイする際、リソースソースを設定する必要があります。CVMリソースグループを選択すると、ドロップダウンリストに現在のプロジェクトの利用可能なリソースグループが表示されます。CPUとメモリの使用量、GPUを使用するかどうかのスイッチを自由に設定できます。
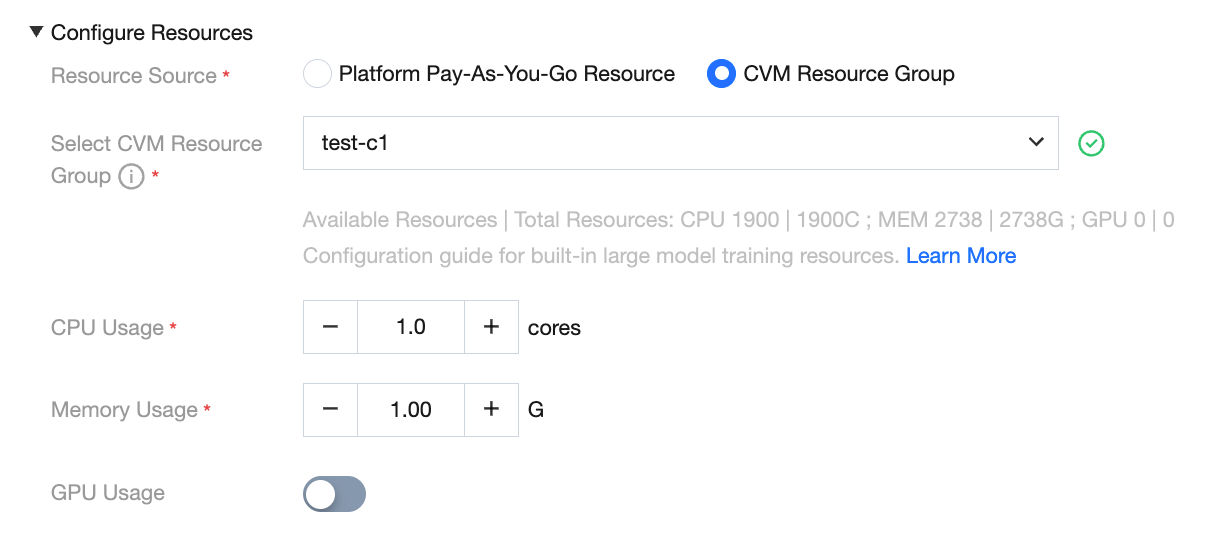
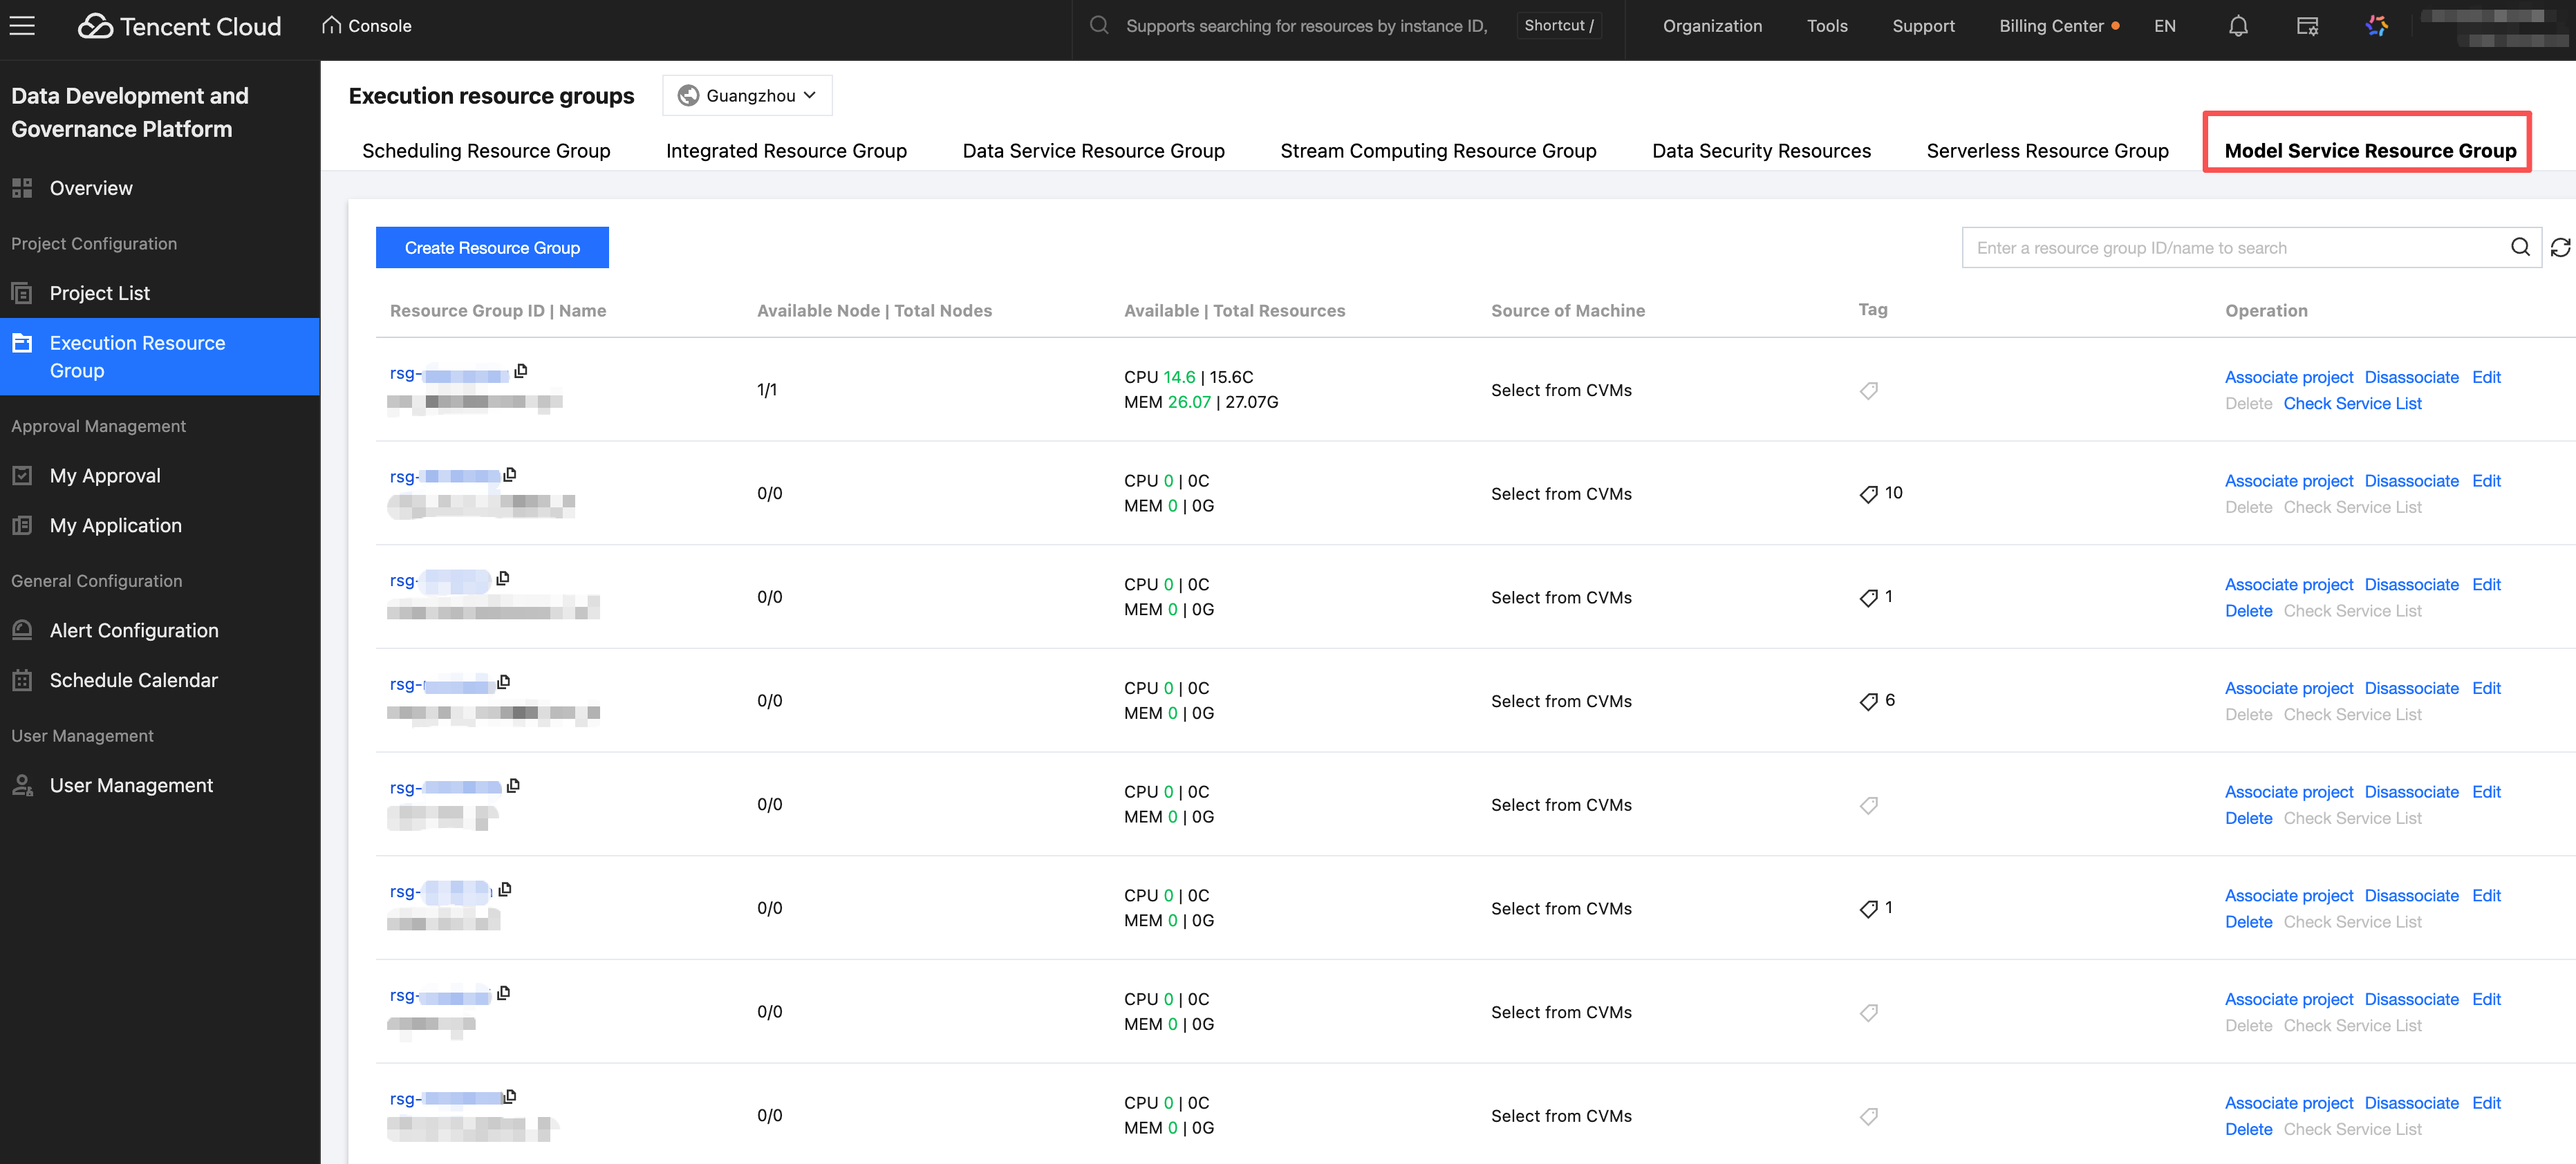
「CVMリソースグループの管理」をクリックすると、リソースグループ一覧ページに移動します:
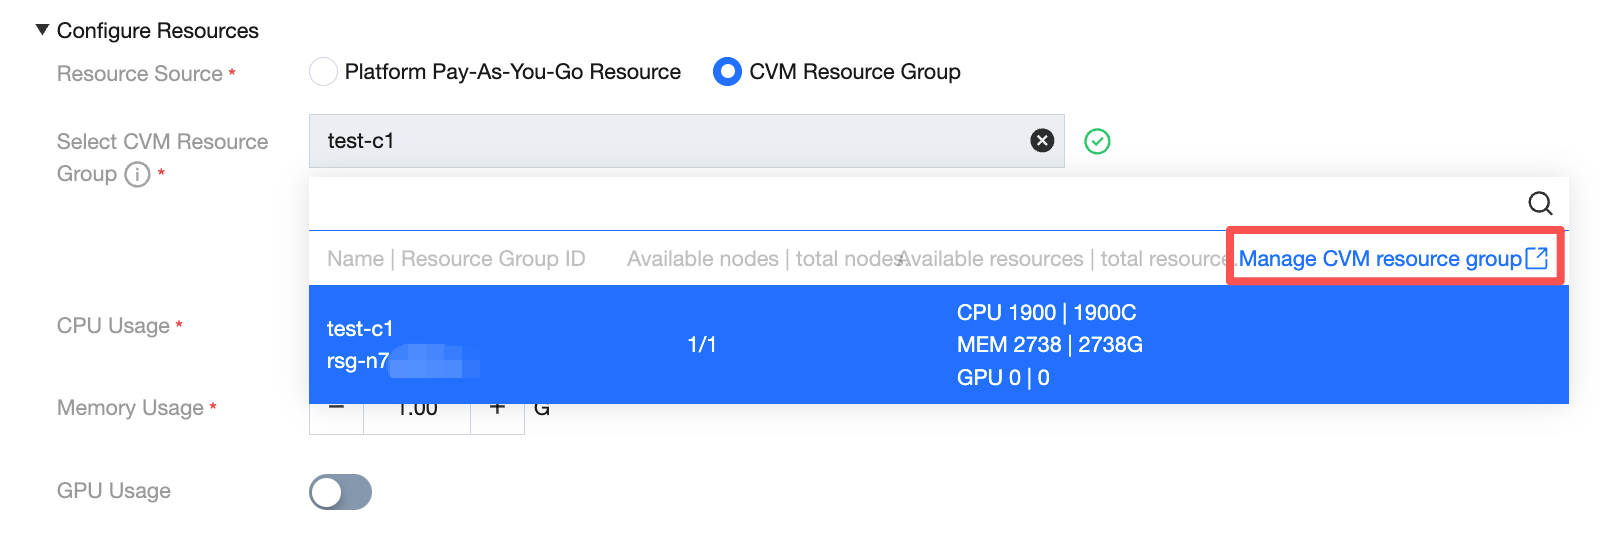
モデルサービス > リソースグループ一覧を表示し、操作をクリックしてプロジェクトを関連付けることができます:
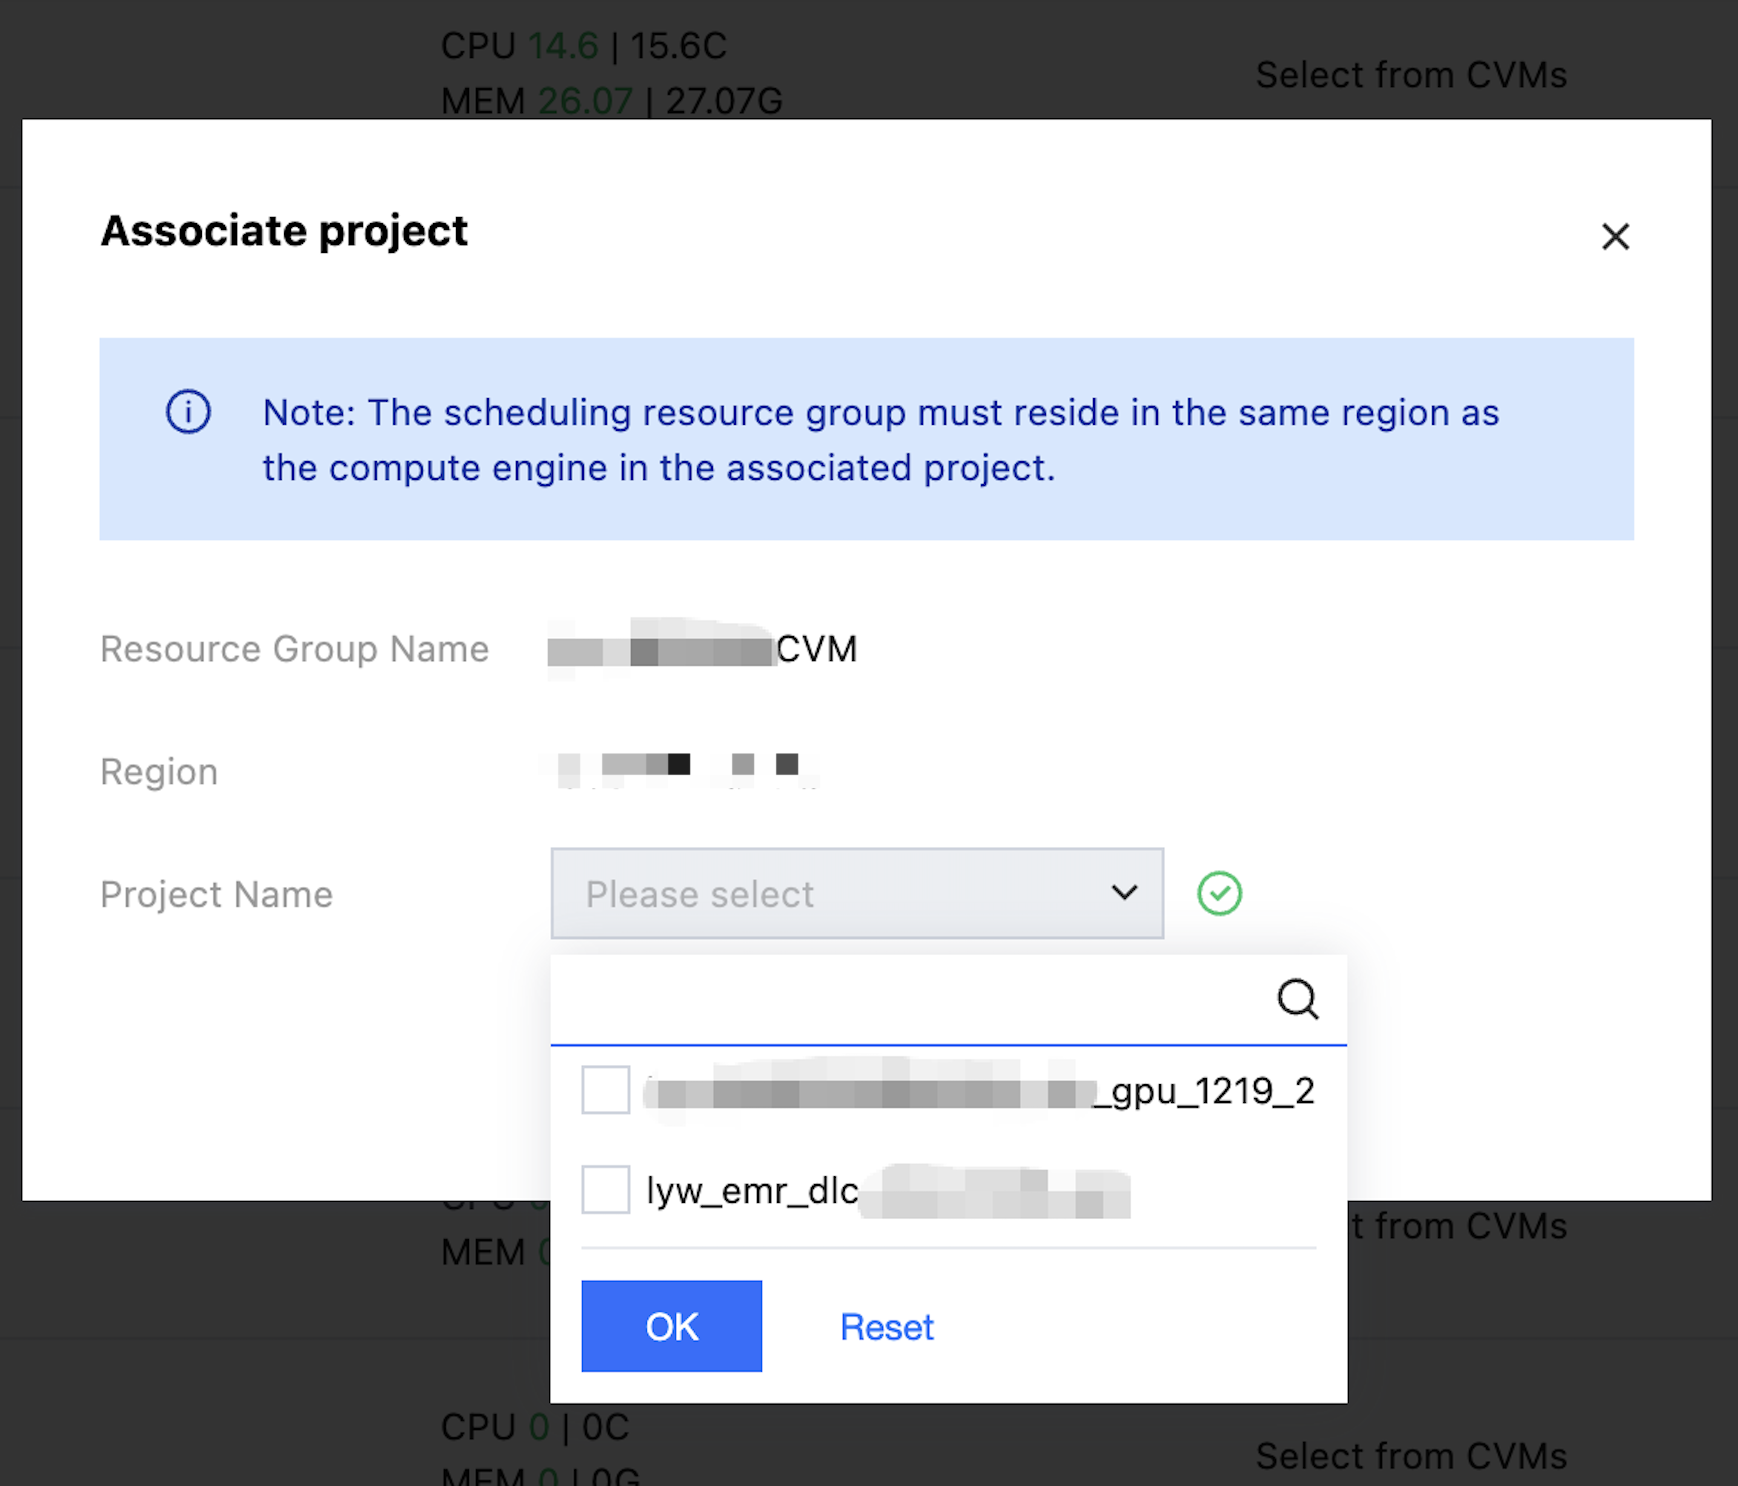
操作 > 関連プロジェクトを選択し、プロジェクト名をドロップダウンで絞り込み、関連付けを完了できます:
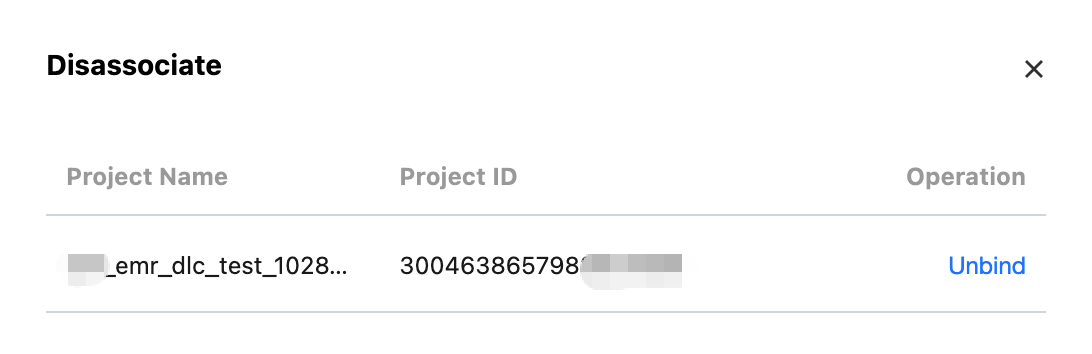
操作 > バインド解除をクリックすると、このリソースグループの関連プロジェクトをバインド解除できます:
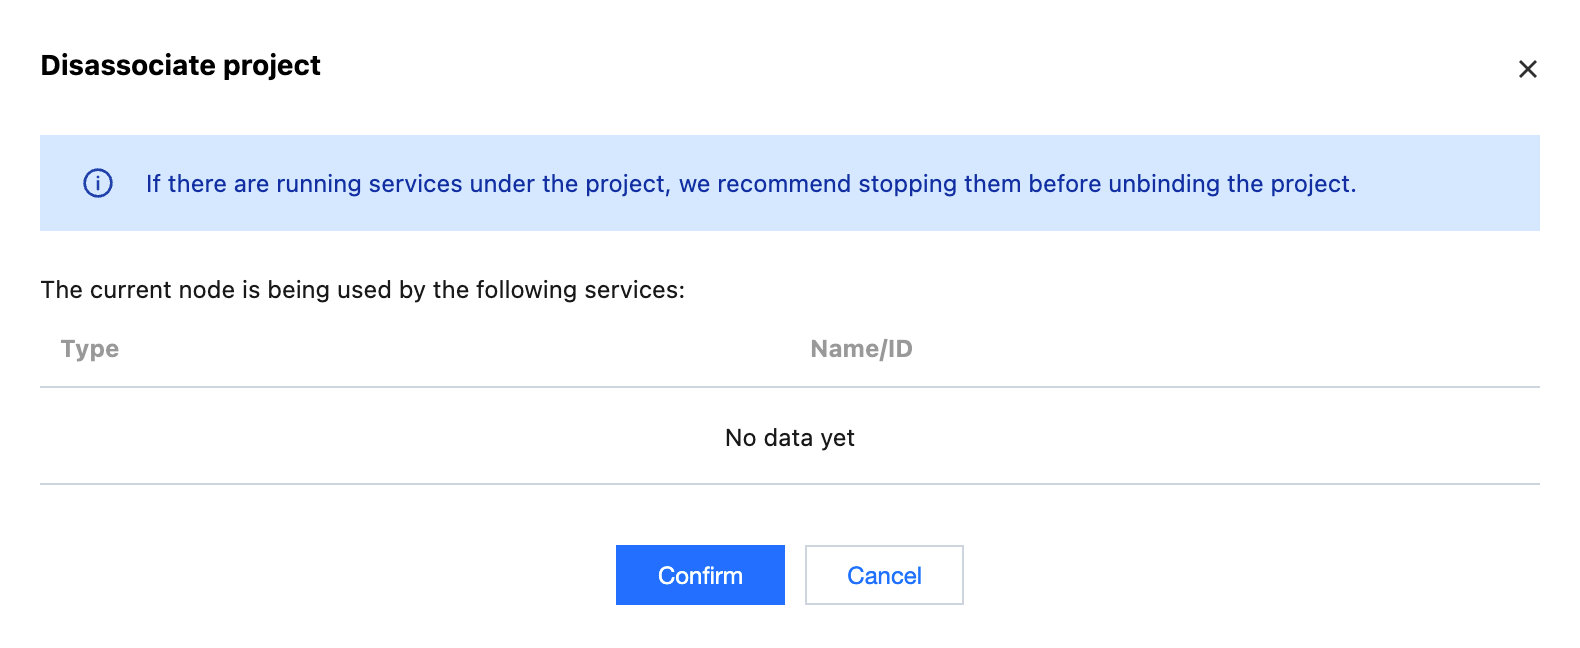
操作 > 編集をクリックすると、このリソースグループのTag、名前などのフィールドを変更できます:
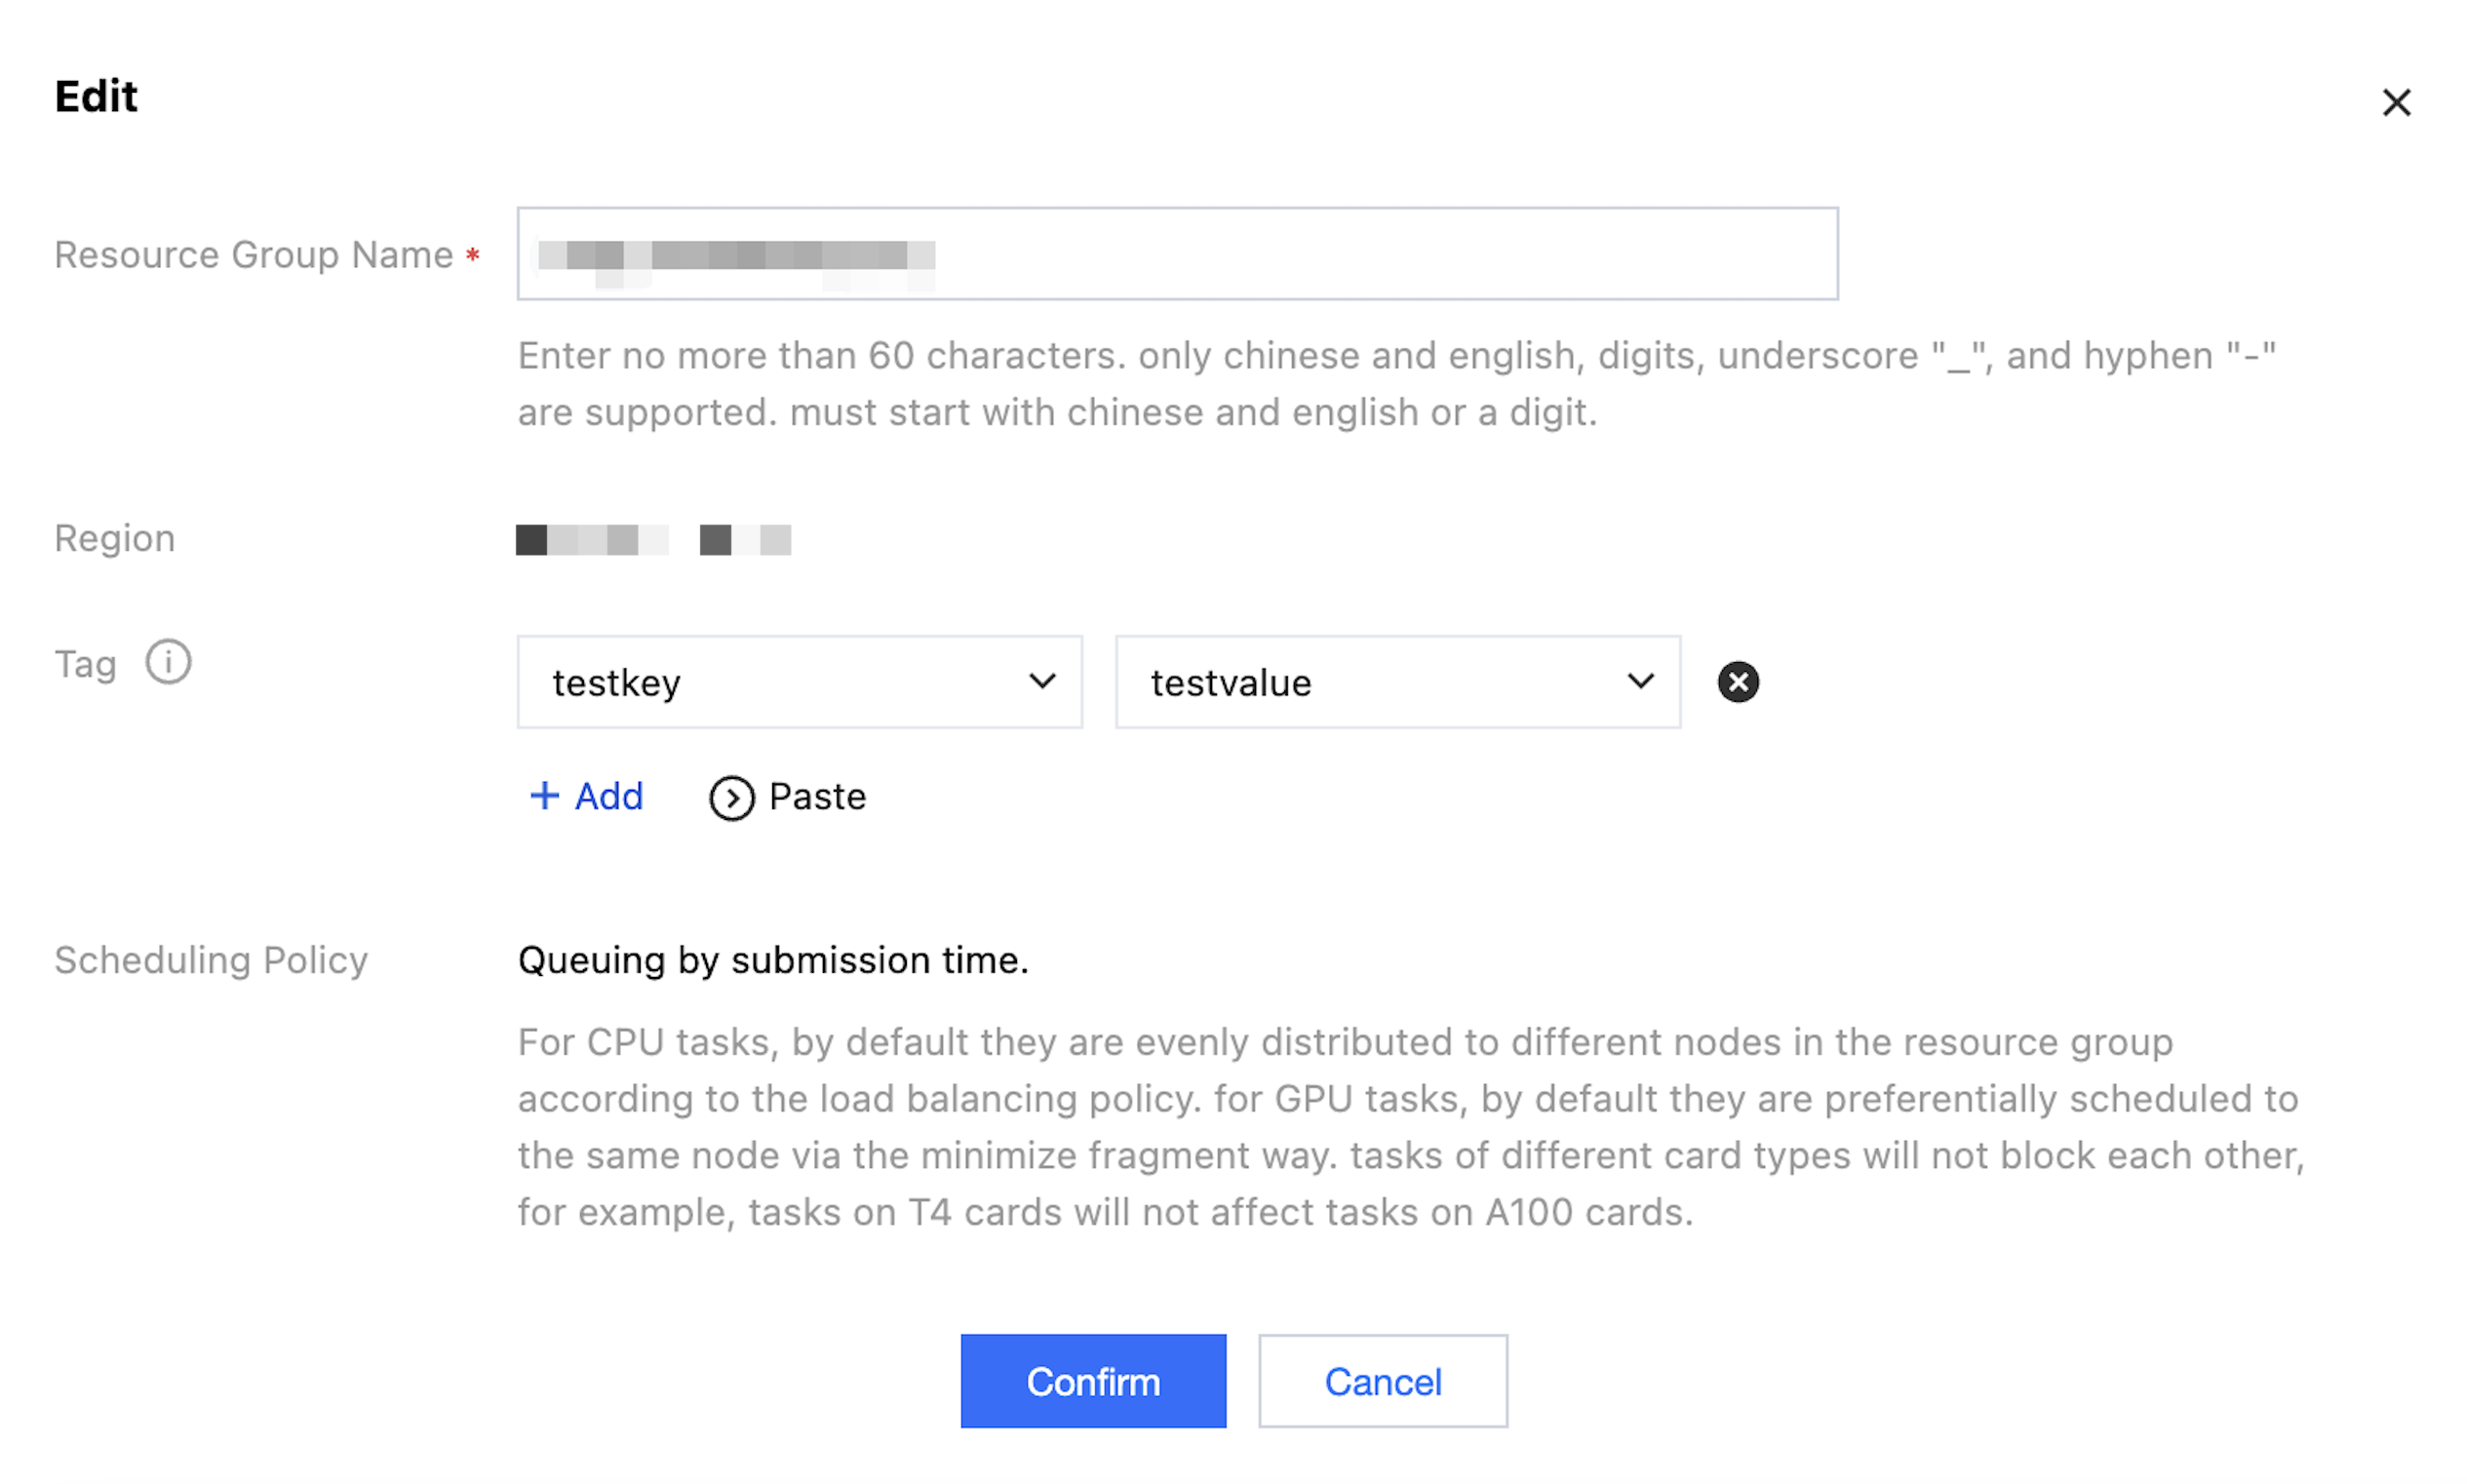
リソースグループ名をクリックすると、このリソースグループの詳細ページに移動します:
ノードID、利用可能なリソース、実行状態、課金モード、時間などの情報を表示できます。サービスリストの表示、移動、継続支払い、隔離、解放などの操作をサポートします。

ノード追加をクリックすると、有料購入ページに移動します:
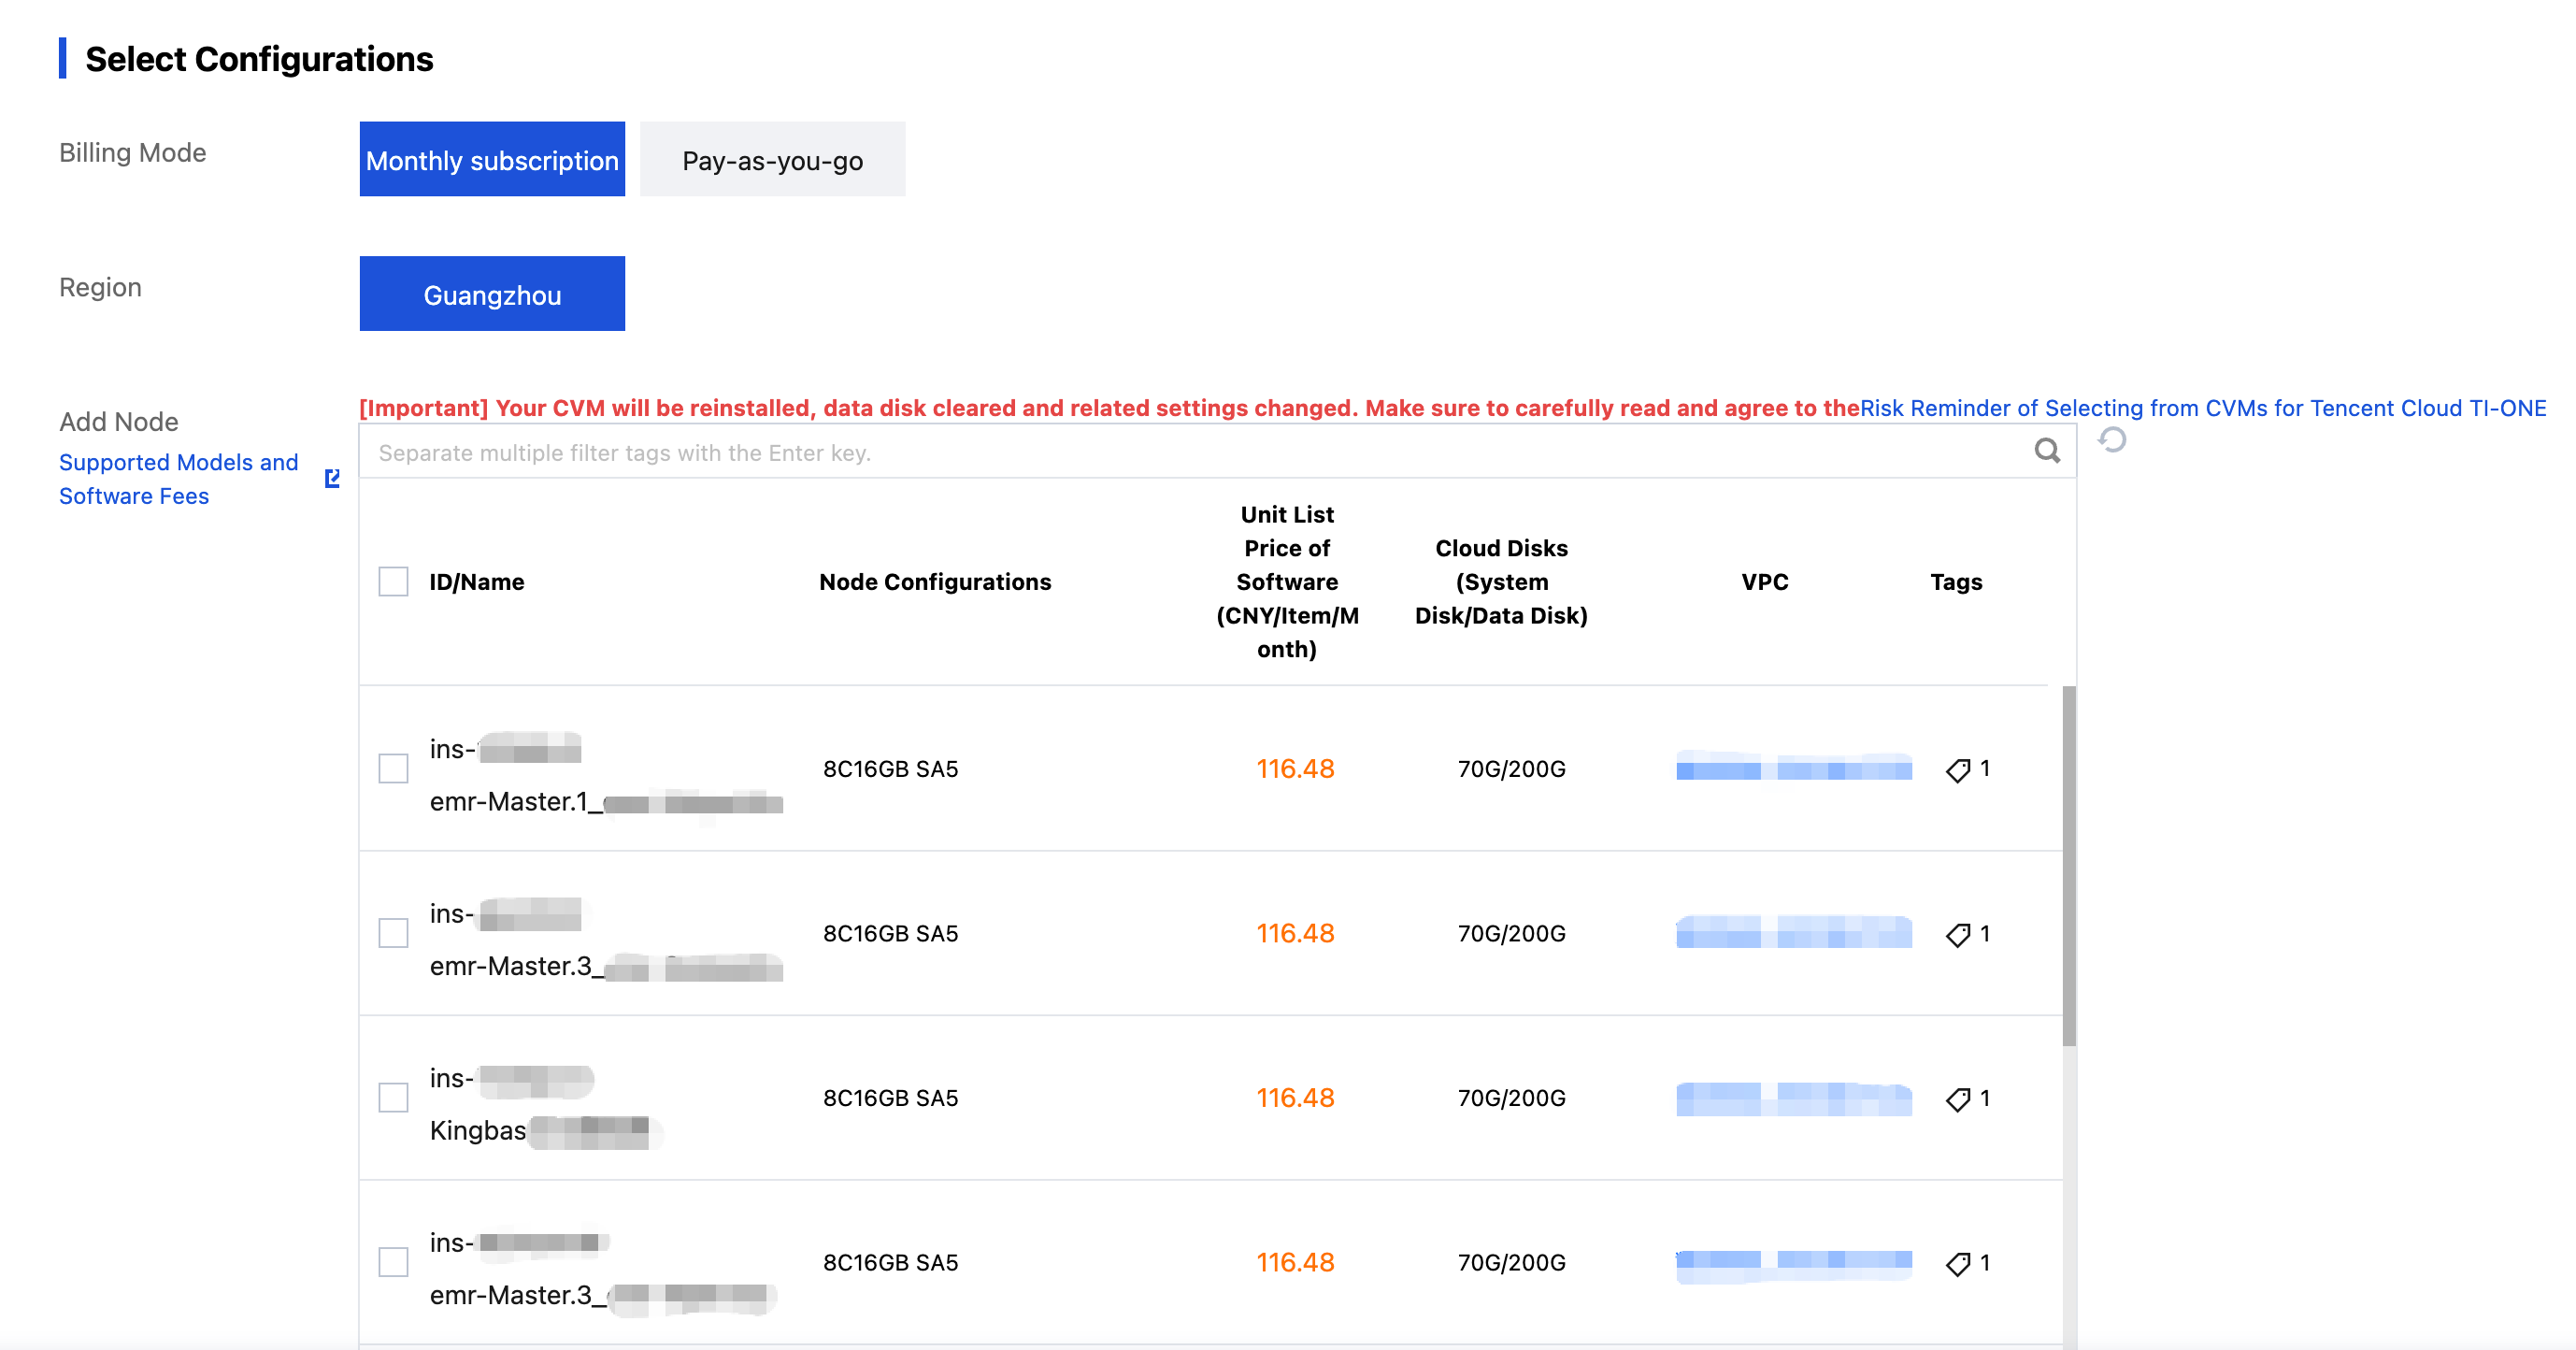
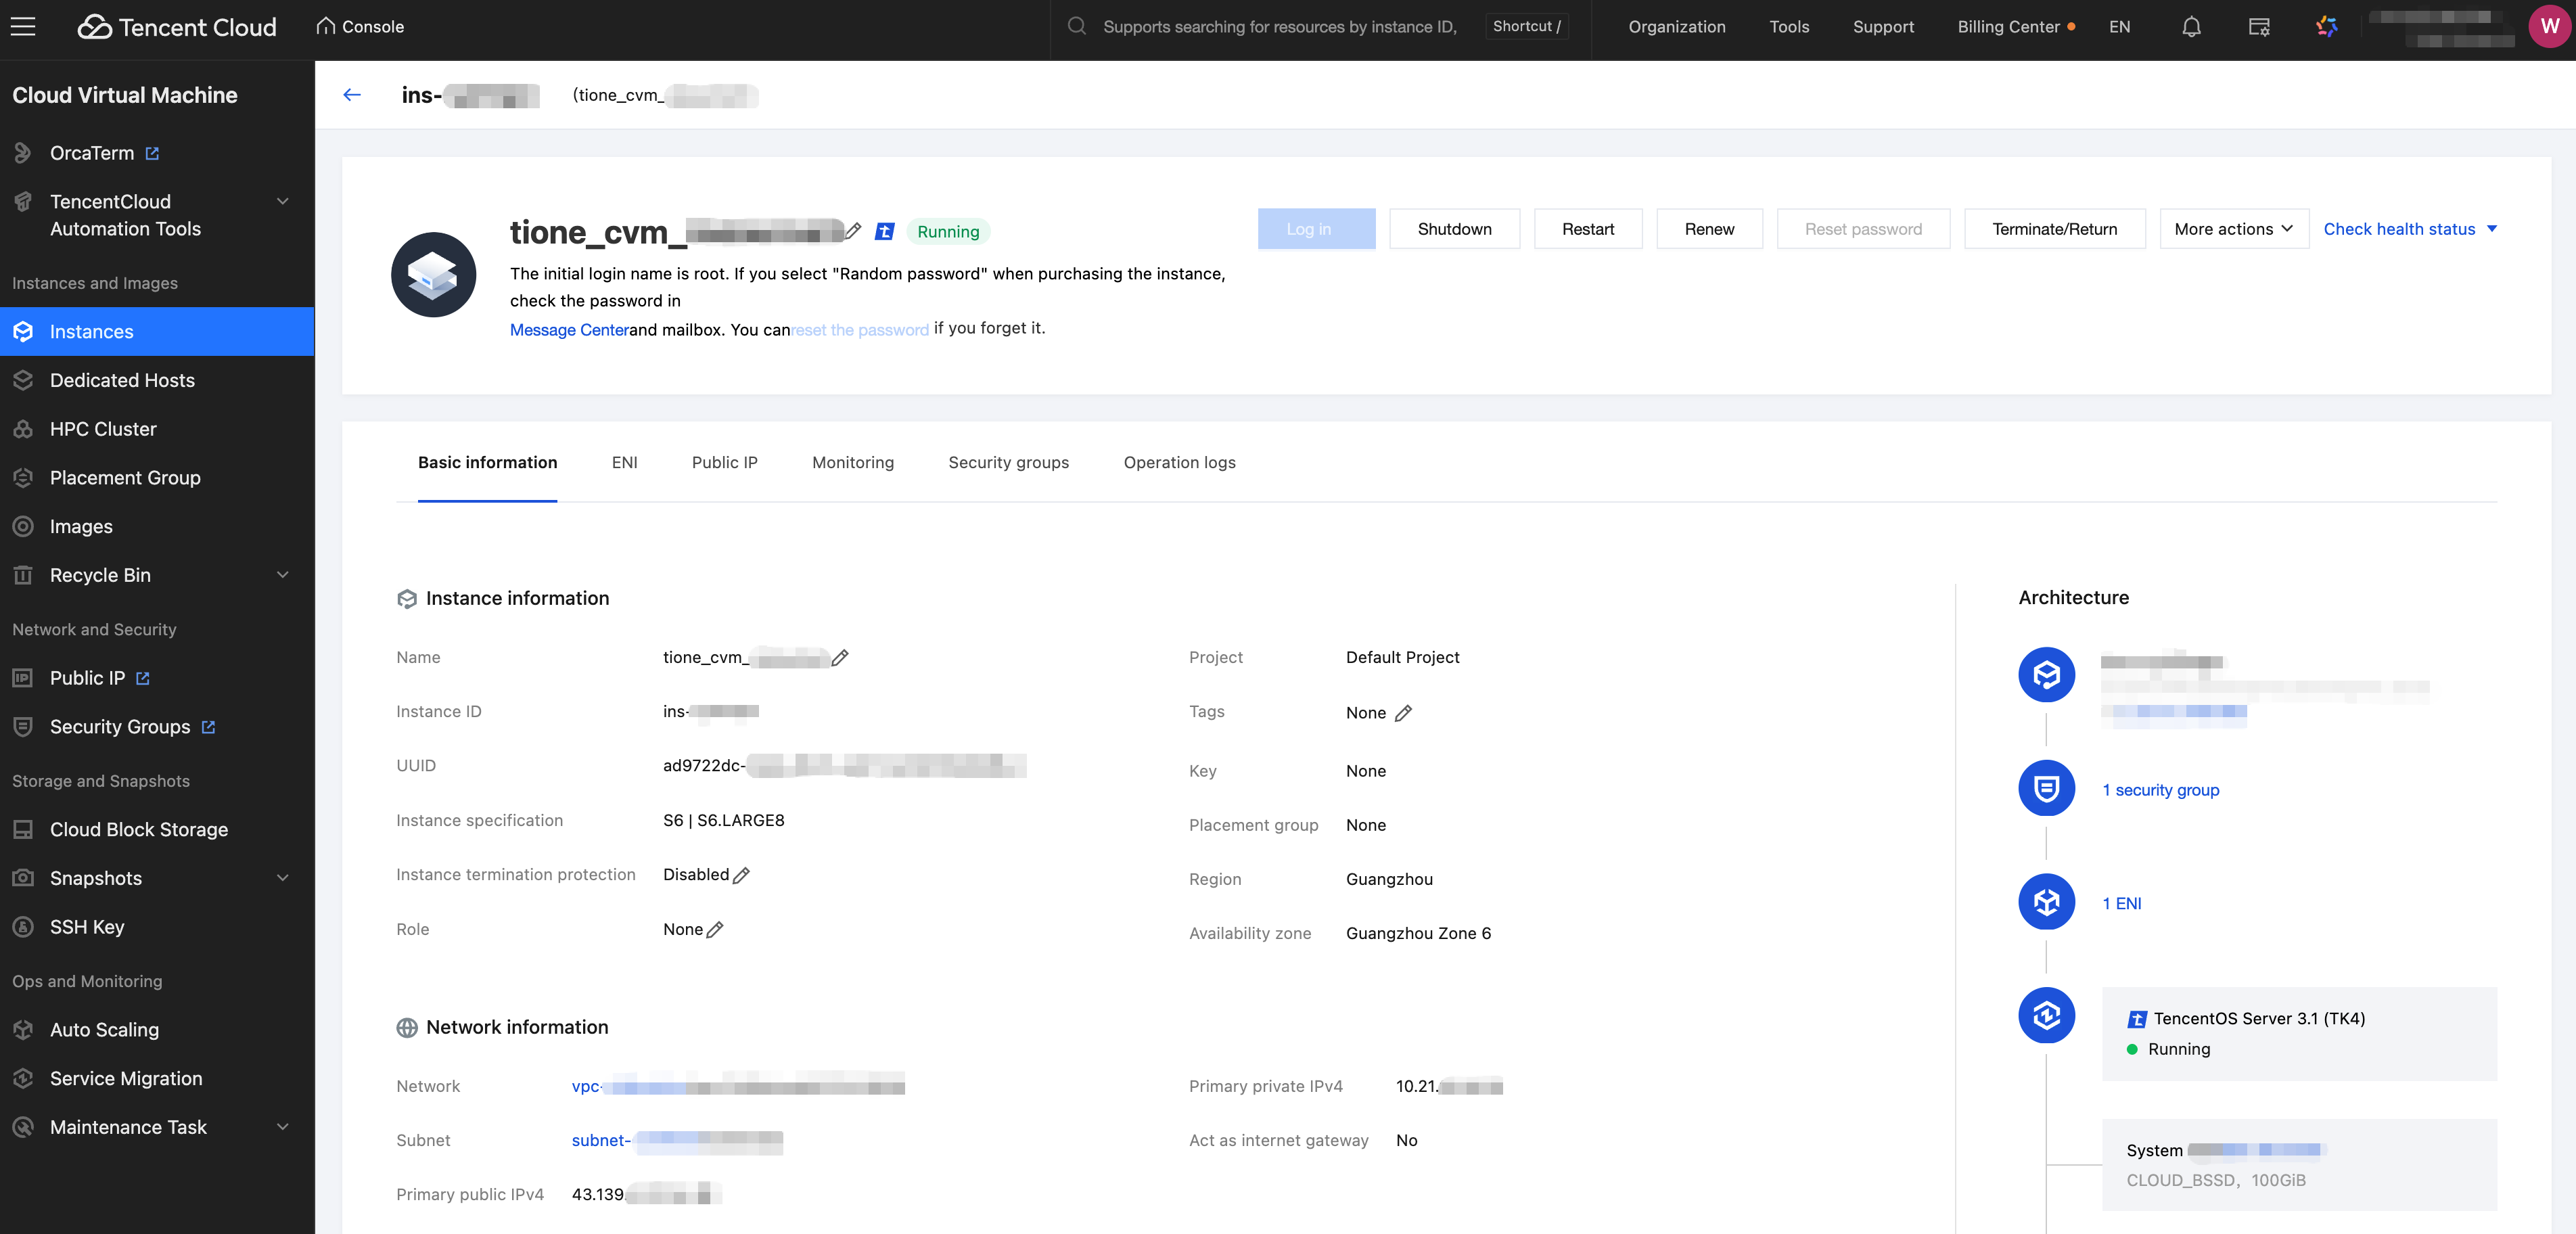
インスタンスIDをクリックするとインスタンス詳細ページに移動します。このインスタンスに対してログイン、シャットダウン、再起動、継続支払い、パスワードのリセット、破棄/返却などの操作を実行でき、このインスタンスの関連情報を表示します。
フィードバック