データサイエンス実践チュートリアル
ダウンロード
フォーカスモード
フォントサイズ
GPUリソースグループに基づく画像分類モデル開発のディープラーニング実践チュートリアル
説明:
本チュートリアルの前提条件は、データサイエンス機能がすでに有効化されていること、DLCのGPUリソースをすでに購入していること、そしてGPUカードを搭載した機械学習リソースグループを作成していることです。
基本情報
データ
本チュートリアルでは、CIFAR-10データセットを使用して操作を説明します。このデータセットは、カナダ高等研究機構(CIFAR)が提供するImage Analysisデータセットであり、深層学習とコンピュータビジョンの分野における研究や実験に広く使用されています。詳細は以下の通りです:
データ量:合計60,000枚のカラー画像です。
データ分布:そのうち50,000枚がトレーニング画像、10,000枚がテスト画像です。
画像サイズ:各画像のサイズは32×32ピクセルです。
カテゴリ:10個のクラスに分かれており、各クラスには6,000枚の画像があります。それぞれ飛行機、自動車、鳥、猫、鹿、犬、カエル、馬、船、トラックです。
特性:画像は明るく小さめで、初心者や迅速な実験に適しています。各カテゴリの画像は多様性があり、かつ一定の重複特性があるため、分類の難易度が高くなっています。
モデル
本チュートリアルでは、ResNet-18モデルを採用しています。これは、Microsoftの何愷明氏のチームが2015年に提案した軽量残差ネットワークであり、その核心は残差接続によって深層ネットワークの勾配消失/劣化問題を解決することです。パラメータ化層(畳み込み+全結合)は合計18層で、パラメータ数は約11.7Mです。画像分類、特徴抽出、軽量化のシナリオでよく使用される古典的なビジョンモデルです。
リソース
DLCのGPUリソースグループ:
20CU/1GPU [GN7-t4]
環境
spark3.5-tensorflow2.20-gpu-py311-cu124
Studioでコードを編集してモデルトレーニングを開始する
1. 第一步として、フォルダを作成し、データファイルをアップロードし、設定ファイルとipynbファイルを作成します。
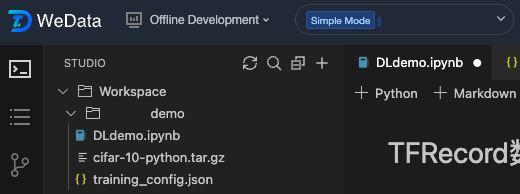
2. 第二步として、データの読み取りとデータ変換を行う関数を定義します。
import tensorflow as tfimport numpy as npimport osimport tarfileimport picklefrom typing import Dict, Anydef load_cifar10_from_local(local_path):ローカルのcifar-10-python.tar.gzファイルからCIFAR-10データセットを読み込みます。"""Load the CIFAR-10 dataset from the local cifar-10-python.tar.gz file."""if not os.path.exists(local_path):raise FileNotFoundError(f「CIFAR-10データセットファイルが見つかりません: {local_path}」)# 解凍ディレクトリ# Extraction directoryextract_dir = 'cifar-10-batches-py'# 解凍ディレクトリが存在しない場合は、ファイルを解凍します。# If the extraction directory does not exist, extract the file.if not os.path.exists(extract_dir):print("CIFAR-10データセットを解凍しています...Extract CIFAR-10")with tarfile.open(local_path, 'r:gz') as tar:tar.extractall()print("解凍完了!Extraction completed")else:print("CIFAR-10データセットは解凍済みのため、解凍手順をスキップします。The CIFAR-10 dataset has been extracted, skipping the extraction step.")return extract_dirdef unpickle(file):"""CIFAR-10のpickleファイルを読み込みます。""""""Read the CIFAR-10 pickle files"""with open(file, 'rb') as fo:dict = pickle.load(fo, encoding='bytes')return dictdef create_cifar10_tfrecord(local_path='cifar-10-python.tar.gz'):"""ローカルファイルからCIFAR-10データセットのTFRecordファイルを作成します。""""""Create TFRecord files for the CIFAR-10 dataset from local files."""# ローカルファイルからデータセットを読み込みます。# Load the dataset from local files.cifar_dir = load_cifar10_from_local(local_path)# 学習データを読み込みます。# Load training datax_train = []y_train = []# 5つの学習バッチを読み込みます。# Load 5 train batchfor i in range(1, 6):batch_file = os.path.join(cifar_dir, f'data_batch_{i}')dict = unpickle(batch_file)# 画像データとTagを取得します。# Get data and labeldata = dict[b'data']labels = dict[b'labels']x_train.append(data)y_train.extend(labels)x_train = np.concatenate(x_train, axis=0)y_train = np.array(y_train)# テストデータを読み込みます。# Load test datatest_file = os.path.join(cifar_dir, 'test_batch')dict_test = unpickle(test_file)x_test = dict_test[b'data']y_test = np.array(dict_test[b'labels'])# 画像形状を32x32x3にリシェイプします。# Reshape picture to 32x32x3x_train = x_train.reshape(-1, 3, 32, 32).transpose(0, 2, 3, 1)x_test = x_test.reshape(-1, 3, 32, 32).transpose(0, 2, 3, 1)# 出力ディレクトリを作成します。# Create output directoryos.makedirs('./tfrecords', exist_ok=True)def _bytes_feature(value):"""バイト特徴に変換します。""""""Convert to byte feature"""if isinstance(value, type(tf.constant(0))):value = value.numpy()return tf.train.Feature(bytes_list=tf.train.BytesList(value=[value]))def _int64_feature(value):"""整数特徴に変換します。""""""Convert to Int feature"""return tf.train.Feature(int64_list=tf.train.Int64List(value=[value]))# 学習セットのTFRecordを書き込みます。# Write trainset TFRecordwith tf.io.TFRecordWriter('./tfrecords/cifar10_train.tfrecord') as writer:for i in range(len(x_train)):image = x_train[i]label = y_train[i]# 画像データがuint8型であることを確認します。# Make sure the image data type is uint8.image = image.astype(np.uint8)feature = {'image': _bytes_feature(tf.compat.as_bytes(image.tobytes())),'label': _int64_feature(label),'height': _int64_feature(32),'width': _int64_feature(32),'depth': _int64_feature(3)}example = tf.train.Example(features=tf.train.Features(feature=feature))writer.write(example.SerializeToString())# 検証セットのTFRecordを書き込みます。# Write valset TFRecordwith tf.io.TFRecordWriter('./tfrecords/cifar10_val.tfrecord') as writer:for i in range(len(x_test)):image = x_test[i]label = y_test[i]image = image.astype(np.uint8)feature = {'image': _bytes_feature(tf.compat.as_bytes(image.tobytes())),'label': _int64_feature(label),'height': _int64_feature(32),'width': _int64_feature(32),'depth': _int64_feature(3)}example = tf.train.Example(features=tf.train.Features(feature=feature))writer.write(example.SerializeToString())print(f"TFRecordファイルの作成が完了しました: 学習サンプル {len(x_train)}, 検証サンプル {len(x_test)}")return len(x_train), len(x_test)def parse_tfrecord_fn(example_proto, config: Dict[str, Any], is_training: bool = True):"""TFRecordサンプルを解析します。""""""Parse TFRecord examples"""feature_description = {'image': tf.io.FixedLenFeature([], tf.string),'label': tf.io.FixedLenFeature([], tf.int64),'height': tf.io.FixedLenFeature([], tf.int64),'width': tf.io.FixedLenFeature([], tf.int64),'depth': tf.io.FixedLenFeature([], tf.int64)}example = tf.io.parse_single_example(example_proto, feature_description)# 画像データを解析します。# Parse image dataimage = tf.io.decode_raw(example['image'], tf.uint8)image = tf.reshape(image, [32, 32, 3])image = tf.cast(image, tf.float32) / 255.0# データ拡張# Data augmentationif is_training and config.get('data_augmentation', True):if config.get('horizontal_flip', True):image = tf.image.random_flip_left_right(image)if config.get('brightness_delta', 0) > 0:image = tf.image.random_brightness(image, config['brightness_delta'])if config.get('contrast_range'):image = tf.image.random_contrast(image,config['contrast_range'][0],config['contrast_range'][1])# 標準化処理# Normalizationimage = (image - tf.constant([0.4914, 0.4822, 0.4465])) / tf.constant([0.2023, 0.1994, 0.2010])label = tf.cast(example['label'], tf.int32)return image, labeldef create_dataset(config: Dict[str, Any], is_training: bool = True):"""TensorFlowデータセットパイプラインを作成します。""""""Create TensorFlow dataset pipe"""tfrecord_path = config['train_tfrecord_path'] if is_training else config['val_tfrecord_path']# TFRecordファイルが存在するかどうかを確認します。# Check TFRecord fileif not os.path.exists(tfrecord_path):raise FileNotFoundError(f"TFRecordファイルが存在しません: {tfrecord_path}")dataset = tf.data.TFRecordDataset(tfrecord_path)dataset = dataset.map(lambda x: parse_tfrecord_fn(x, config, is_training),num_parallel_calls=tf.data.experimental.AUTOTUNE)if is_training:dataset = dataset.shuffle(buffer_size=10000)dataset = dataset.batch(config.get('batch_size', 128))dataset = dataset.prefetch(tf.data.experimental.AUTOTUNE)return dataset
3. 第三步では、ResNetモデルを定義します。
import tensorflow as tffrom tensorflow.keras import layers, Modelclass BasicBlock(layers.Layer):"""ResNetの基本残差ブロック""""""ResNet Basic Residual Block"""def __init__(self, filter_num, stride=1):super(BasicBlock, self).__init__()self.conv1 = layers.Conv2D(filter_num, (3, 3), strides=stride,padding='same', use_bias=False)self.bn1 = layers.BatchNormalization()self.relu = layers.ReLU()self.conv2 = layers.Conv2D(filter_num, (3, 3), strides=1,padding='same', use_bias=False)self.bn2 = layers.BatchNormalization()# ショートカット接続処理# Connection Handlingif stride != 1:self.downsample = tf.keras.Sequential([layers.Conv2D(filter_num, (1, 1), strides=stride, use_bias=False),layers.BatchNormalization()])else:self.downsample = lambda x: xdef call(self, inputs, training=None):residual = inputsx = self.conv1(inputs)x = self.bn1(x, training=training)x = self.relu(x)x = self.conv2(x)x = self.bn2(x, training=training)identity = self.downsample(residual)output = tf.nn.relu(x + identity)return outputclass ResNet(Model):"""ResNetモデル""""""ResNet model"""def __init__(self, layer_dims, num_classes=10):super(ResNet, self).__init__()# 前処理層# Preprocessing Layerself.stem = tf.keras.Sequential([layers.Conv2D(64, (3, 3), strides=1, padding='same', use_bias=False),layers.BatchNormalization(),layers.ReLU(),])# 残差層を構築します。# Construct the Residual Layerself.layer1 = self._build_resblock(64, layer_dims[0], stride=1)self.layer2 = self._build_resblock(128, layer_dims[1], stride=2)self.layer3 = self._build_resblock(256, layer_dims[2], stride=2)self.layer4 = self._build_resblock(512, layer_dims[3], stride=2)# 分類器# Classifierself.avgpool = layers.GlobalAveragePooling2D()self.fc = layers.Dense(num_classes)def _build_resblock(self, filter_num, blocks, stride=1):"""残差ブロックシーケンスを構築します。""""""Construct the sequence of residual blocks"""res_blocks = tf.keras.Sequential()res_blocks.add(BasicBlock(filter_num, stride))for _ in range(1, blocks):res_blocks.add(BasicBlock(filter_num, stride=1))return res_blocksdef call(self, inputs, training=None):x = self.stem(inputs, training=training)x = self.layer1(x, training=training)x = self.layer2(x, training=training)x = self.layer3(x, training=training)x = self.layer4(x, training=training)x = self.avgpool(x)x = self.fc(x)return xdef resnet18(num_classes=10):"""ResNet-18モデルを作成します。""""""Construct ResNet-18 model"""return ResNet([2, 2, 2, 2], num_classes)
4. 第四步では、MLFlowのトレーニングフローを定義します。
import mlflowimport mlflow.tensorflowimport jsonimport matplotlib.pyplot as pltfrom datetime import datetimeclass CIFAR10Trainer:def __init__(self, config_path='config/training_config.json'):self.config = self.load_config(config_path)self.setup_mlflow()self.model = Noneself.optimizer = Nonedef load_config(self, config_path):"""JSONファイルからハイパーパラメータ設定を読み込みます。""""""Load hyperparam config from JSON file"""with open(config_path, 'r') as f:return json.load(f)def setup_mlflow(self):"""MLflow実験追跡を設定します。""""""Set MLflow experiment tracking"""mlflow.set_tracking_uri("30.22.40.186:5000")mlflow.set_experiment("cifar10-resnet-tf2.2-local")def create_optimizer(self):"""オプティマイザを作成します。""""""Construct optimizer"""if self.config['optimizer'] == 'adam':return tf.keras.optimizers.Adam(learning_rate=self.config['learning_rate'])else:return tf.keras.optimizers.SGD(learning_rate=self.config['learning_rate'],momentum=self.config.get('momentum', 0.9))def train(self):"""モデルを学習します。""""""Training model"""# TFRecordファイルを作成します(存在しない場合)。# Construct TFRecord file(if not exist)if not os.path.exists(self.config['train_tfrecord_path']):print("TFRecordファイルを作成します...Construct TFRecord file...")try:train_samples, test_samples = create_cifar10_tfrecord(self.config['cifar10_local_path'])print(f"正常に読み込みました: 学習サンプル {train_samples}, テストサンプル {test_samples}.Load success: {train_samples},{test_samples}")except FileNotFoundError as e:print(f"エラー: {e} error: {e}")print("cifar-10-python.tar.gzファイルが現在のディレクトリに存在することを確認してください。Please make sure cifar-10-python.tar.gz exist in current directory")returnwith mlflow.start_run():# ハイパーパラメータを記録する# Log hyperparammlflow.log_params(self.config)mlflow.log_param("framework", "TensorFlow 2.2")mlflow.log_param("dataset", "CIFAR-10")mlflow.log_param("data_source", "local_file")mlflow.log_param("start_time", datetime.now().isoformat())# データセットを作成します。# Construct datasettrain_dataset = create_dataset(self.config, is_training=True)val_dataset = create_dataset(self.config, is_training=False)# モデルとオプティマイザを作成します。# Construct model and optimizerself.model = resnet18(num_classes=self.config['num_classes'])self.optimizer = self.create_optimizer()# モデルをコンパイルします。# Compile modelself.model.compile(optimizer=self.optimizer,loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),metrics=['accuracy'])# モデルを構築し、概要を表示します。# Construct model and show abstractself.model.build((None, self.config['image_size'],self.config['image_size'], 3))self.model.summary()# 学習パラメータ# train paramtrain_loss = tf.keras.metrics.Mean(name='train_loss')train_accuracy = tf.keras.metrics.SparseCategoricalAccuracy(name='train_accuracy')val_loss = tf.keras.metrics.Mean(name='val_loss')val_accuracy = tf.keras.metrics.SparseCategoricalAccuracy(name='val_accuracy')@tf.functiondef train_step(images, labels):with tf.GradientTape() as tape:predictions = self.model(images, training=True)loss = tf.keras.losses.sparse_categorical_crossentropy(labels, predictions, from_logits=True)gradients = tape.gradient(loss, self.model.trainable_variables)self.optimizer.apply_gradients(zip(gradients, self.model.trainable_variables))train_loss(loss)train_accuracy(labels, predictions)return lossbest_val_acc = 0.0train_losses = []train_accs = []val_losses = []val_accs = []print("学習を開始します...Start training")for epoch in range(self.config['epochs']):# 指標をリセットします。# Reset metricstrain_loss.reset_state()train_accuracy.reset_state()val_loss.reset_state()val_accuracy.reset_state()# 学習段階# Training stepfor batch, (images, labels) in enumerate(train_dataset):loss = train_step(images, labels)if batch % 50 == 0:#print(f'Epoch {epoch+1}, Batch {batch}, Loss: {loss.numpy():.4f}')print(f'Epoch {epoch+1}, Batch {batch}, Loss: {tf.reduce_mean(loss).numpy():.4f}')# 検証段階# Validate stepfor images, labels in val_dataset:predictions = self.model(images, training=False)v_loss = tf.keras.losses.sparse_categorical_crossentropy(labels, predictions, from_logits=True)val_loss(v_loss)val_accuracy(labels, predictions)# epoch指標を計算します。# Calculate epoch metricepoch_train_loss = train_loss.result().numpy()epoch_train_acc = train_accuracy.result().numpy()epoch_val_loss = val_loss.result().numpy()epoch_val_acc = val_accuracy.result().numpy()# MLflowに記録します。# Log to MLflowmlflow.log_metric("train_loss", epoch_train_loss, step=epoch)mlflow.log_metric("train_accuracy", epoch_train_acc, step=epoch)mlflow.log_metric("val_loss", epoch_val_loss, step=epoch)mlflow.log_metric("val_accuracy", epoch_val_acc, step=epoch)mlflow.log_metric("learning_rate",self.optimizer.learning_rate.numpy(), step=epoch)# 学習履歴を保存します。# Save training historytrain_losses.append(epoch_train_loss)train_accs.append(epoch_train_acc)val_losses.append(epoch_val_loss)val_accs.append(epoch_val_acc)print(f'Epoch {epoch+1}/{self.config["epochs"]}: 'f'Train Loss: {epoch_train_loss:.4f}, Train Acc: {epoch_train_acc*100:.2f}%, 'f'Val Loss: {epoch_val_loss:.4f}, Val Acc: {epoch_val_acc*100:.2f}%')# 最適なモデルを保存します。# Save best modelif epoch_val_acc > best_val_acc:best_val_acc = epoch_val_accmlflow.tensorflow.log_model(self.model, "best_model")print(f"新しい最適なモデルが保存されました。検証精度: {epoch_val_acc*100:.2f}%The new best model is saved, validate accuracy: {epoch_val_acc*100:.2f}%")# 最終結果を記録します。# Log final resultmlflow.log_metric("best_val_accuracy", best_val_acc)mlflow.tensorflow.log_model(self.model, "final_model")# 学習曲線を描画します。# Plot the training curves。self.plot_training_history(train_losses, train_accs, val_losses, val_accs)print(f"学習が完了しました!最適な検証精度: {best_val_acc*100:.2f}%Training complete!The best validate accuracy: {best_val_acc*100:.2f}%")def plot_training_history(self, train_losses, train_accs, val_losses, val_accs):"""学習履歴曲線を描画します。""""""Plot the training history curves"""fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(15, 5))# 損失曲線# Loss curvesax1.plot(train_losses, label='Train Loss')ax1.plot(val_losses, label='Val Loss')ax1.set_title('Training and Validation Loss')ax1.set_xlabel('Epoch')ax1.set_ylabel('Loss')ax1.legend()ax1.grid(True)# 精度曲線# Accuracy curvesax2.plot(train_accs, label='Train Accuracy')ax2.plot(val_accs, label='Val Accuracy')ax2.set_title('Training and Validation Accuracy')ax2.set_xlabel('Epoch')ax2.set_ylabel('Accuracy')ax2.legend()ax2.grid(True)plt.tight_layout()plt.savefig('training_history.png')mlflow.log_artifact('training_history.png')plt.show()
5. 第五段階として、学習用のmainコードを作成します。
# トレーナーを初期化し、training_config.jsonから学習ハイパーパラメータを読み取ります。# Initial trainer, and read training hyperparam from training_config.jsontrainer = CIFAR10Trainer('training_config.json')# 学習を開始します。trainer.train()# MLflow UIを起動します(ターミナルで実行します)。print("学習が完了しました!実験管理で実行結果を確認してください。Training complete!Please check task result")
6. 第六段階として、設定したJSONファイルで学習ハイパーパラメータを定義します。
{"model_name": "resnet18","num_classes": 10,"batch_size": 128,"learning_rate": 0.001,"epochs": 5,"optimizer": "adam","weight_decay": 0.0001,"momentum": 0.9,"image_size": 32,"train_tfrecord_path": "./tfrecords/cifar10_train.tfrecord","val_tfrecord_path": "./tfrecords/cifar10_val.tfrecord","data_augmentation": true,"horizontal_flip": true,"brightness_delta": 0.1,"contrast_range": [0.9, 1.1],"cifar10_local_path": "cifar-10-python.tar.gz","local_path": "cifar-10-python.tar.gz"}
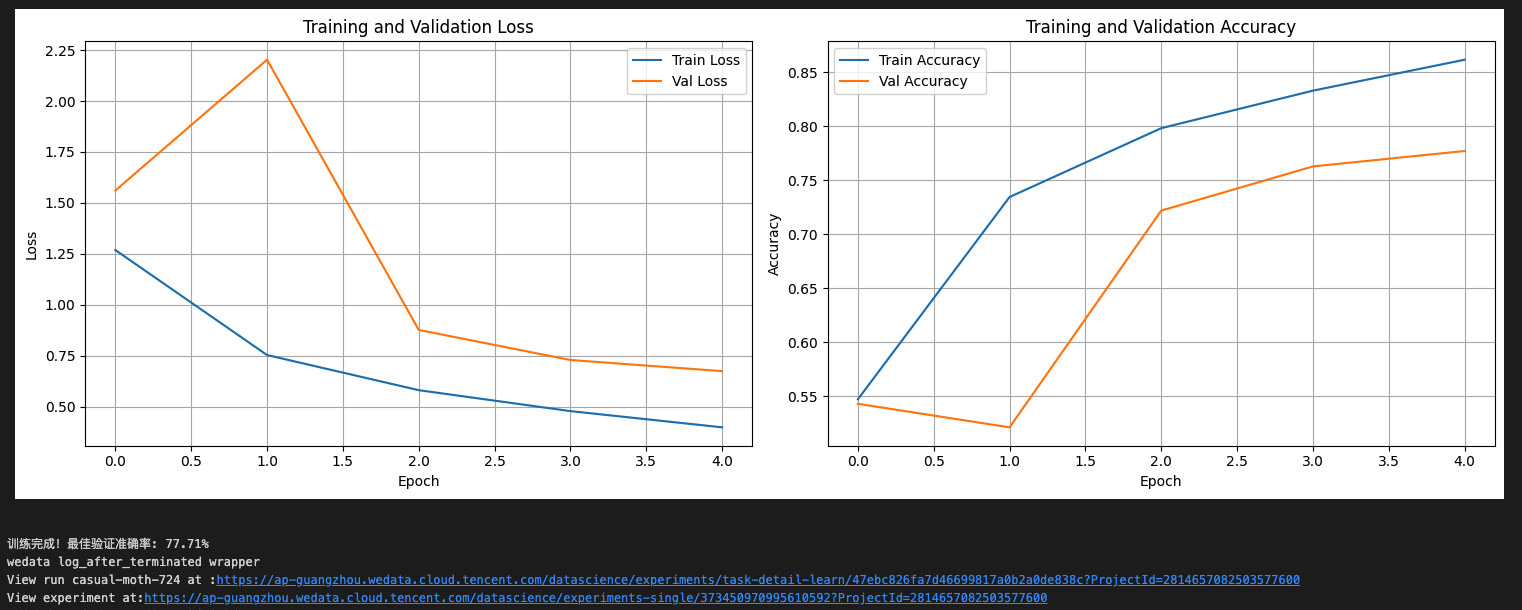
7. 最後に、各コードを順番に実行し、出力結果を確認します。学習が完了し、結果が正常に報告されました。
実験管理で実行結果を確認する
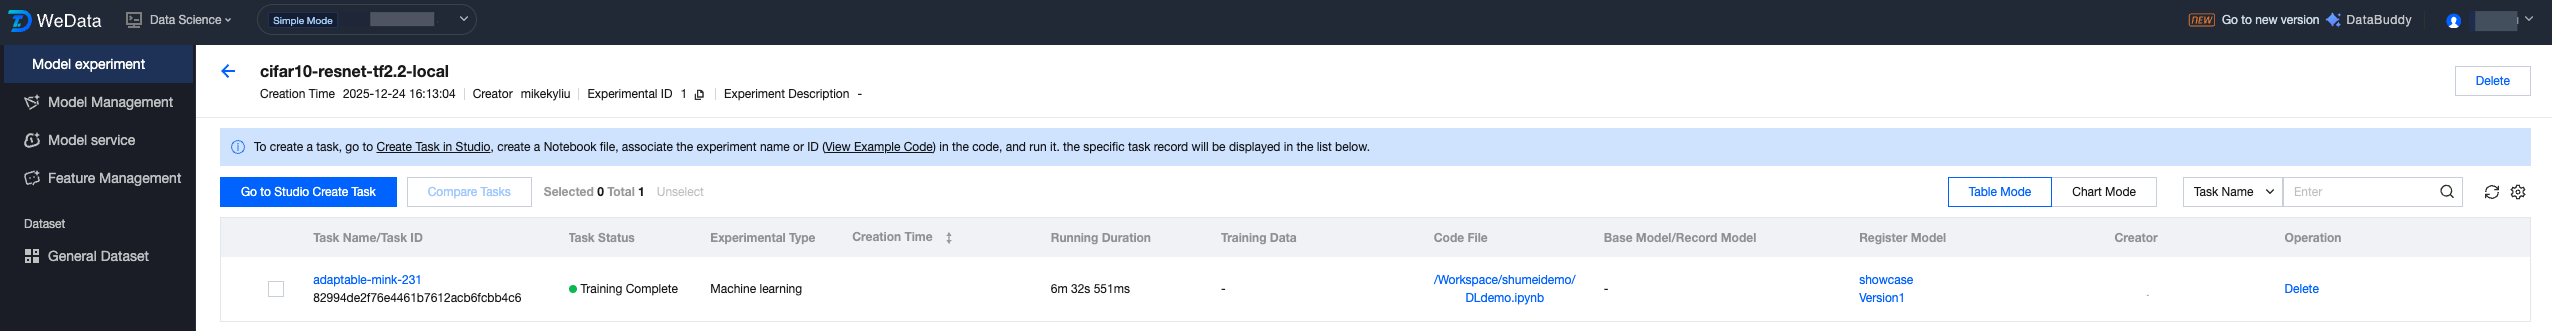
1. データサイエンスの実験管理モジュールに入ると、先ほどコードで実行した記録が実験管理で確認できるようになっています。画面には、実験名、実験タイプ、実験の説明、作成時間、担当者、操作項目などの情報が表示されます。

2. 実験名をクリックすると、実行記録ページに入り、先ほど報告されたタスク記録を確認できます。画面には、タスク名、タスク状態、作成時間、継続時間、コードファイル、登録モデルなどの情報が表示されます。
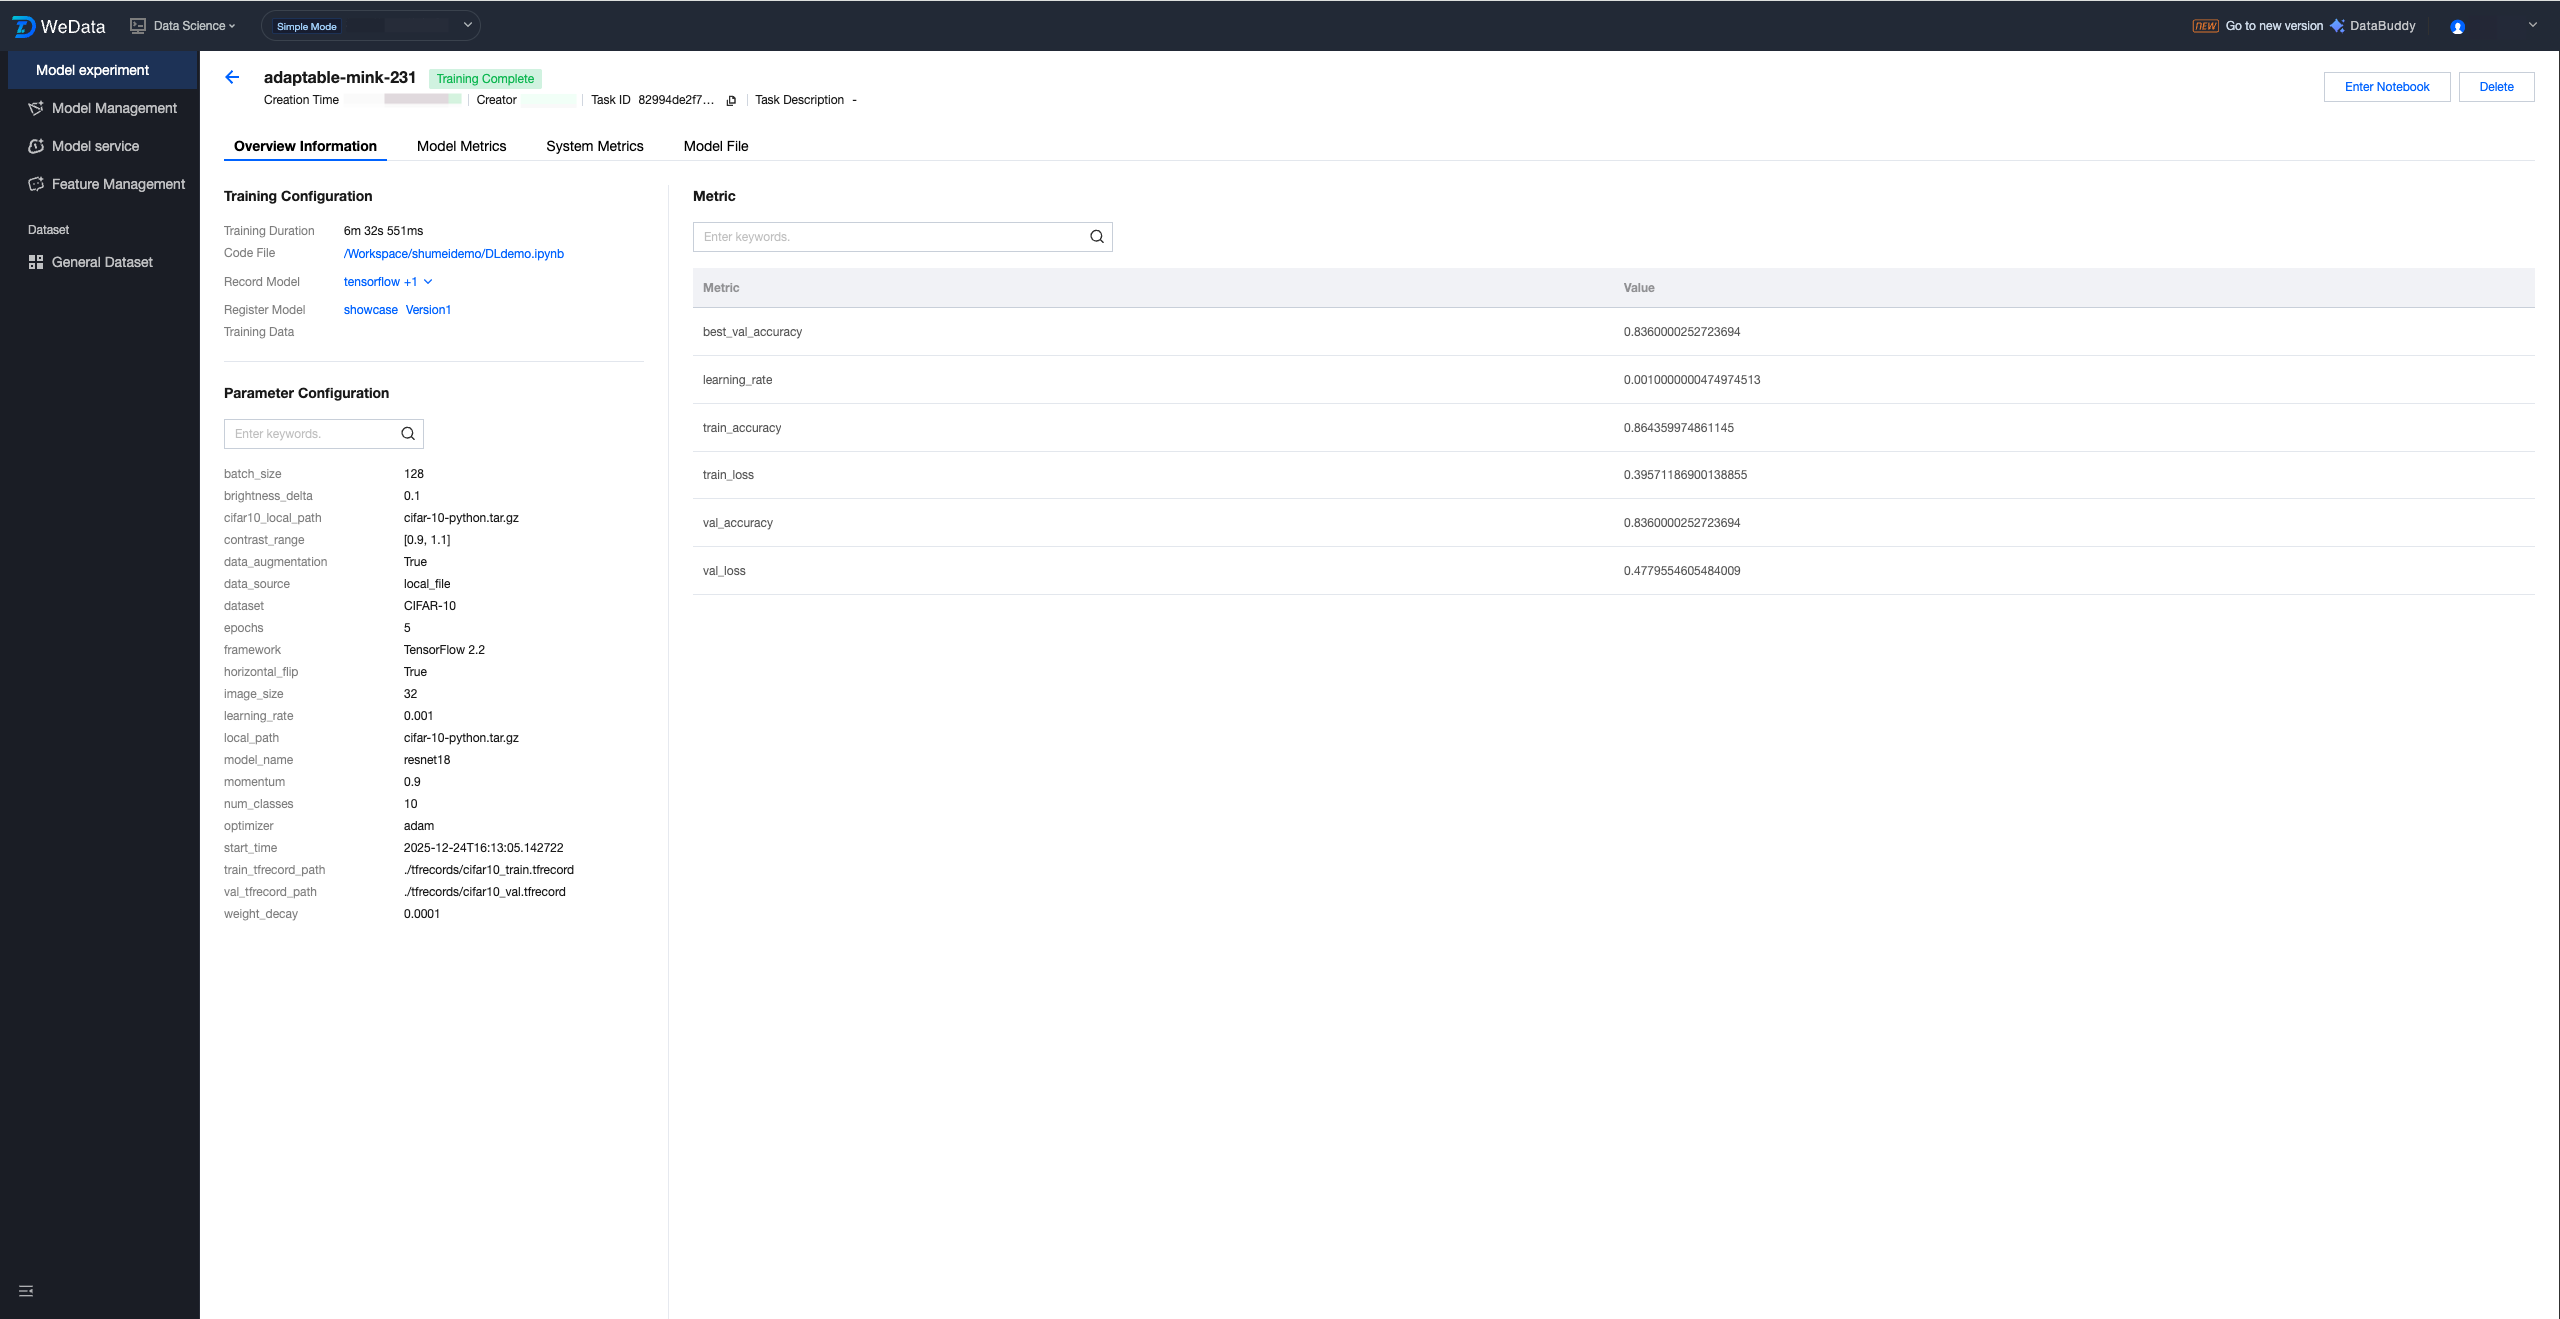
3. タスク名をクリックすると、実行詳細の概要ページに入り、報告された学習ハイパーパラメータ、モデル指標などを確認できます。
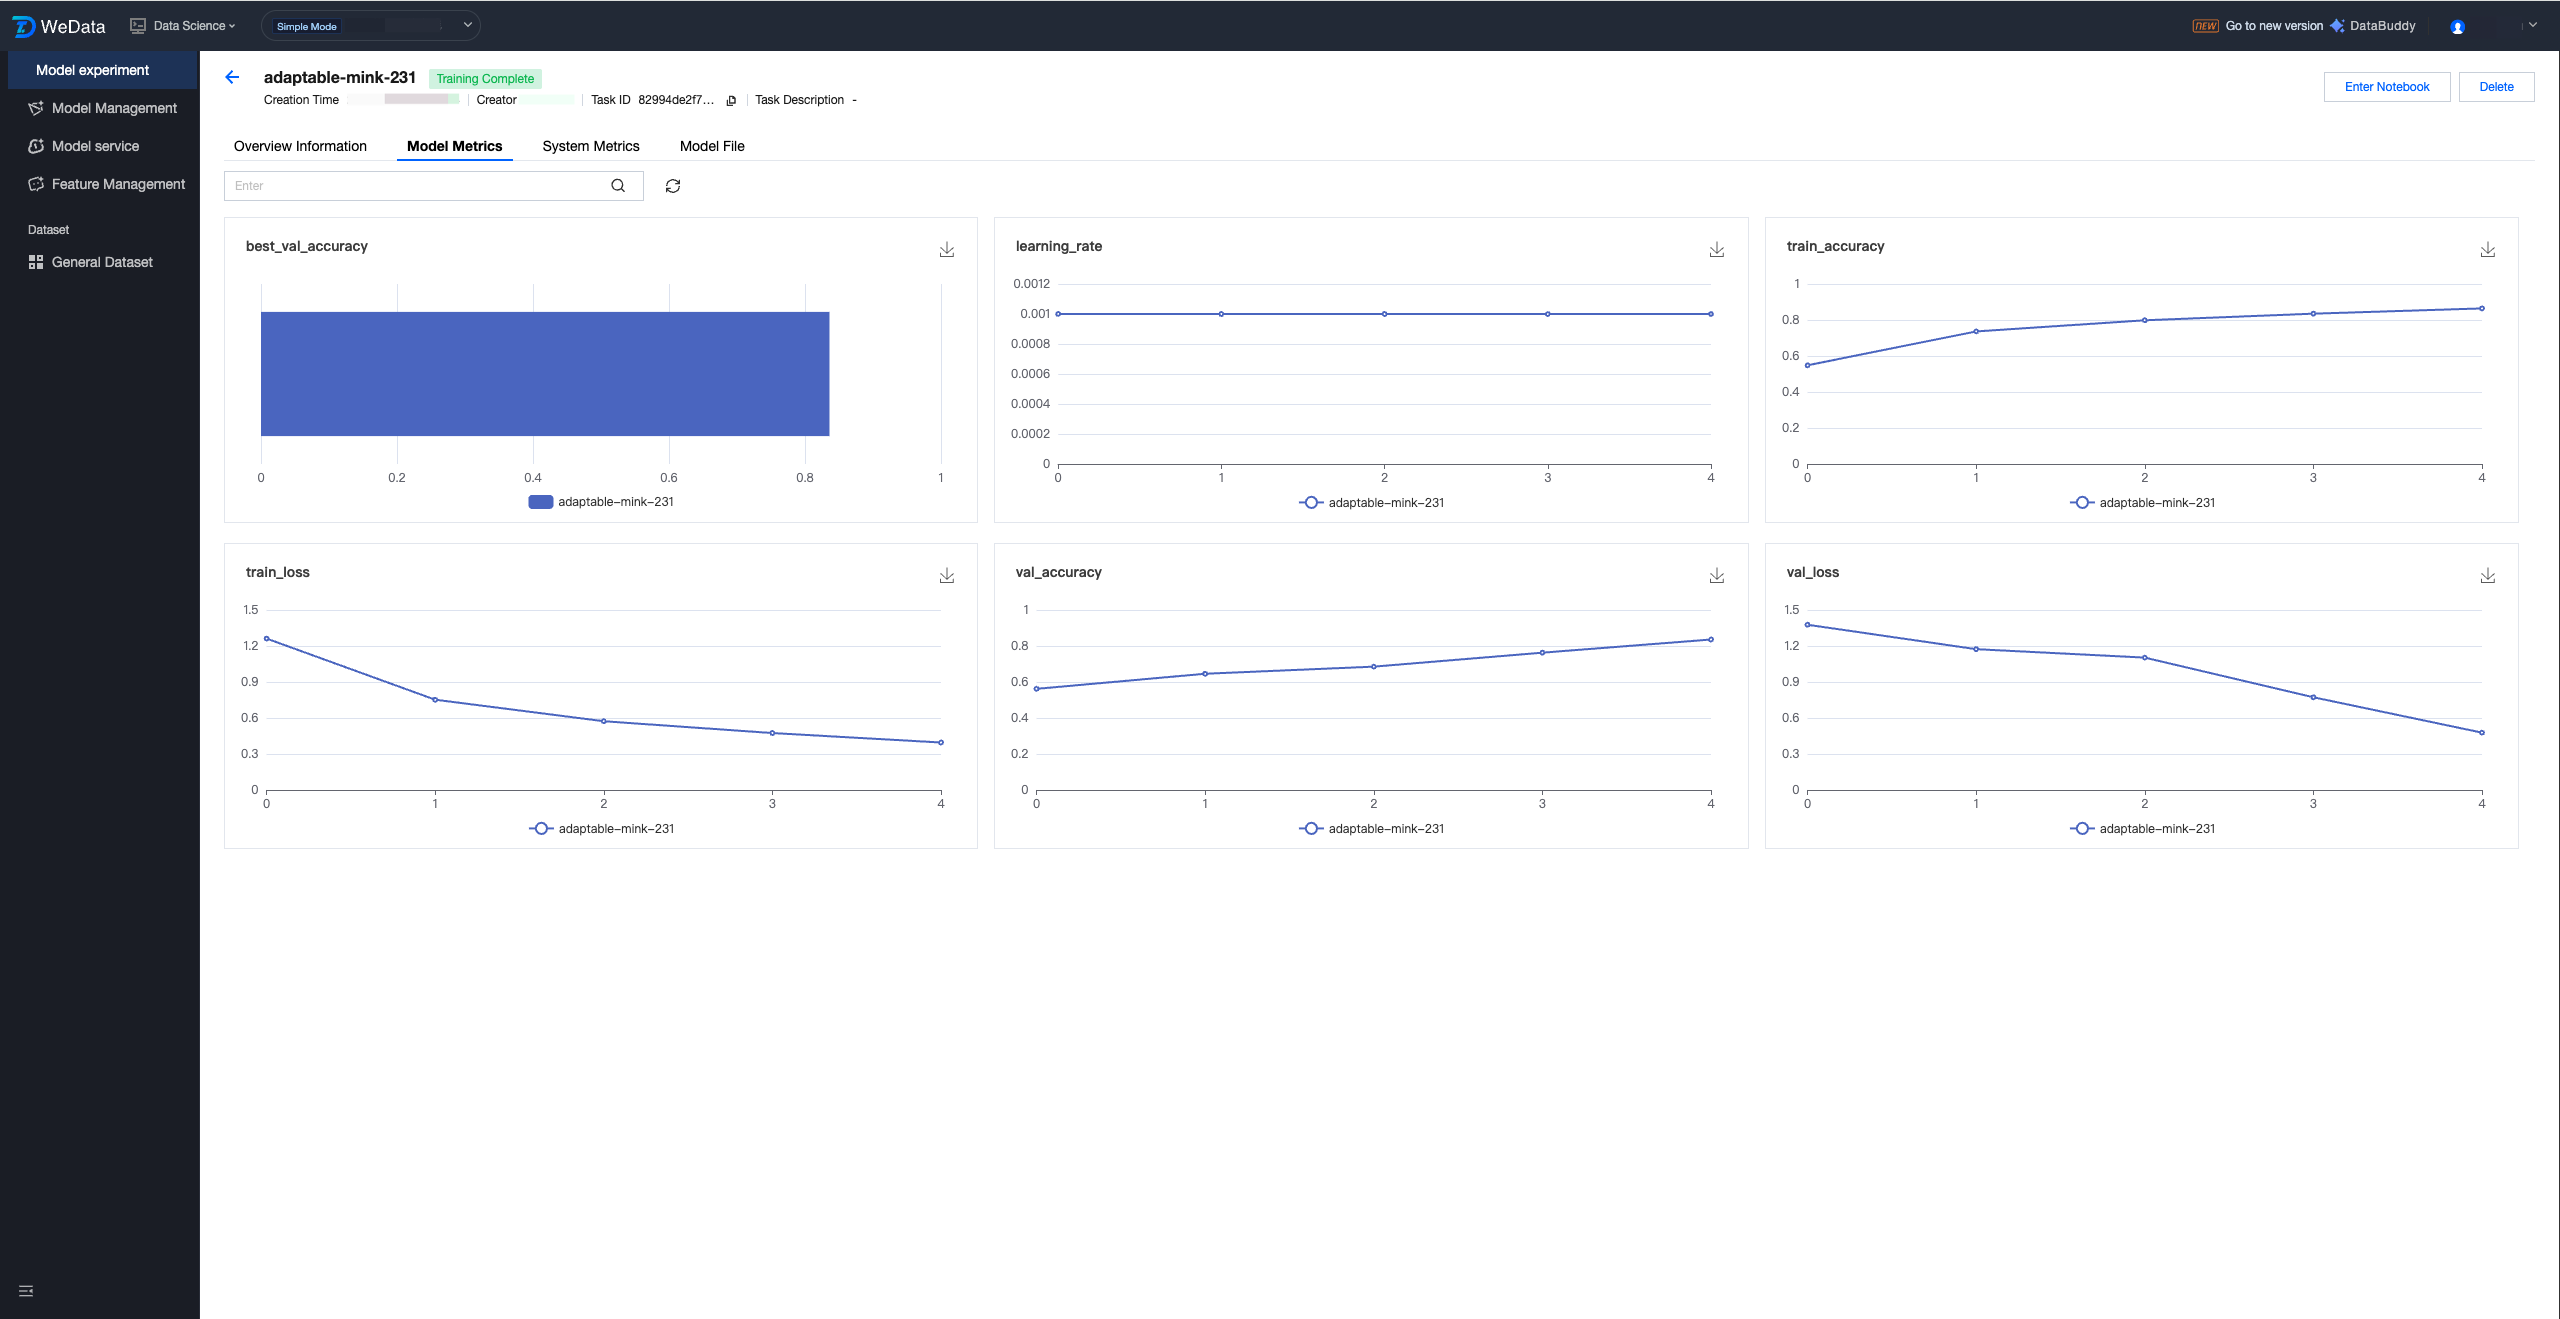
4. モデル指標の記録を表示します。
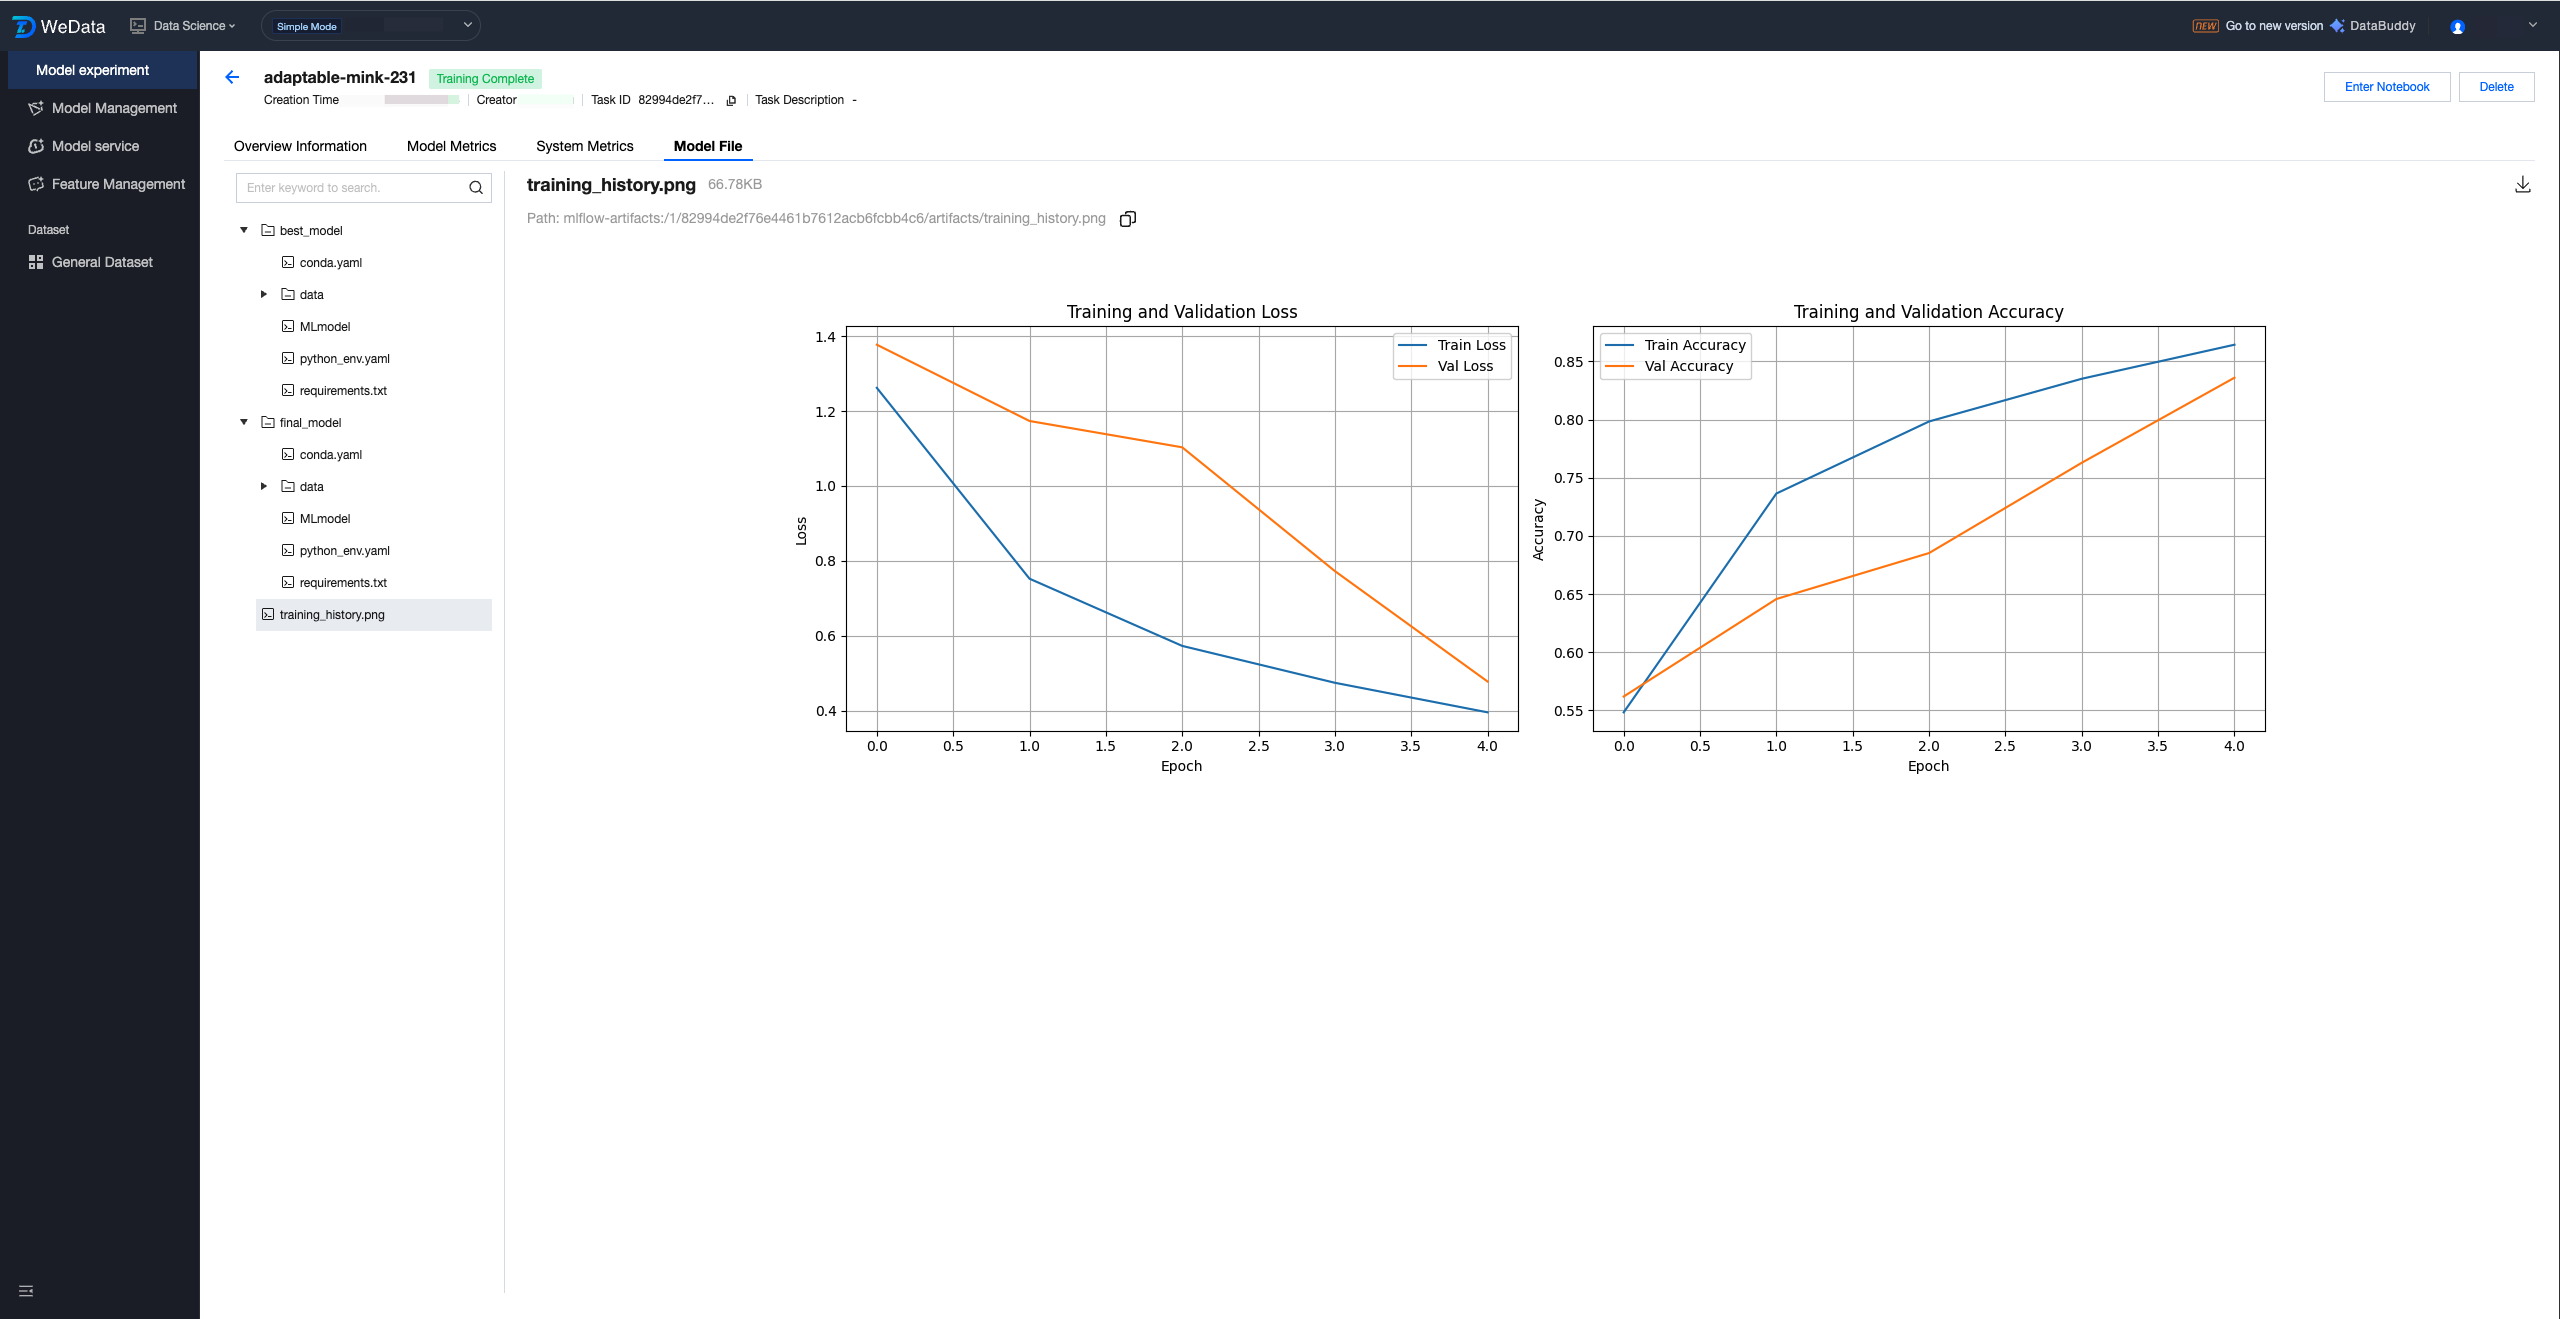
5. モデルファイル、および報告された画像などの他の記録を表示します。
モデル管理で登録済みモデルを確認する
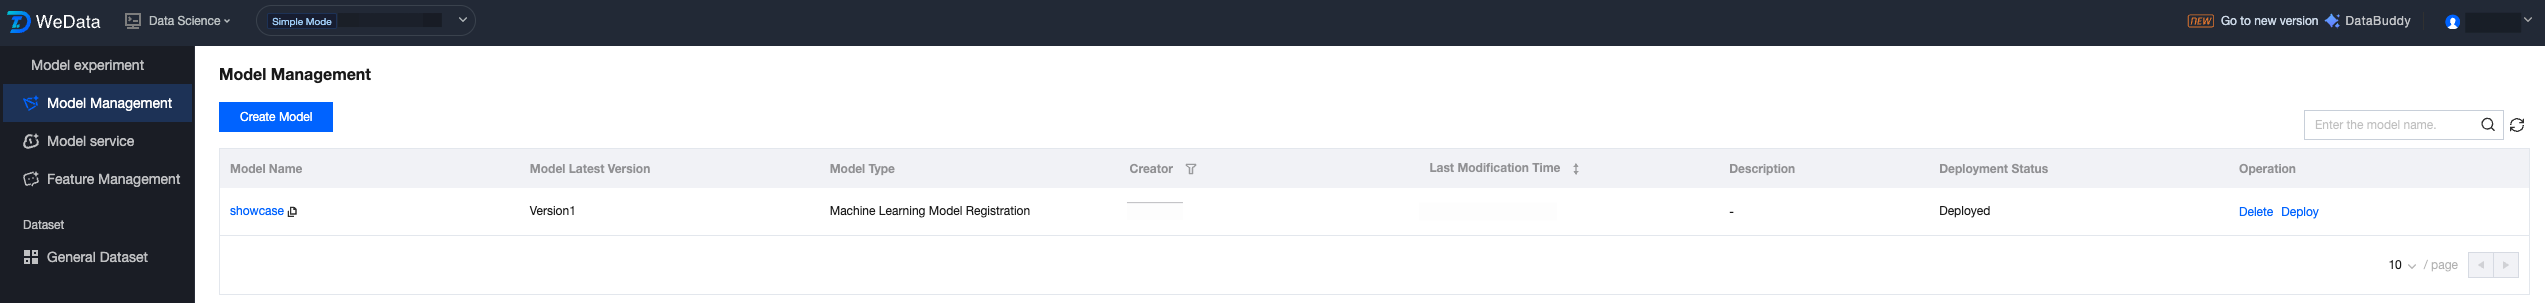
1. モデル管理ページをクリックすると、記録されたモデルを確認できます。
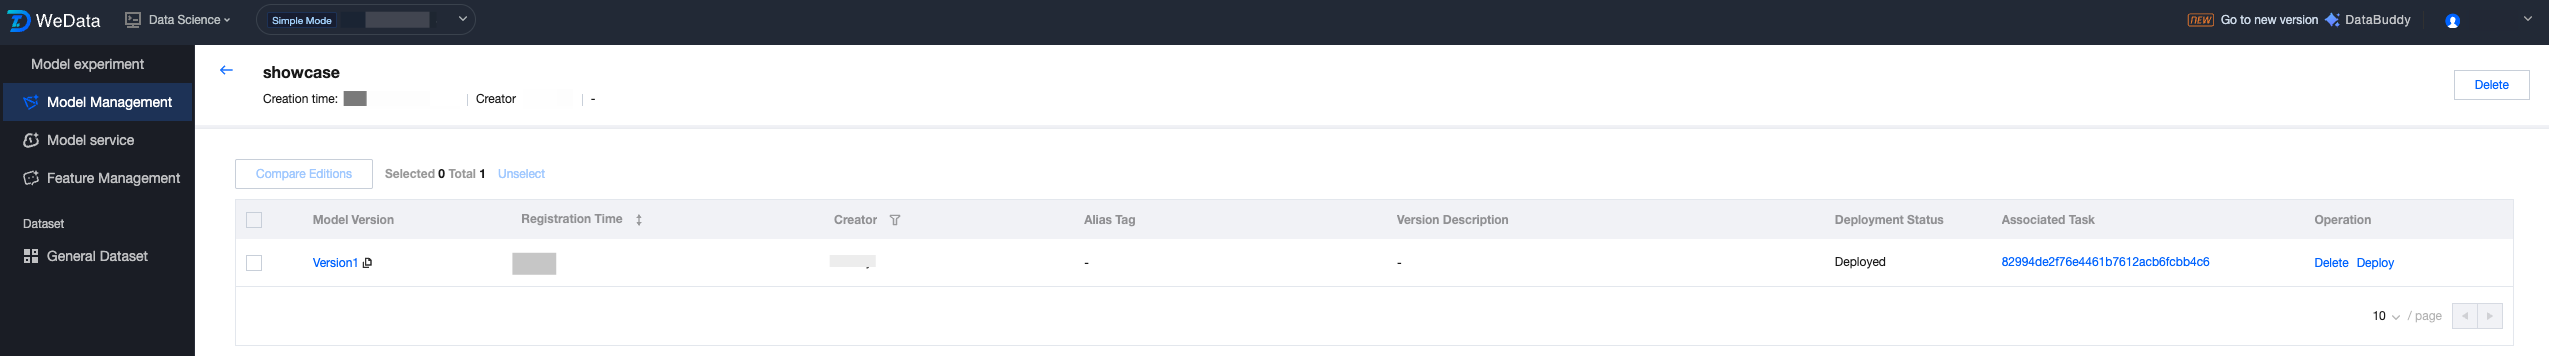
2. モデル名をクリックすると、モデルバージョンリストに入り、バージョン記録を確認できます。
特徴量管理に基づく赤ワイン予測モデル開発の機械学習実践チュートリアル
説明:
本チュートリアルの前提条件は、データサイエンス機能がすでに有効化されていること、DLCのCPUリソースをすでに購入していること、そして機械学習リソースグループを作成していることです。
基本情報
データ
本チュートリアルで使用するワイン品質予測データセット(通常はWine Quality Datasetを指します)は、機械学習分野における古典的な多クラス分類/回帰タスクのデータセットです。ポルトガルのアベイロ大学の研究チームによって提供され、物理化学指標と品質スコアの関連予測タスクにおけるモデル性能の評価によく使用されます。
モデル
本チュートリアルでは、ResNet-18モデルを採用しています。これは、Microsoftの何愷明氏のチームが2015年に提案した軽量残差ネットワークであり、その核心は残差接続によって深層ネットワークの勾配消失/劣化問題を解決することです。パラメータ化層(畳み込み+全結合)は合計18層で、パラメータ数は約11.7Mです。画像分類、特徴抽出、軽量化のシナリオでよく使用される古典的なビジョンモデルです。
リソース
DLCのCPUリソース:「Standard-S 1.1」またはEMRのCPUリソース:「350バージョン、EGコンポーネントを含む」
環境
StandardSpark
Studioでコードを編集してモデルトレーニングを開始する
1. 第一步として、特徴量エンジニアリングクライアントを有効にします。
# 特徴エンジニアリングのクライアントを構築します# Construct Feature Store Clientfrom datetime import datetime,datefrom pytz import timezonefrom wedata.feature_store.client import FeatureStoreClientfrom wedata.feature_store.entities.feature_lookup import FeatureLookupfrom wedata.feature_store.entities.training_set import TrainingSetfrom pyspark.sql.types import StructType, StructField, StringType, TimestampType, IntegerType, DoubleType, DateTypefrom pyspark.sql.functions import colfrom wedata.feature_store.common.store_config.redis import RedisStoreConfigimport os# TencentのキーSecretIDとSecretKey# SecretID and SecretKey of Tencent cloudcloud_secret_id = ""cloud_secret_key = ""# データソース名# Data source namedata_source_name = ""# 特徴エンジニアリングクライアントインスタンスを構築します# Construct Feature Store Clientclient = FeatureStoreClient(spark, cloud_secret_id=cloud_secret_id, cloud_secret_key=cloud_secret_key)# 特徴テーブル名を定義します# Define feature table nametable_name = ""database_name = ""register_table_name = ""
2. 第二步として、特徴検索を定義し、既存の特徴テーブルからトレーニングセットを作成します。
from wedata.feature_store.utils import env_utilsproject_id = env_utils.get_project_id()expirement_name = f"{table_name}_{project_id}"model_name = f"{table_name}_{project_id}"# 特徴検索の定義# Define feature lookupwine_feature_lookup = FeatureLookup(table_name=table_name,lookup_key="wine_id",timestamp_lookup_key="event_timestamp")# 学習データの構築# Construct train datainference_data_df = wine_df.select(f"wine_id", "quality", "event_timestamp")# トレーニングセットを作成します。# Construct trainsettraining_set = client.create_training_set(df=inference_data_df, # 基礎データdataframefeature_lookups=[wine_feature_lookup], # 特徴検索の設定 set feature lookuplabel="quality", # タグ列lable columnexclude_columns=["wine_id", "event_timestamp"] # 不要な列を除外しますexclude columns)# 最終的な学習用DataFrameを取得します# Get final train DataFrametraining_df = training_set.load_df()# 学習セットデータを出力します# print trainset dataprint(f"\\n=== 学習セットデータ ===")training_df.show(10, True)
3. 第三步では、モデル学習を開始します。
# モデルを学習します# Train modelfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import classification_reportfrom sklearn.ensemble import RandomForestClassifierimport mlflow.sklearnimport pandas as pdimport osproject_id=os.environ["WEDATA_PROJECT_ID"]mlflow.set_experiment(experiment_name=expirement_name)# Spark DataFrameをPandas DataFrameに変換して学習に使用します。# Convert Spark DataFrame to Pandas DataFrame for trainingtrain_pd = training_df.toPandas()# タイムスタンプ列を削除します。# Delete timestamp columns# train_pd.drop('event_timestamp', axis=1)# 特徴量とラベルを準備します。# Prepare features and tagsX = train_pd.drop('quality', axis=1)y = train_pd['quality']# 学習セットとテストセットを分割します。# Split trainset and testsetX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# 日付をタイムスタンプ(秒)に変換します。# Convert datatime to timestamp(second)for col in X_train.select_dtypes(include=['datetime', 'datetimetz']):X_train[col] = X_train[col].astype('int64') // 10**9 # ナノ秒→秒# 欠損値によってdtypeがobjectにダウングレードされていないことを確認します。# Verify that no missing values cause the dtype to be downgraded to object.X_train = X_train.fillna(X_train.median(numeric_only=True))# モデルを初期化して学習します。# Initialize, train and log the model.model = RandomForestClassifier(n_estimators=100, max_depth=3, random_state=42)model.fit(X_train, y_train)with mlflow.start_run():client.log_model(model=model,artifact_path="wine_quality_prediction", # モデルファイルのパス名model artifact pathflavor=mlflow.sklearn,training_set=training_set,registered_model_name=model_name, # モデル名(catalogを有効にした後はcatalogのモデル名を記述する必要があります)model name(if enable catalog, must be catalog model name))
実験管理で実行結果を確認する
1. データサイエンスの実験管理モジュールに入ると、先ほどコードで実行した記録が実験管理で確認できるようになっています。画面には、実験名、実験タイプ、実験の説明、作成時間、担当者、操作項目などの情報が表示されます。

2. 実験名をクリックすると、実行記録ページに入り、先ほど報告されたタスク記録を確認できます。画面には、タスク名、タスク状態、作成時間、継続時間、コードファイル、登録モデルなどの情報が表示されます。
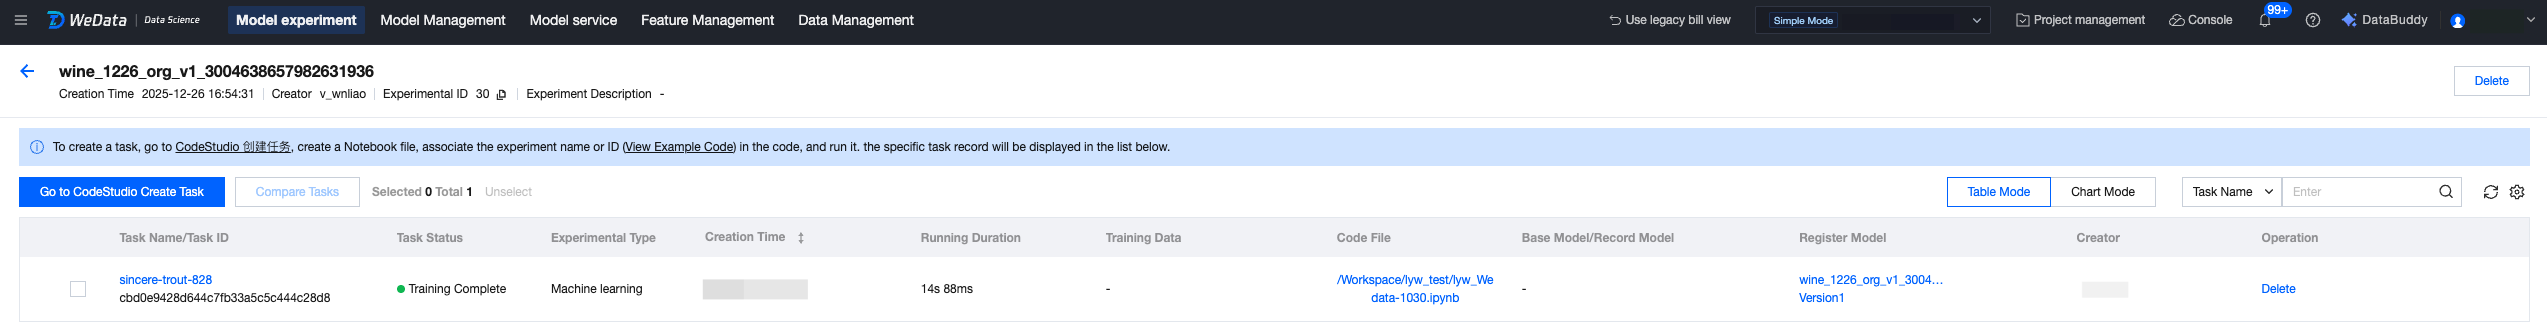
3. タスク名をクリックすると、実行詳細の概要ページに入り、報告された学習ハイパーパラメータ、モデル指標などを確認できます。
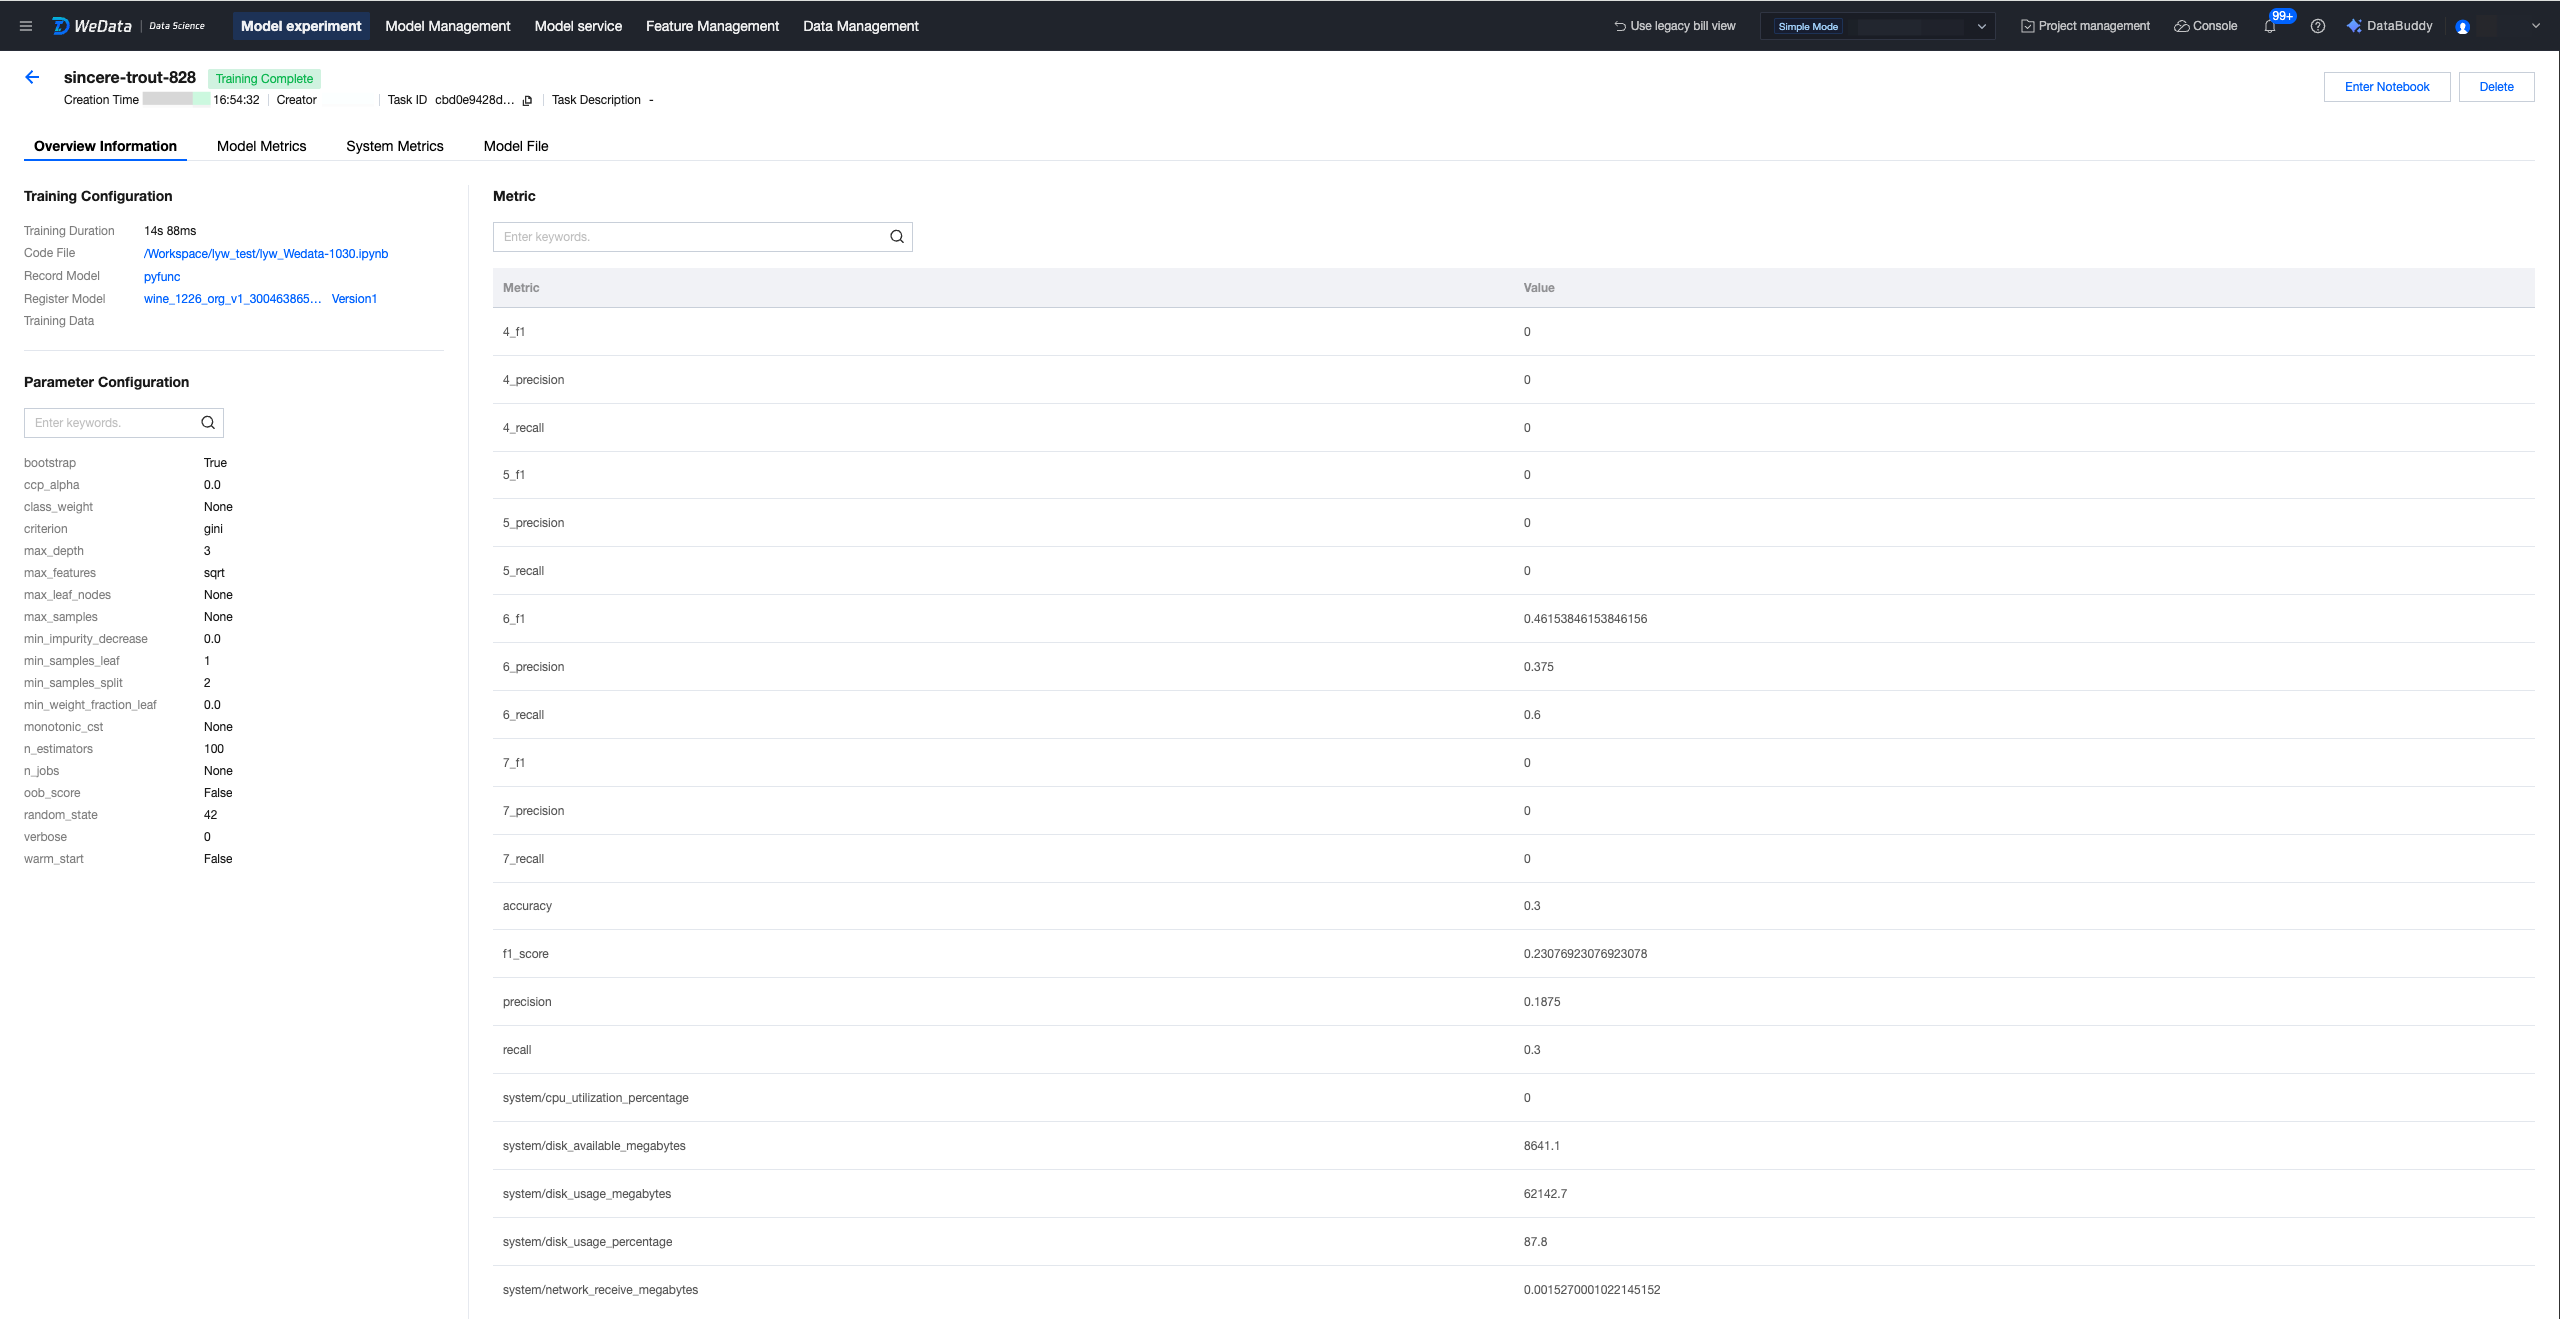
4. モデル指標を表示します。
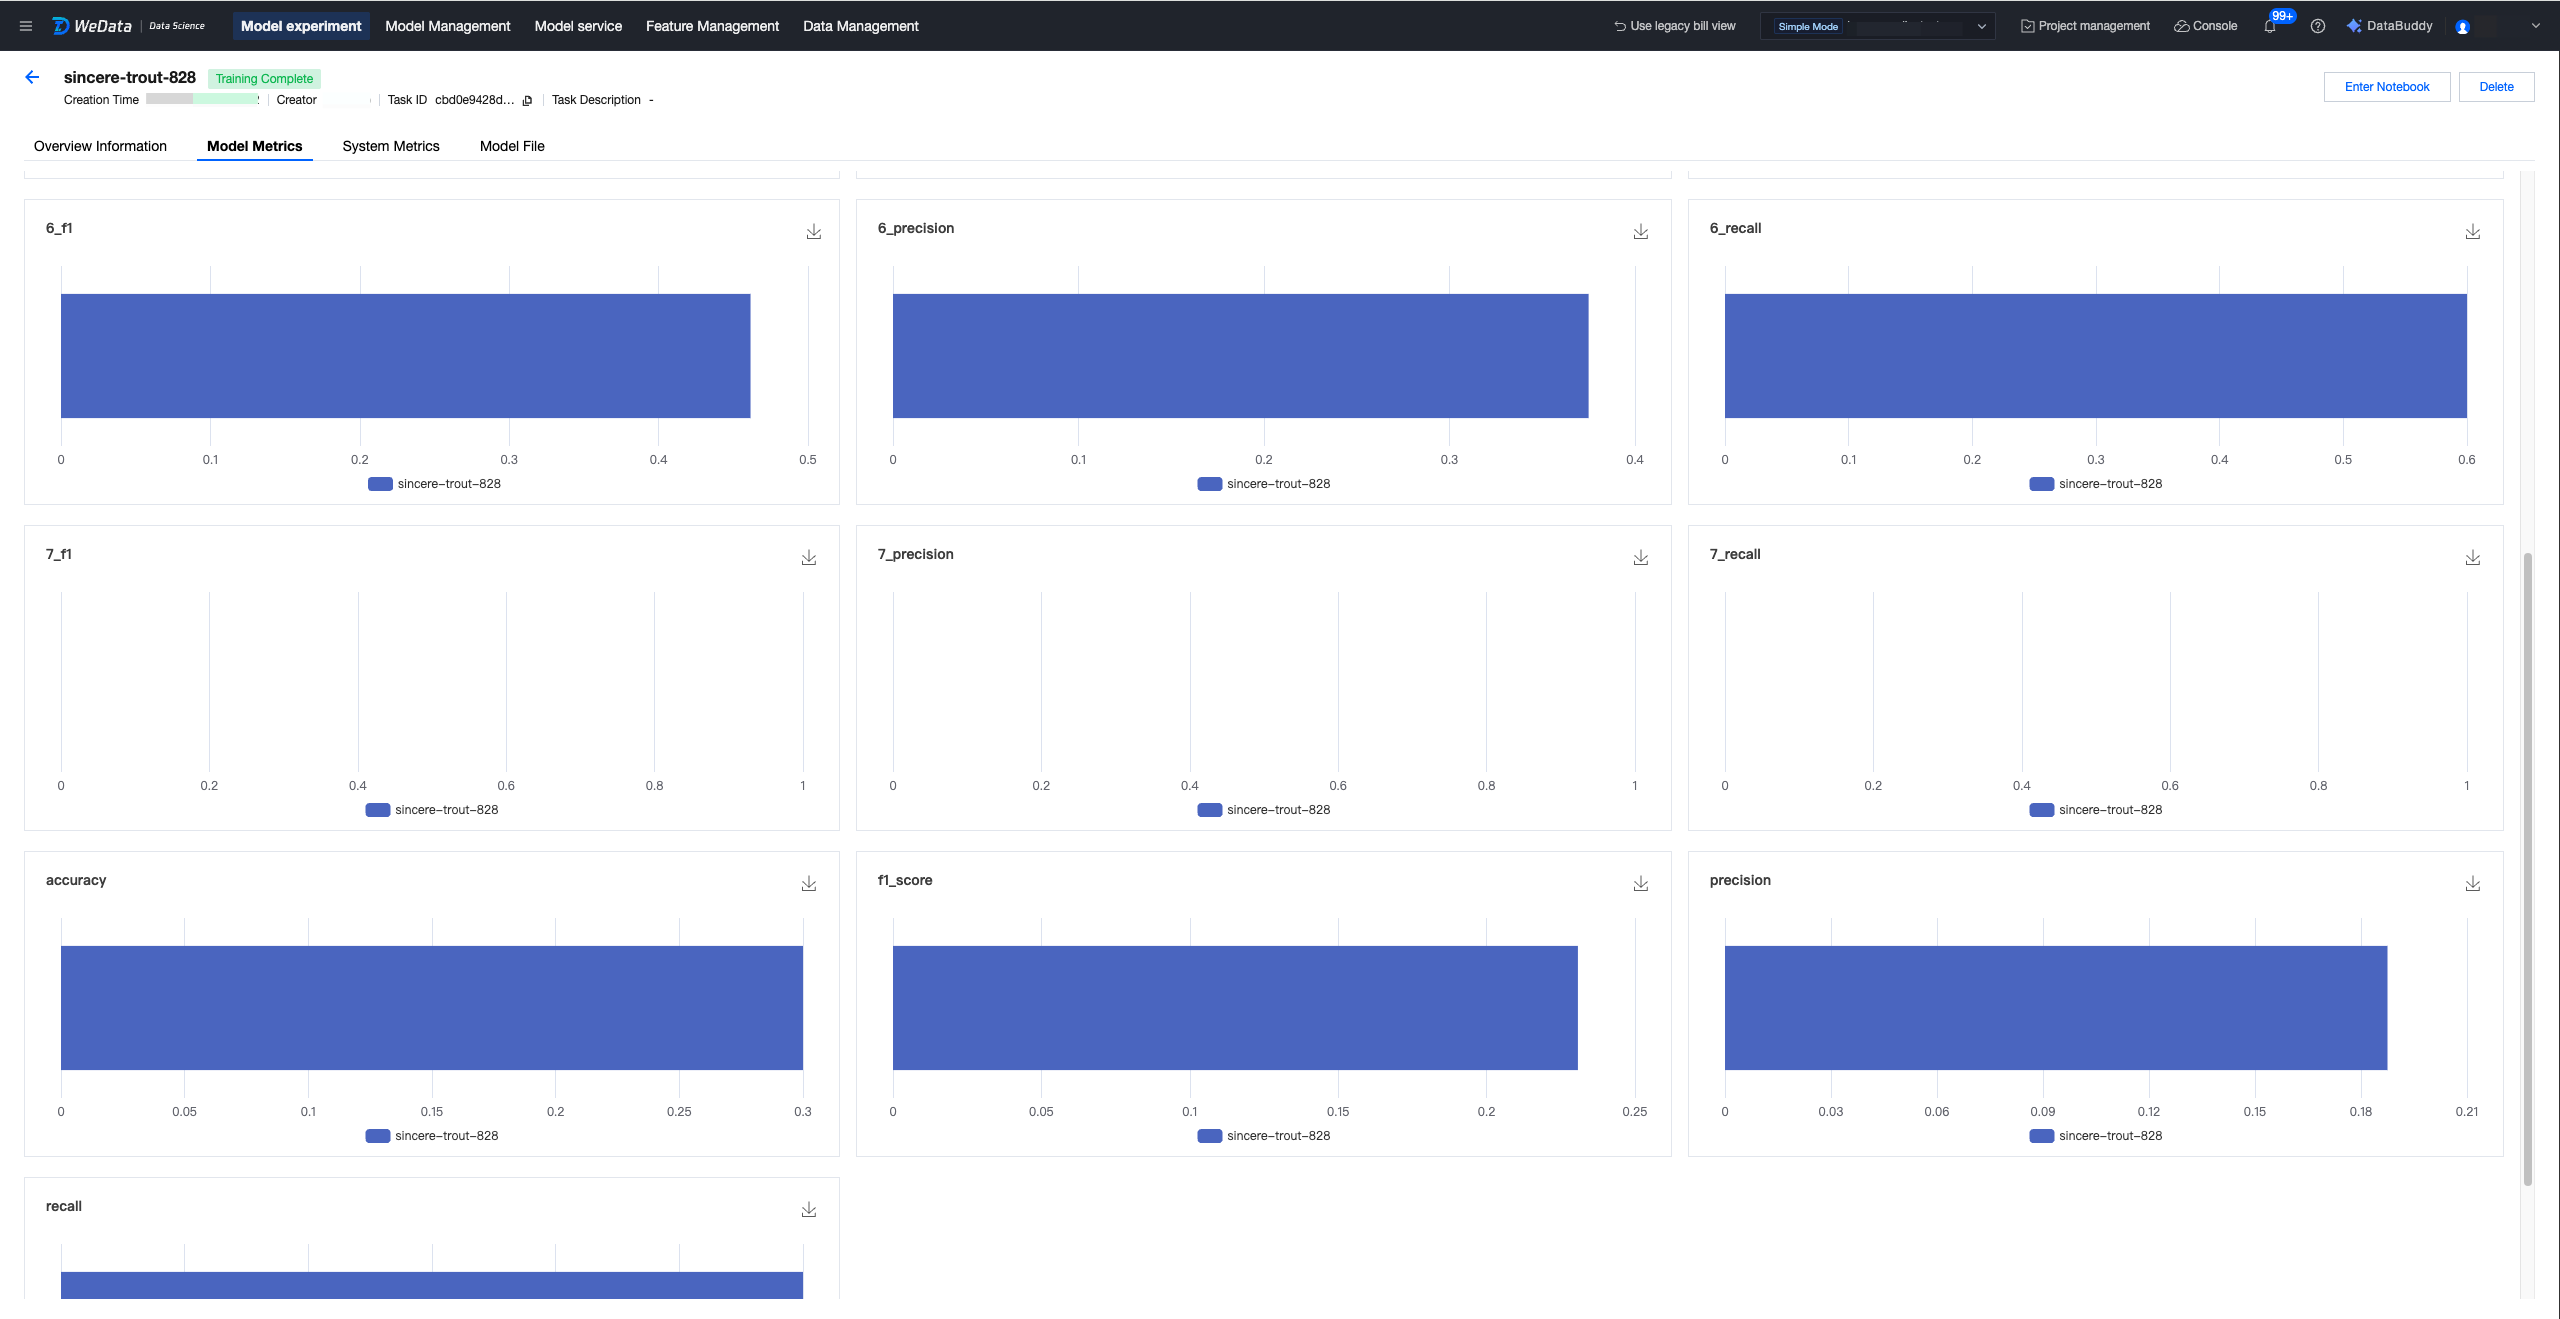
5. モデルファイルを表示します。特徴量を使用してトレーニングデータセットを構築し、特徴量エンジニアリングAPIでモデルを記録する場合、feature specファイルも同時に保存され、トレーニング特徴量のソースを把握するのに役立ちます。
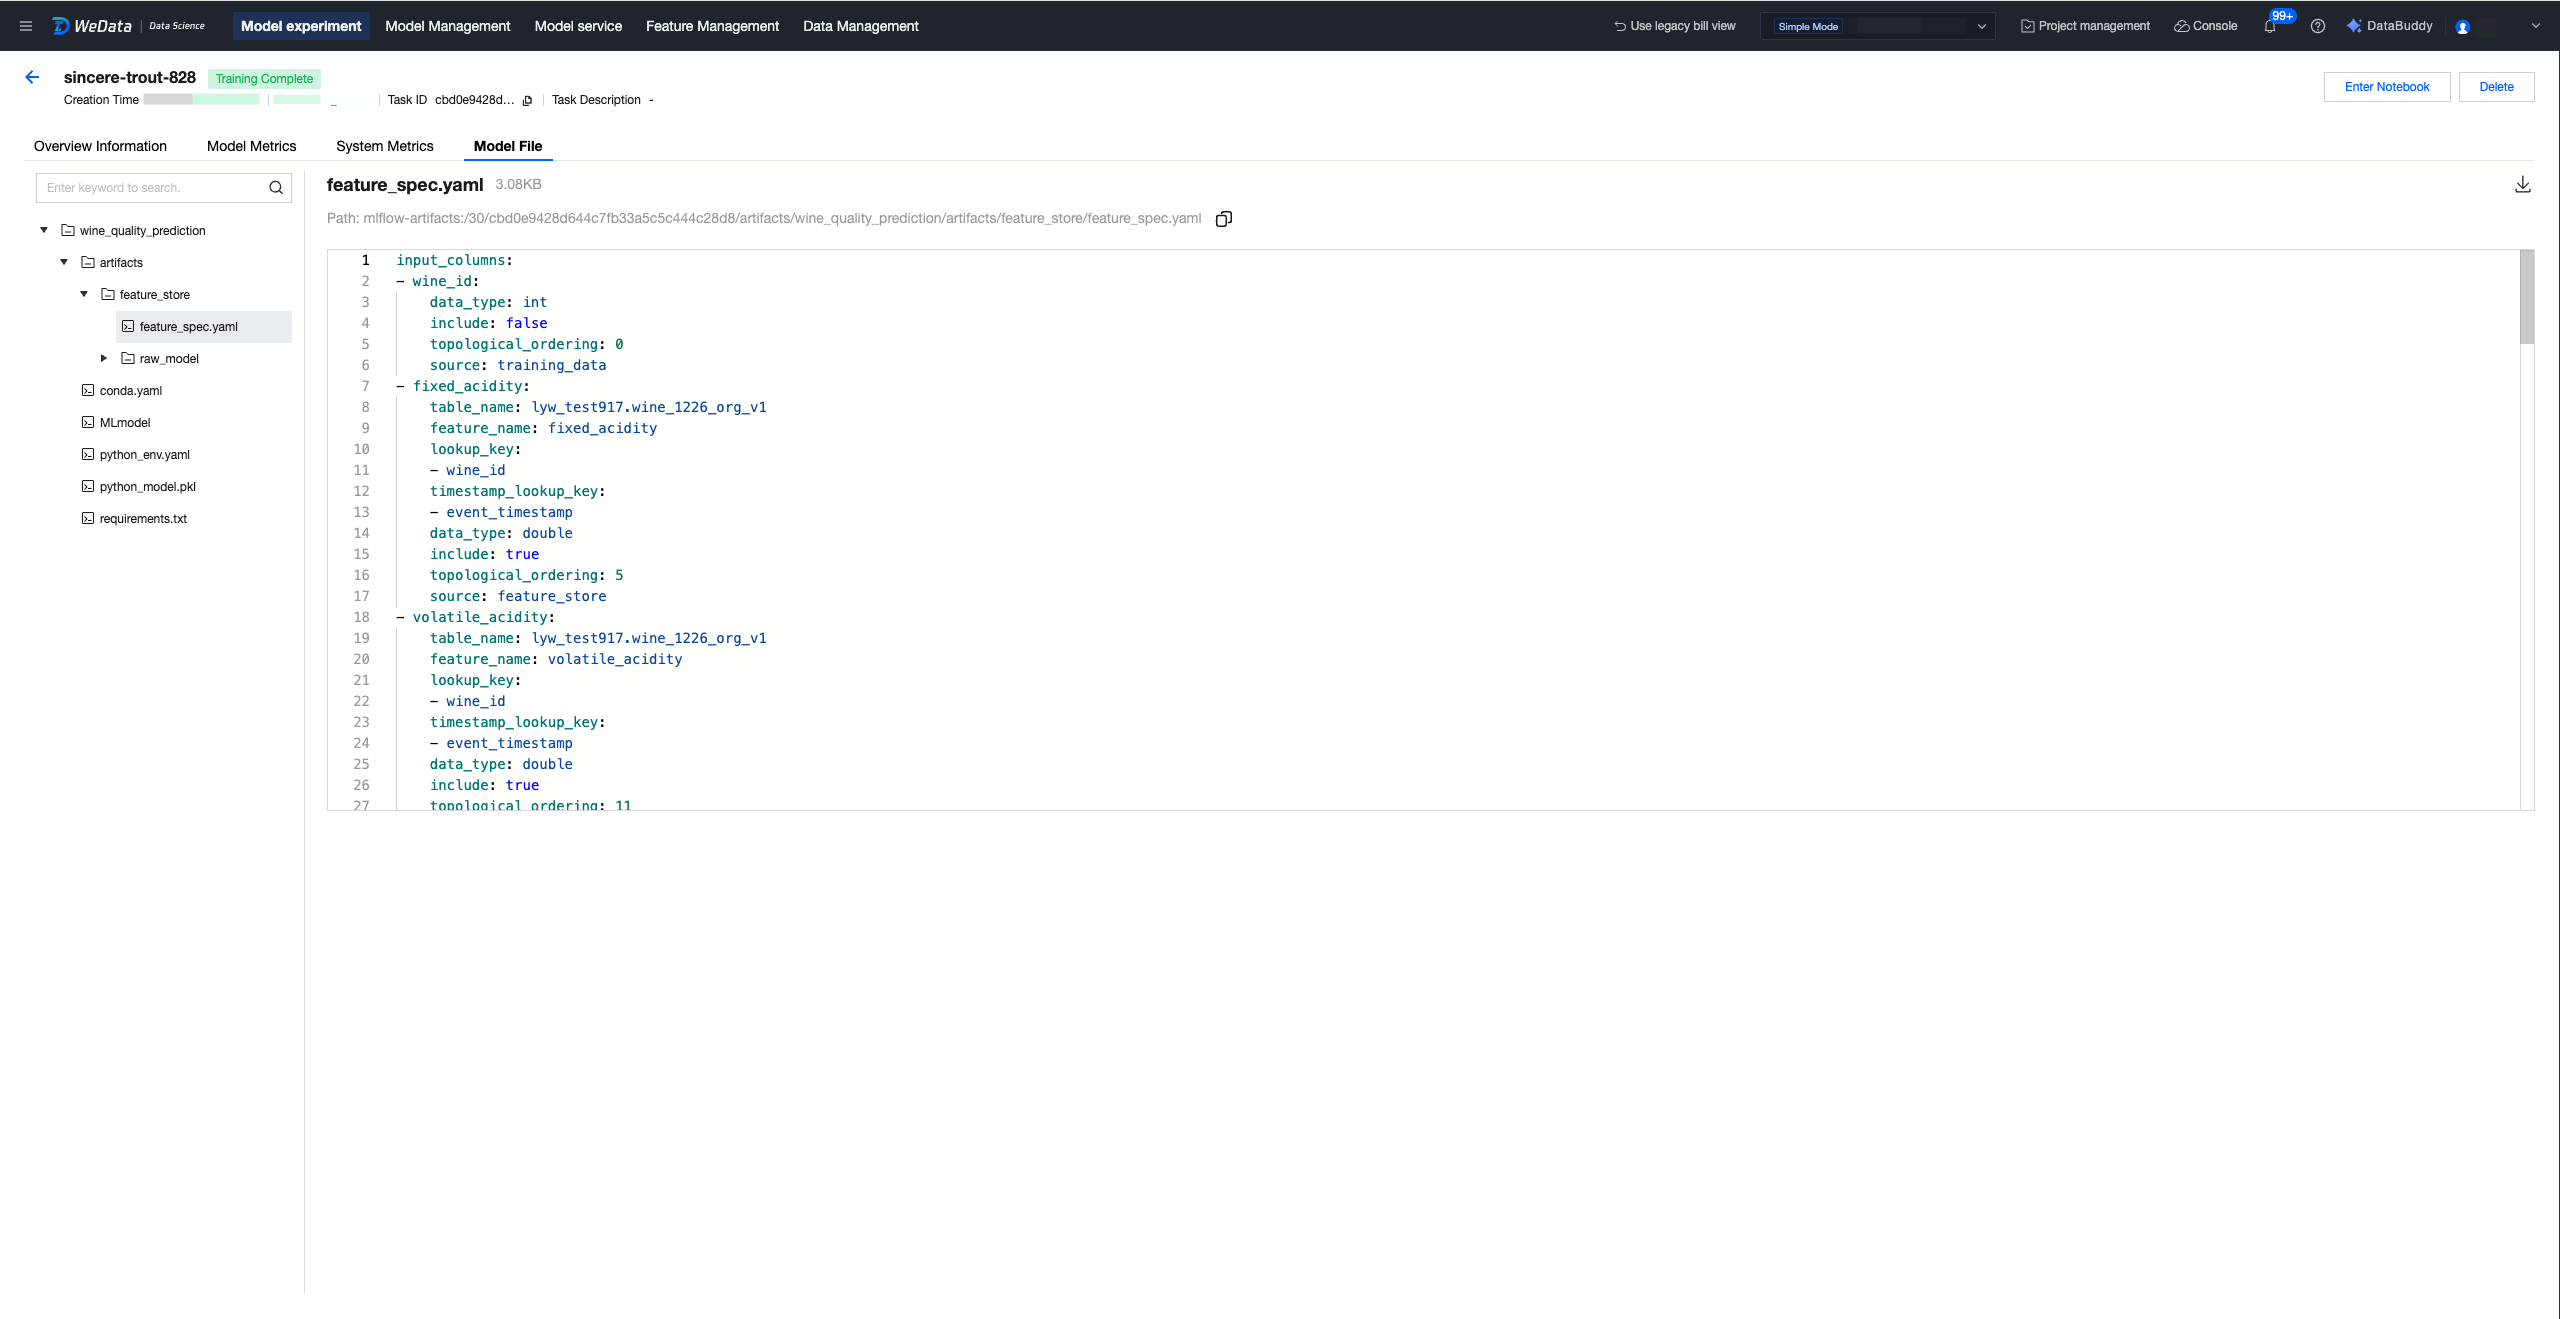
モデル管理で登録済みモデルを確認する
1. モデル管理ページをクリックすると、記録されたモデルを確認できます。

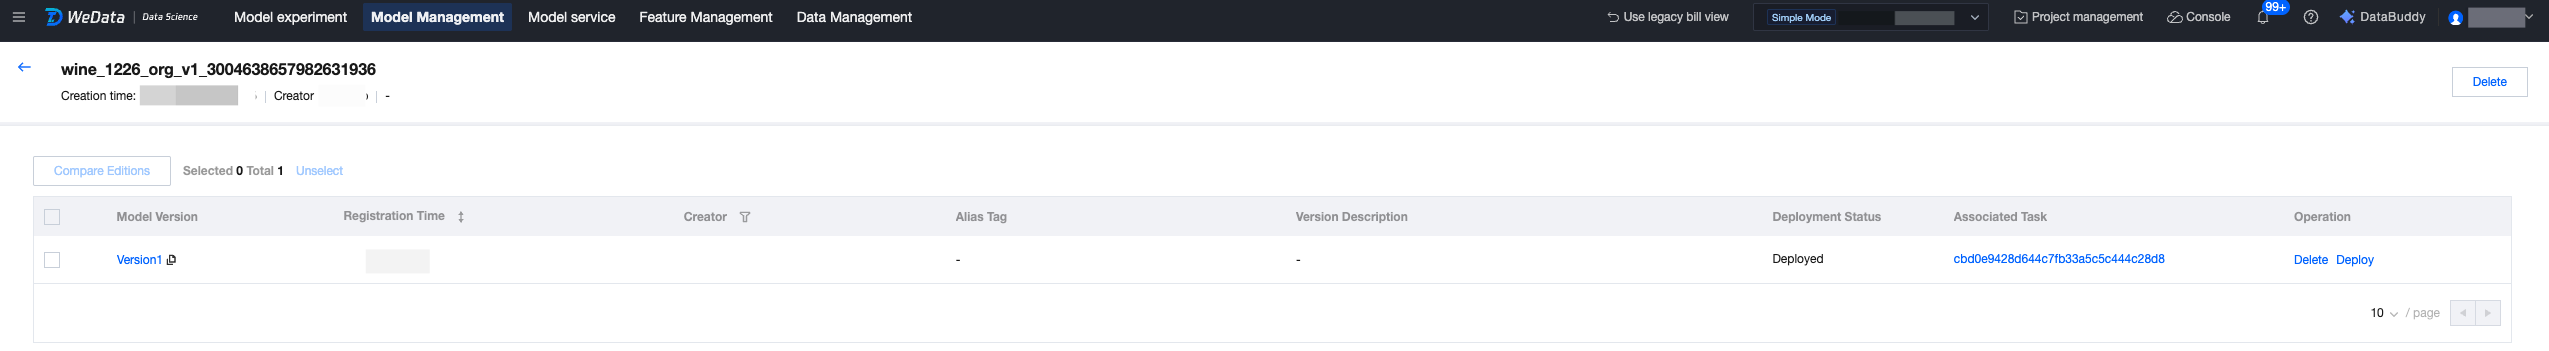
2. モデル名をクリックすると、モデルバージョンリストに入り、バージョン記録を確認できます。
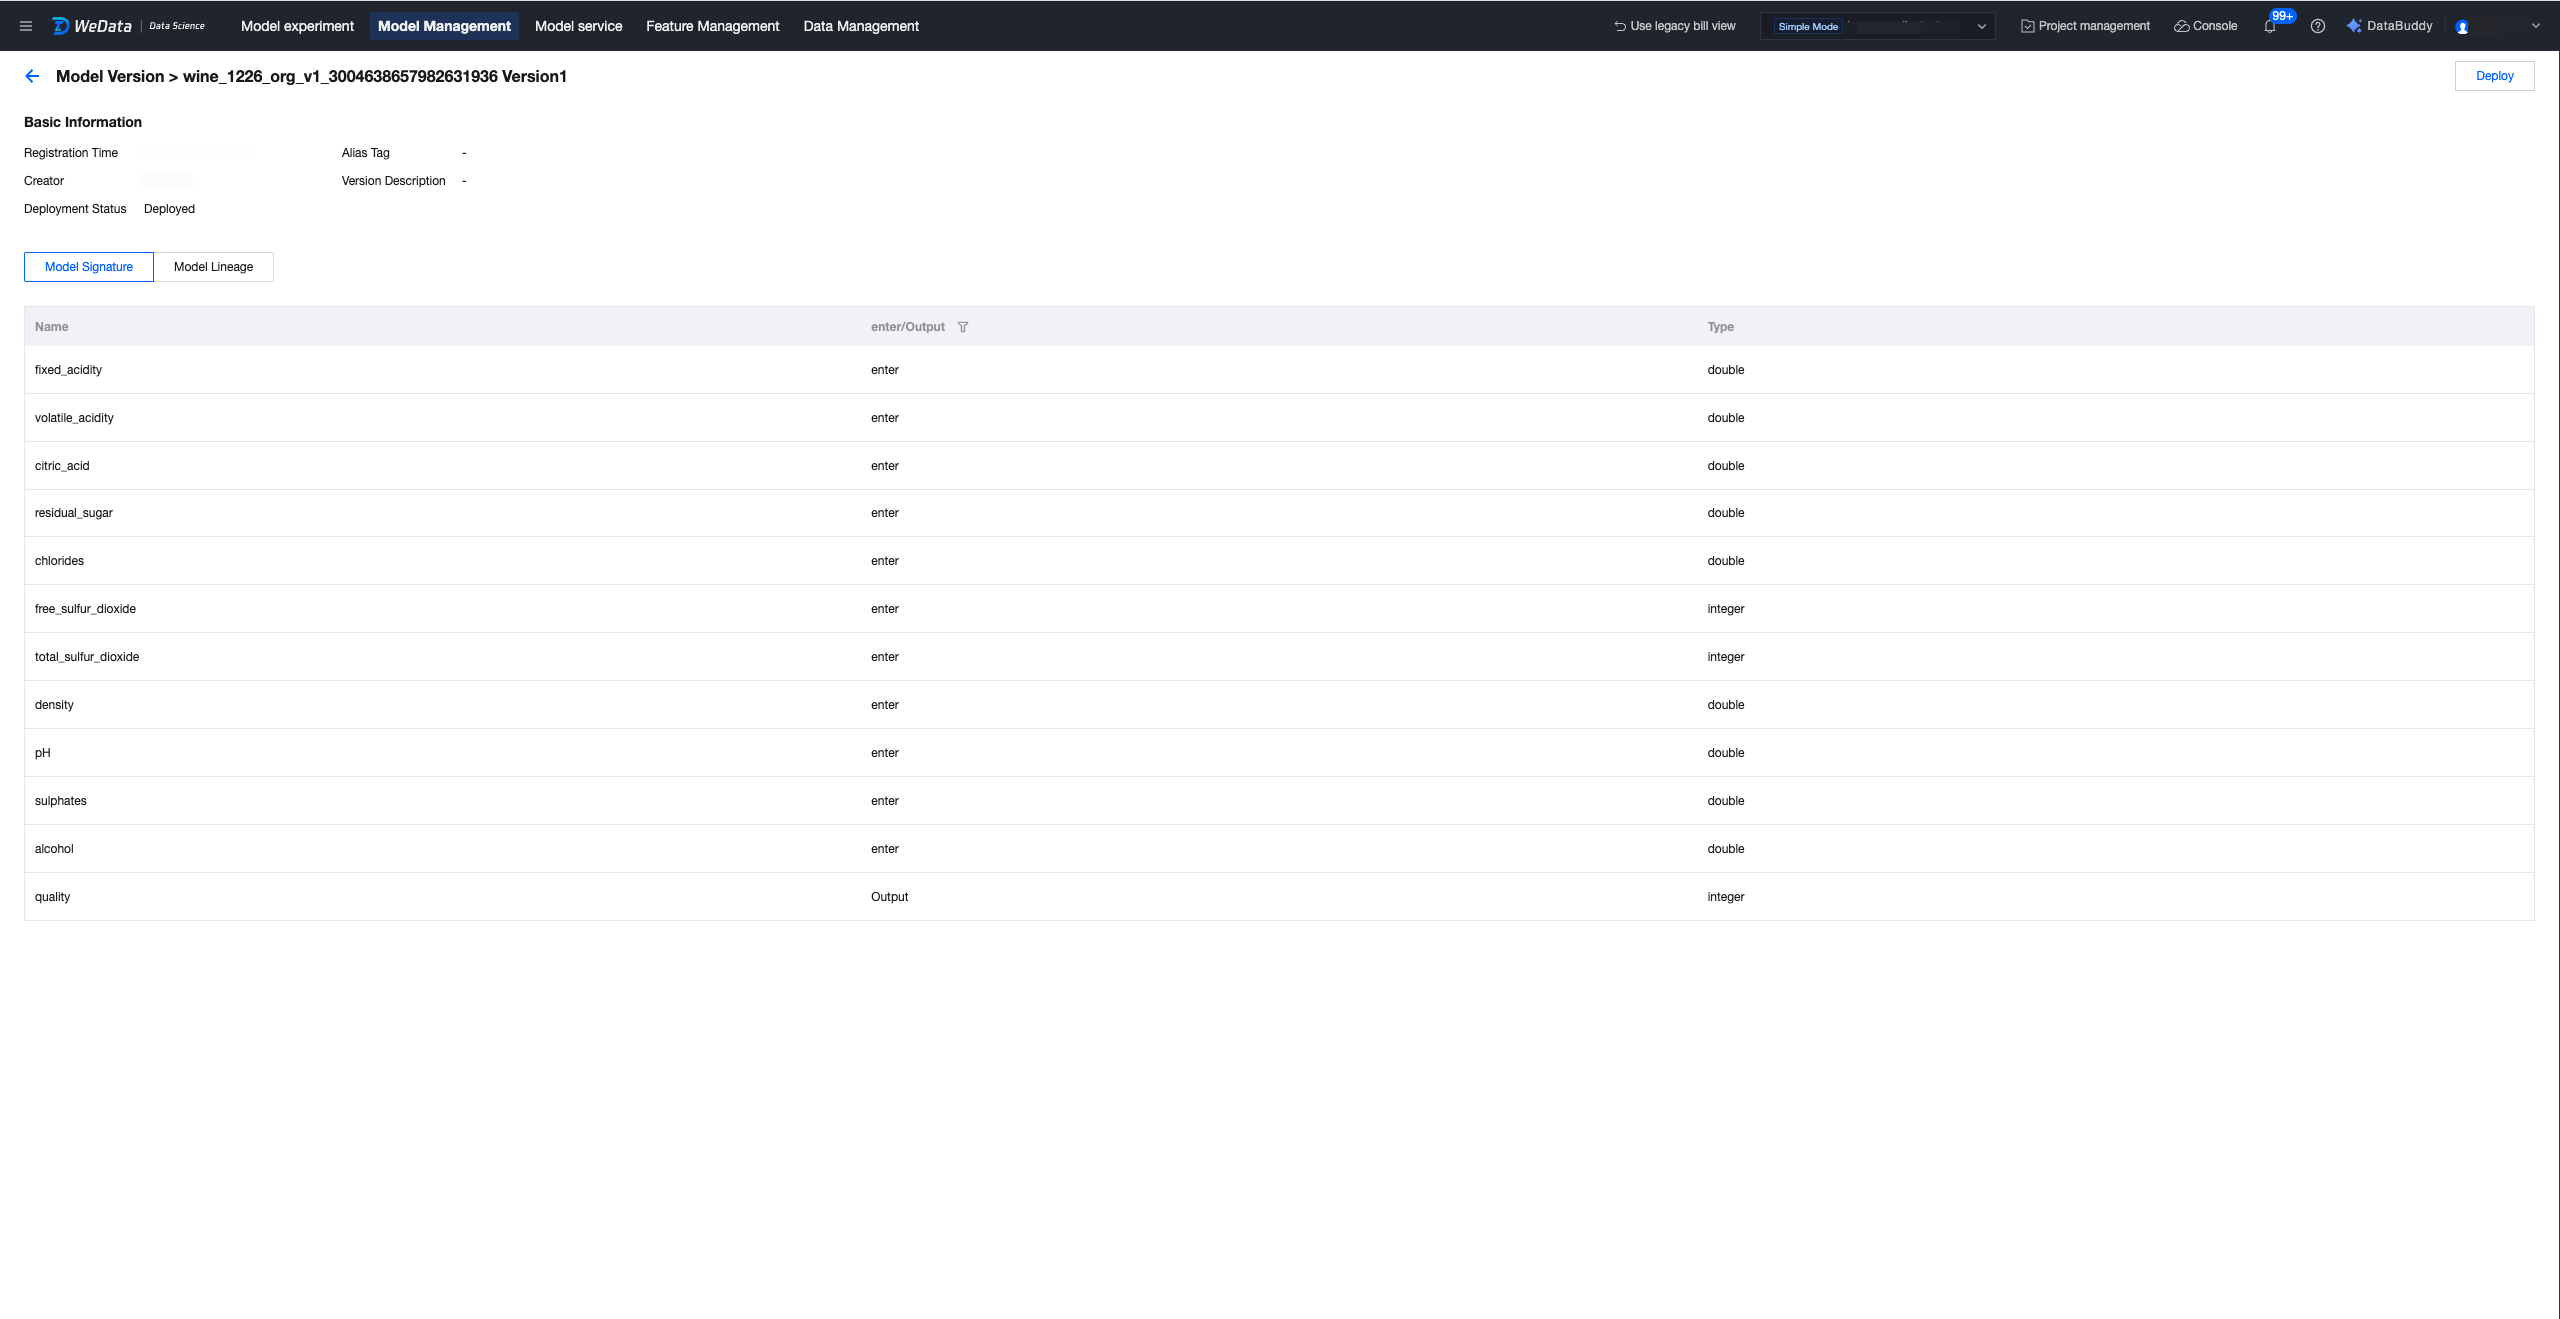
3. モデルバージョンをクリックすると、モデルシグネチャ、モデルリネージなどの情報を確認できます。
フィードバック