特徴管理
ダウンロード
フォーカスモード
フォントサイズ
機能概要
WeDataの特徴管理モジュールは、特徴のオフラインストレージとオンラインストレージのサービスを提供することで、特徴の統一管理を実現し、データサイエンティストとデータエンジニアがモデル開発プロセスにおいて、特徴を集約的に保存、読み取り、分析、再利用できるように支援し、サイロ化した開発協業モデルを回避します。
機能説明
WeDataの特徴管理は主に以下の機能を提供します:
タイプ | 説明 |
インターフェース操作機能 | 1. 特徴テーブルの基本情報、特徴フィールド情報などの確認をサポートします。 2. 特徴テーブルの一括インポートをサポートします。 3. 特徴同期の作成などをサポートします。 |
特徴量エンジニアリングAPI | Studioで呼び出して、オンライン・オフライン特徴テーブルの追加、削除、変更、照会、同期、消費などの操作を行うことをサポートします。 |
必要な説明
タイプ | 説明 |
オフライン特徴ストア | WeDataが管理するオフライン特徴テーブルは、現在DLCのIcebergテーブルとEMRのHiveテーブルのみをサポートしています。また、特徴テーブルを登録する際には、テーブルの主キーとタイムスタンプキーを指定する必要があります。その後の操作では、指定した主キーとタイムスタンプキーに基づいて特徴インデックスが作成されます。 |
テーブル操作権限 | DLC: Catalogを有効にした場合: DLCの「DLC > システム管理 > ユーザーと権限管理」で、ユーザーに対応するデータベースとテーブルの権限を付与する必要があります。 また、WeDataの「データ資産 > Catalogディレクトリ > 対応するCatalog > 権限」でユーザーに権限を付与します。 Catalogを有効にしていない場合: DLCの「DLC > システム管理 > ユーザーと権限管理」で、ユーザーに対応するデータベースとテーブルの権限を付与するだけで済みます。 EMR: WeDataの「プロジェクト管理 > ストレージとコンピューティングエンジンの設定」でエンジンアクセスアカウントとアカウントマッピングを設定し、データベースとテーブルへのアクセス権限を決定します。 |
オンライン特徴ストア | WeDataはRedisをオンライン特徴ストアとしてサポートしています。準備は以下のとおりです: 第一步:Distributed CacheにアクセスしてRedisインスタンスを作成します。 地域とネットワークは、スケジューリングリソースグループおよび使用するエンジン(DLCまたはEMR)と一致させる必要があります。 第二步:WeDataの「プロジェクト管理 > データソース管理」でRedisデータソースを追加し、スケジューリングリソースグループへの接続をテストします。 第三步:WeDataの「オフライン開発 > Studio」でリモートカーネルに接続した後、Redisが接続されているかどうかを確認します。以下のとおりです:
|
特徴量エンジニアリングパッケージ | エンジンに接続後、以下のコマンドを実行すると、最新の特徴量エンジニアリングパッケージをインストールできます:
DLCエンジンを使用する場合、リソースグループを構築する際に「wedata-data-science」イメージを選択してください。特徴量エンジニアリングパッケージはすでにプリインストールされています。コマンドを実行してバージョンを確認できます:
|
キー管理についての説明 | |
環境変数設定 | DLC: Catalogを有効にした場合、追加設定は不要です。 Catalogを有効にしていない場合、環境変数を設定する必要があります。設定しないと、実験およびモデルの報告でエラーが発生する可能性があります:
EMR: 環境変数を設定する必要があります。設定しないと、実験およびモデルの報告でエラーが発生する可能性があります:
|
画面操作
特徴のインポートとデフォルトライブラリ設定
オフライン特徴テーブルの一括インポート/登録
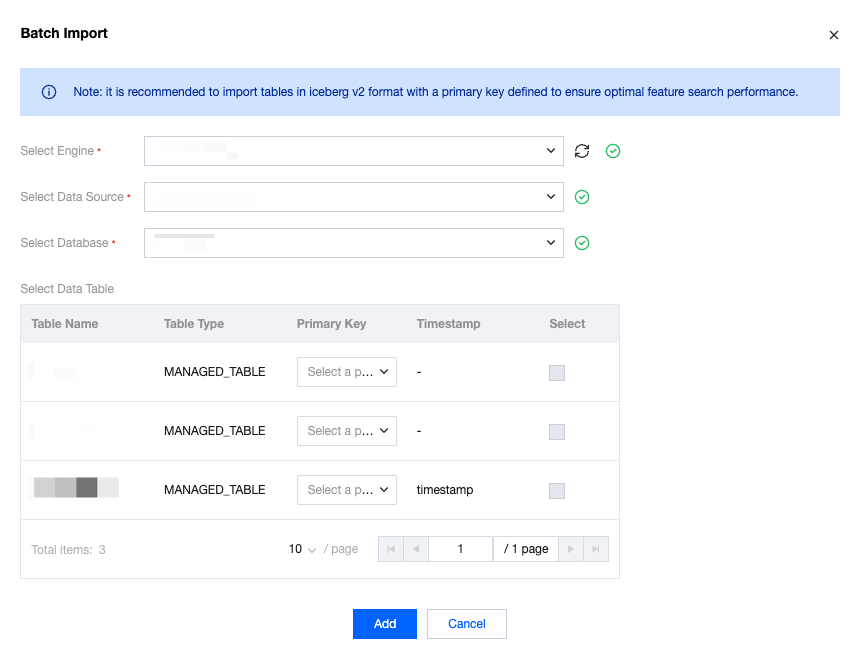
WeDataは既存の特徴テーブルの一括インポート/登録をサポートしています。特徴管理ページに入り、一括インポートボタンをクリックします。プロンプトに従ってエンジン、データソース、データベースを選択し、主キーおよび対応するテーブルをチェックして、一括インポートを実行できます。
デフォルトライブラリ設定
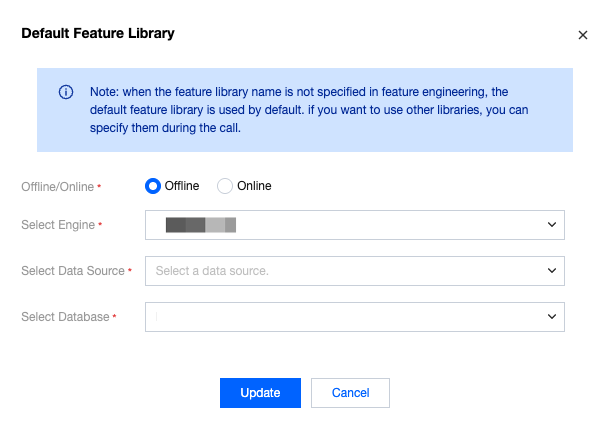
WeDataはデフォルトのオフライン特徴ストアとオンライン特徴ストアの設定をサポートしています。APIを呼び出す際に特徴ストア情報を指定しなかった場合、デフォルトの特徴ストア情報が使用されます。
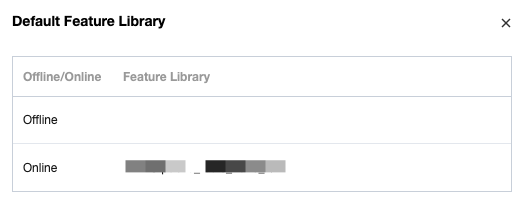
また、モジュール名の右側で、設定されたデフォルトデータベース情報を確認できます。
オンラインテーブル作成/特徴同期
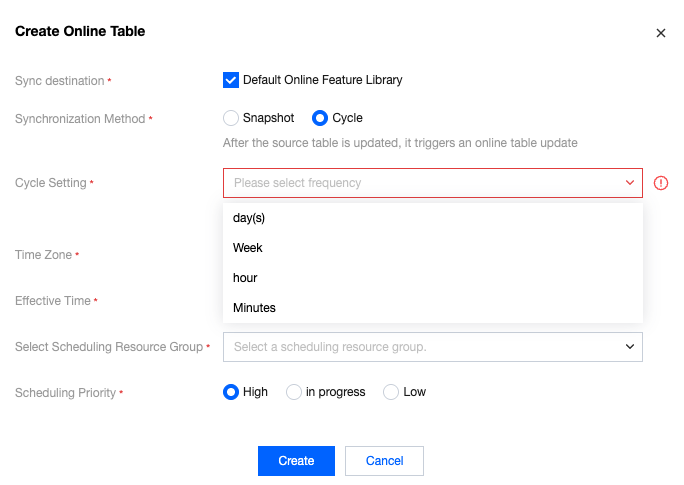
オフライン特徴テーブルのオンラインテーブル作成操作項目をクリックすることで、オフラインテーブルからオンラインテーブルへの同期タスクを作成できます。同期方式としてスナップショットと周期の2種類を選択できます。
スナップショット方式は一回限りの特徴同期をサポートし、計算リソース、タスク優先度などを設定します。
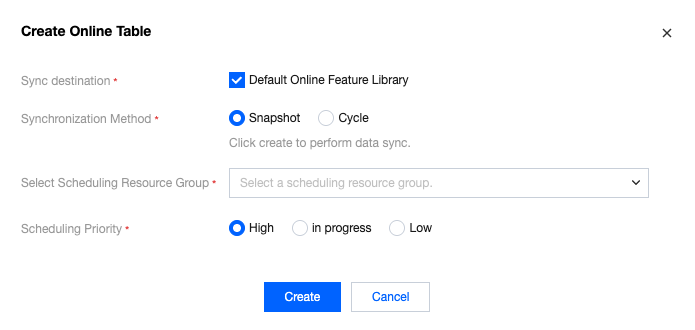
周期方式は同期周期の設定をサポートし、日、週、時間、分単位の同期周期をサポートします。また、時間範囲、計算リソース、タスク優先度などを設定できます。
特徴テーブル詳細表示
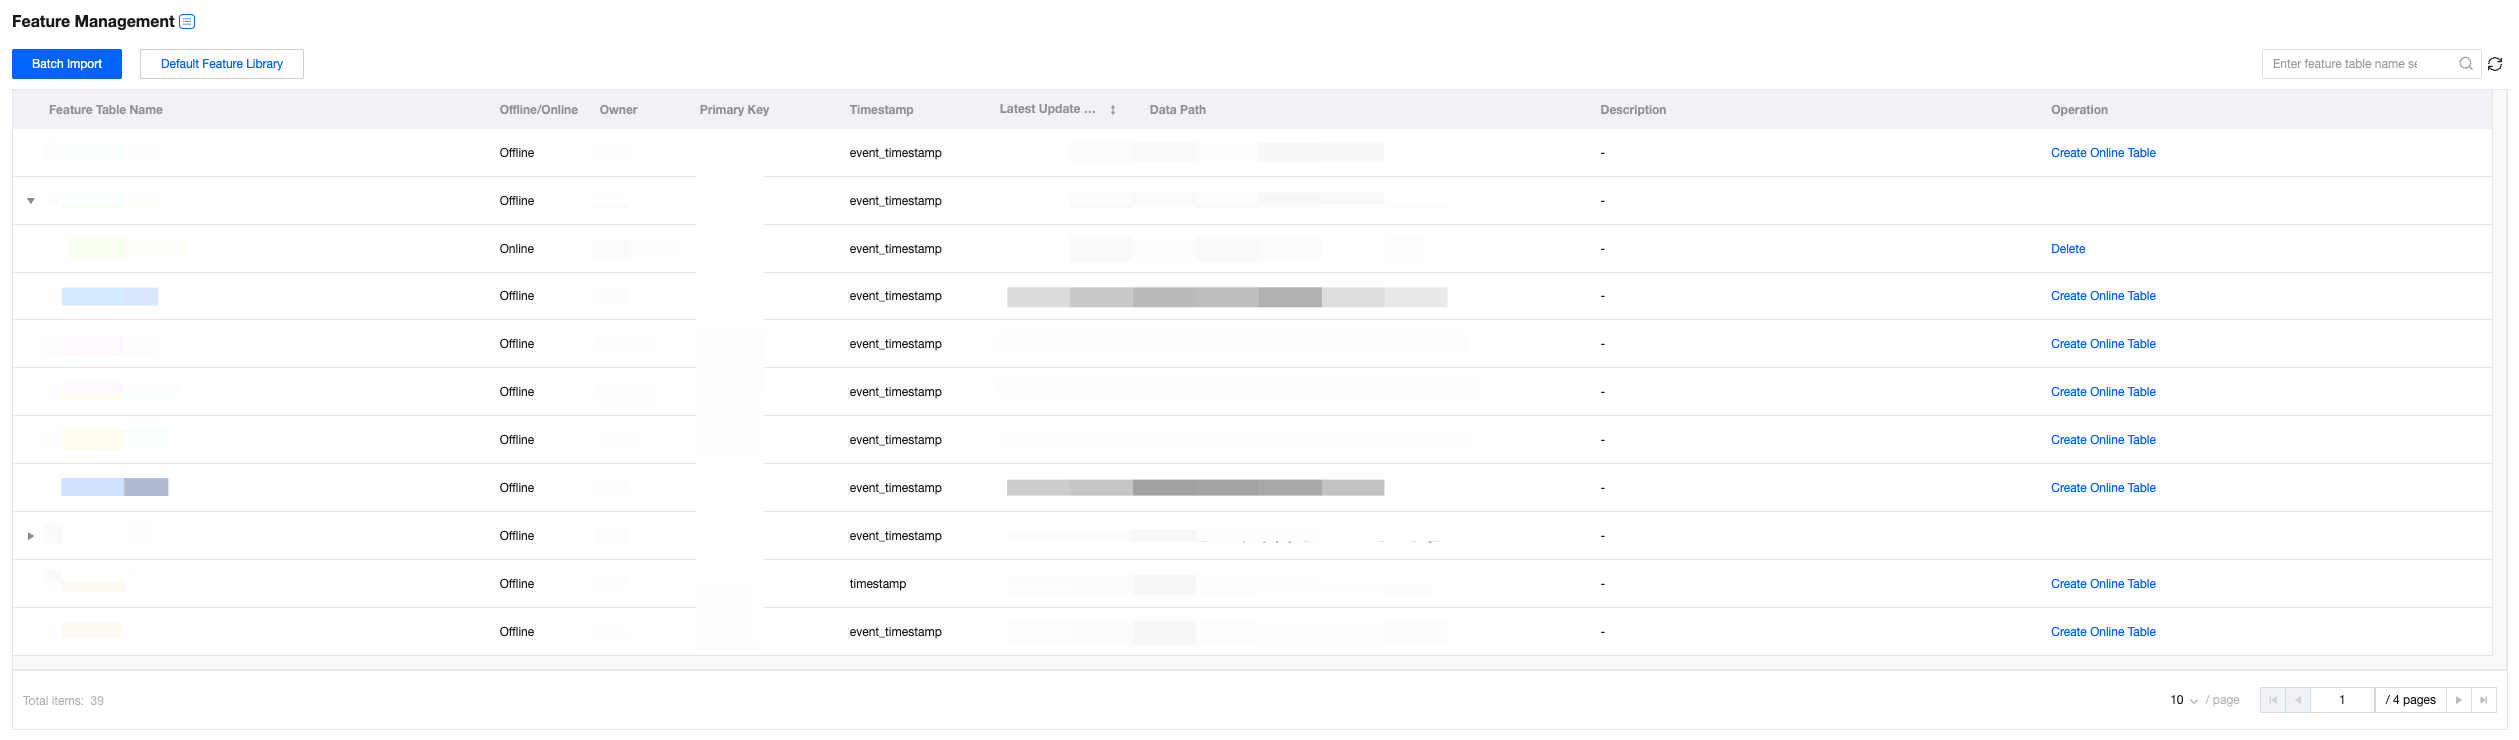
特徴管理ページでは、インデックスを使用してオフライン特徴テーブルとオンライン特徴テーブルのメタ情報を表示できます。
リストページでは、特徴テーブル名、オフライン/オンライン状況、責任者、主キー、タイムスタンプ、最終更新日時、データアドレス、説明、操作項目を確認できます。
リスト内のオンライン特徴テーブル情報はデフォルトで折りたたまれています。
オンライン特徴テーブルが未作成の場合でも、オンライン特徴テーブルを作成する操作項目を提供します。
オンライン特徴テーブルがすでに作成されている場合、オンライン特徴テーブルの操作項目は提供されません。また、テーブル名の左側にある三角形をクリックすることで、対応するオンライン特徴テーブルの情報を展開できます。
1つのオフライン特徴テーブルから作成できるオンライン特徴テーブルは1つのみです。
オフライン特徴テーブルを削除する前に、対応するオンライン特徴テーブルを先に削除する必要があります。そうしない場合、削除ボタンは提供されません。
オフライン特徴テーブル詳細
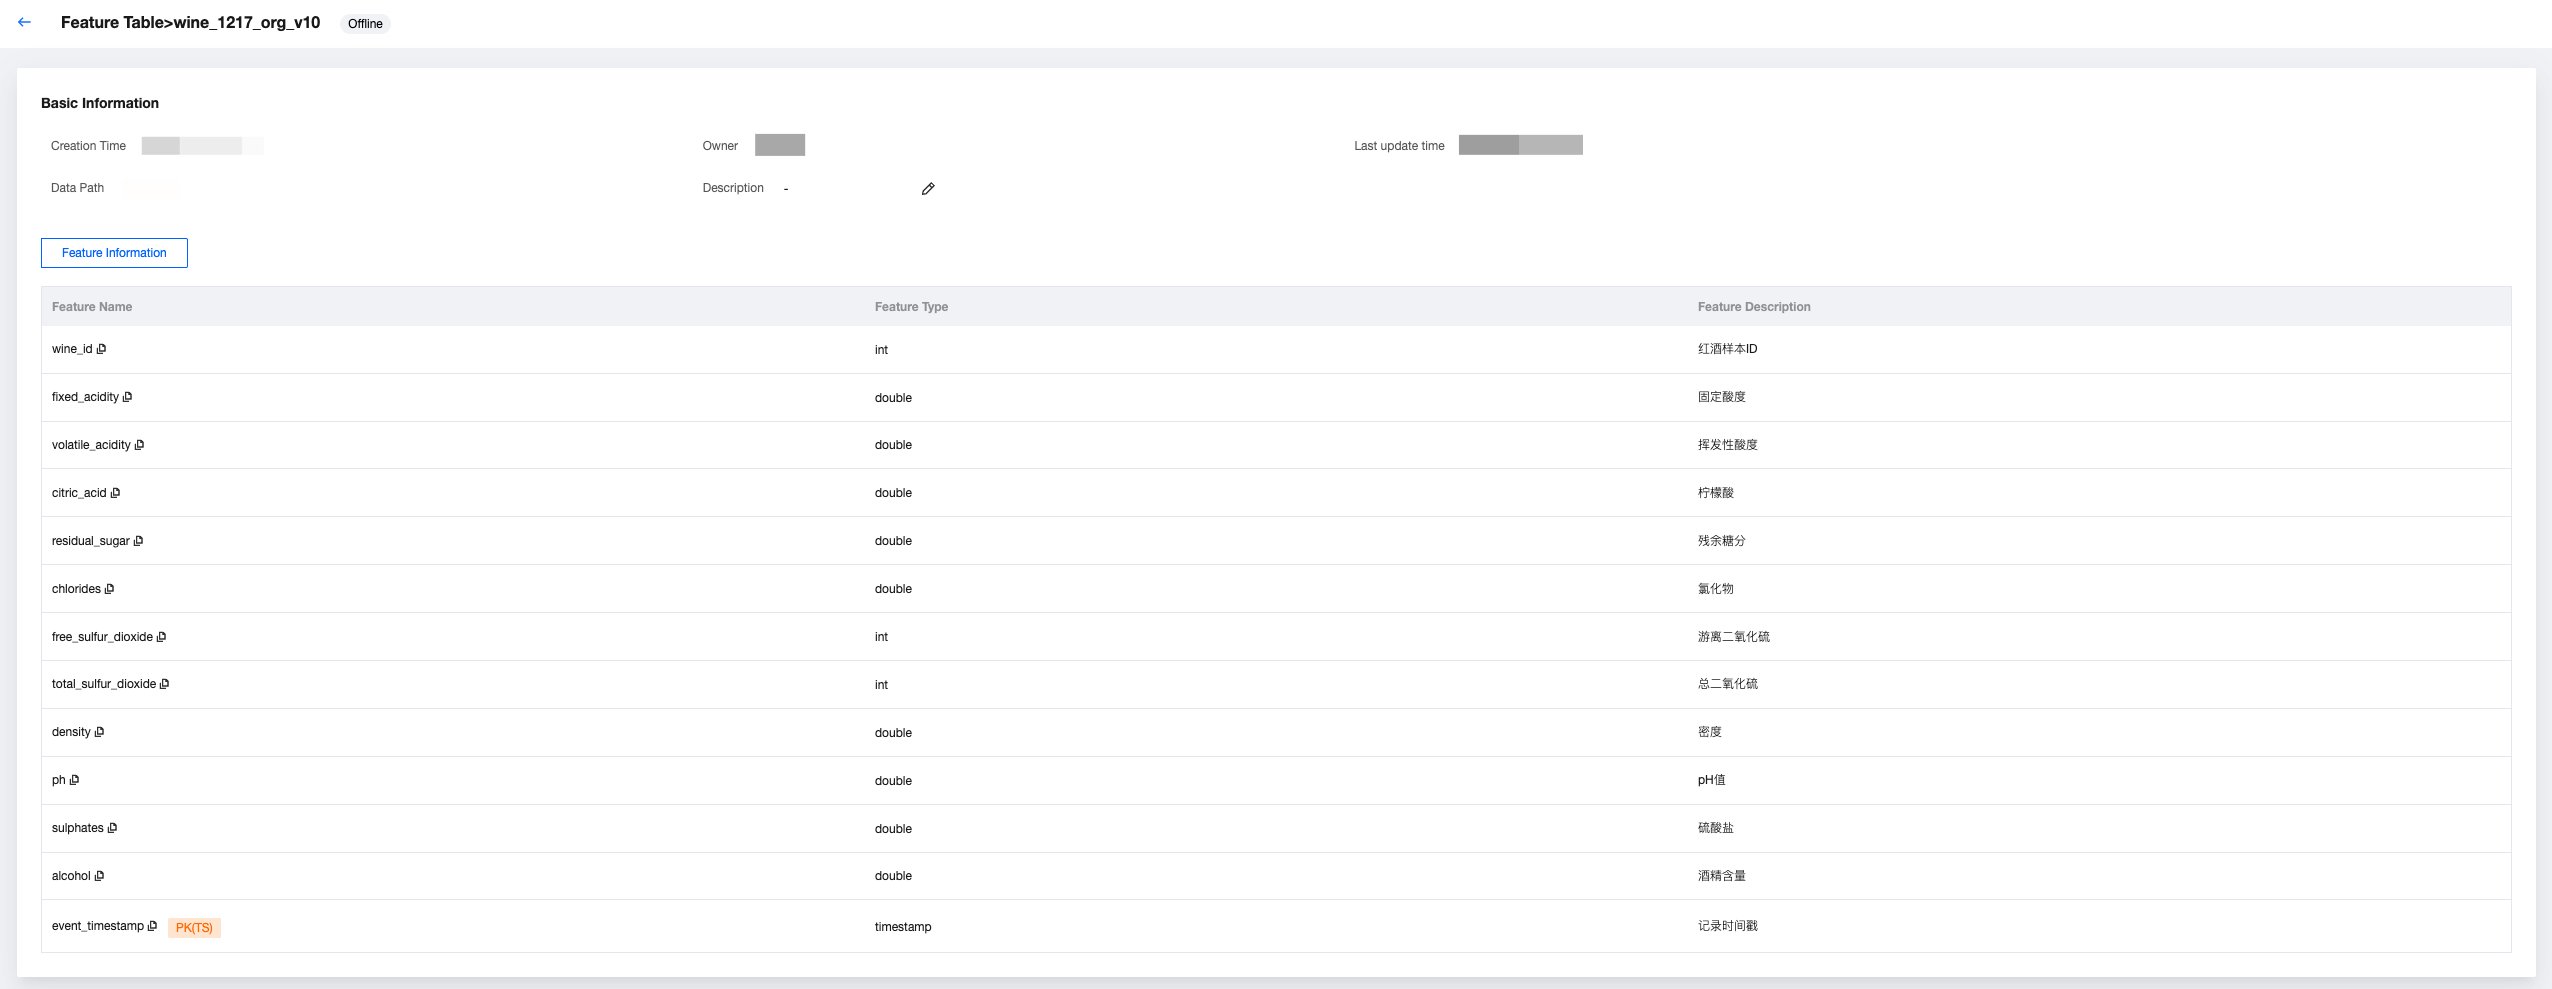
オフライン特徴テーブルの詳細をクリックして開くと、作成日時、責任者、最終更新日時、データアドレス、説明を確認できます。また、上部にはオフラインTagが表示されます。
また、特徴名、フィールドタイプ、特徴説明などの特徴情報の確認をサポートし、主キーとタイムスタンプをマークします。
オンライン特徴テーブル詳細
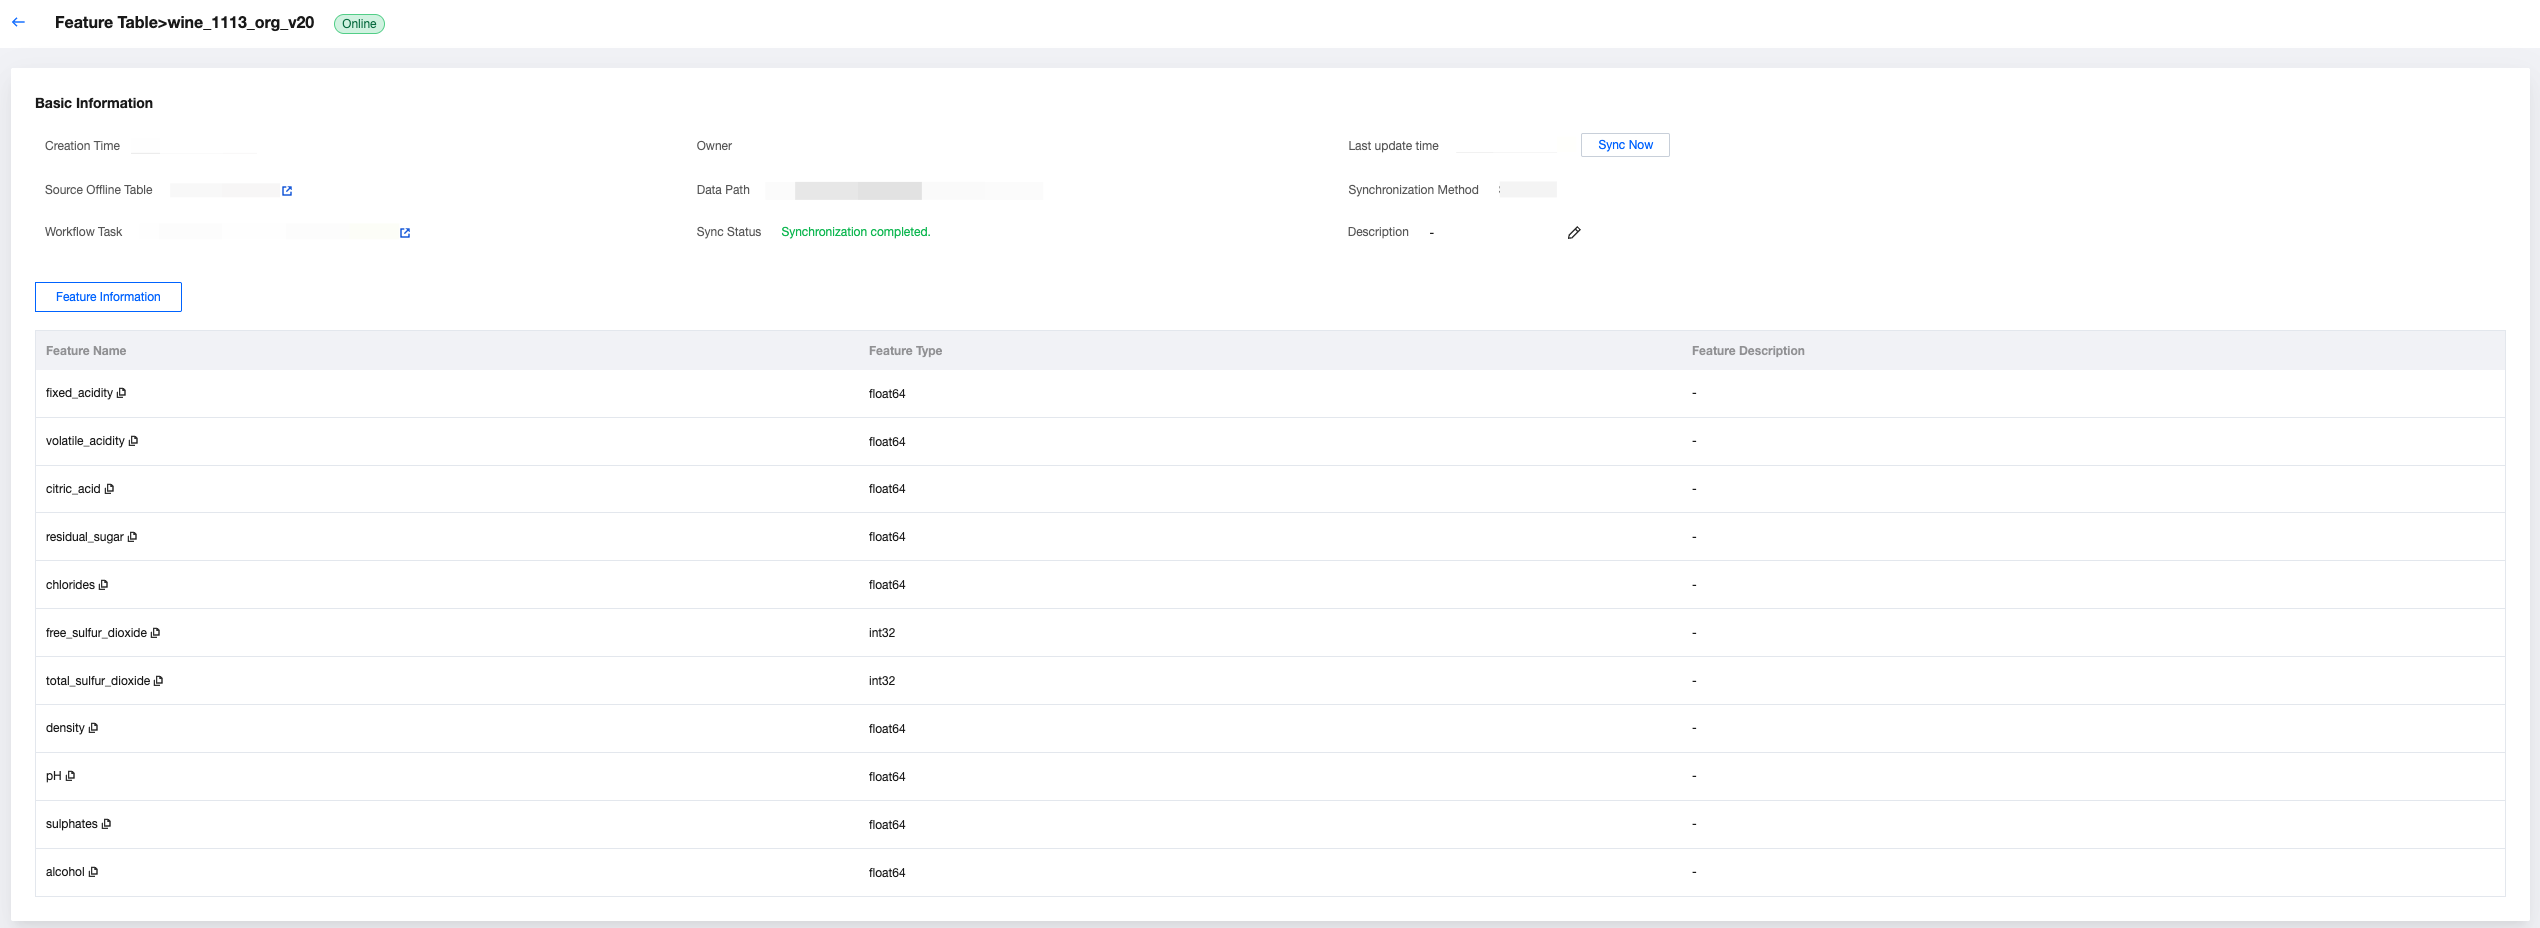
オンライン特徴テーブルの詳細をクリックして開くと、作成日時、責任者、同期時間(即時同期に対応)、ソースオフラインテーブル(クリックして対応するオフラインテーブルページに移動可能)、データアドレス、同期方式、ワークフロータスク(クリックして対応する特徴同期ワークフローのページに移動可能)、同期状態、説明を確認できます。
また、特徴名、フィールドタイプ、特徴説明などの特徴情報の確認をサポートし、主キーとタイムスタンプをマークします。
特徴量エンジニアリングAPI
FeatureStoreClientはWeData特徴ストアの統一クライアントであり、特徴テーブルの作成、登録、読み書き、トレーニングセットの作成、モデル記録などの機能を含む、特徴のライフサイクル全体にわたる管理能力を提供します。
説明:
特徴エンジニアリングパッケージの呼び出しにはTencentCloud APIのIDとキーが必要です。Tencent Cloud CAMにアクセスしてアクセスキーを作成できます。組織でキー情報を平文で送信できない場合は、Tencent Cloud SSMまたはTencent Cloud KMSを使用してキーを管理できます。
Catalog機能を有効にすると、一部のAPIではCatalog_nameを渡す必要があります。APIドキュメントを確認してください。
使用前に、Studioの実行環境に最新の特徴エンジニアリングAPIパッケージをインストールする必要があります。
%pip install tencent-wedata-feature-engineering
DLCエンジンを使用する場合、リソースグループを構築する際に「wedata-data-science」イメージを選択すると、特徴エンジニアリングパッケージがすでにプリインストールされているため、追加インストールは不要です。以下のコマンドを実行してバージョンを確認できます:
%pip list | grep tencent-wedata-feature-engineering
最新のバージョン情報は以下で確認できます:https://pypi.org/project/tencent-wedata-feature-engineering/#history
特徴量エンジニアリングクライアントの初期化
init
init APIはFeatureStoreClientインスタンスの初期化に使用できます。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
spark | はい | Optional[SparkSession] | 初期化済みのSparkSessionオブジェクトです。指定されていない場合は自動的に作成されます。 | SparkSession.builder.getOrCreate() |
cloud_secret_id | はい | str | クラウドサービスキーID | "your_secret_id" |
cloud_secret_key | はい | str | クラウドサービスキー | "your_secret_key" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
client | FeatureStoreClient | FeatureStoreClient インスタンスを返します。 |
呼び出し例
from wedata.feature_store.client import FeatureStoreClient# 特徴エンジニアリングクライアントインスタンスを構築します# create FeatureStoreClientclient = FeatureStoreClient(spark, cloud_secret_id=cloud_secret_id, cloud_secret_key=cloud_secret_key)
エラーコード
特定のエラーコードはありません。SparkSessionの作成に失敗すると、関連する例外がスローされます。
オフライン特徴テーブル操作
create_table
特徴テーブルを作成します(バッチおよびストリーミングデータの書き込みをサポートします)。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
name | はい | str | 特徴テーブルの正式名称(形式:<table>) | "user_features" |
primary_keys | はい | Union[str, List[str]] | 主キー列名(複合主キーに対応) | 「user_id」または[「user_id」、「session_id」] |
timestamp_key | はい | str | タイムスタンプキー(時態特徴に使用) | "timestamp" |
engine_type | はい | wedata.feature_store.constants.engine_types.EngineTypes | エンジンタイプ EngineTypes.HIVE_ENGINE -- HIVEエンジン EngineTypes. ICEBERG_ENGINE -- ICEBERGエンジン | EngineTypes.HIVE_ENGINE |
data_source_name | はい | str | データソース名 | "hive_datasource" |
database_name | いいえ | Optional[str] | データベース名 | "feature_db" |
df | いいえ | Optional[DataFrame] | 初期データ(スキーマの推論に使用) | spark.createDataFrame([...]) |
partition_columns | いいえ | Union[str, List[str], None] | パーティション列(ストレージクエリの最適化) | 「date」または[「date」、「region」] |
schema | いいえ | Optional[StructType] | テーブル構造定義(dfが提供されない場合は必須) | StructType([...]) |
description | いいえ | Optional[str] | 業務説明 | 「ユーザー特徴テーブル」 |
tags | いいえ | Optional[Dict[str, str]] | ビジネスタグ | {"domain": "user", "version": "v1"} |
catalog_name | カタログが有効になっていない場合は、入力する必要はありません。 カタログを有効にしている場合は、必ず入力してください。 | str | 特徴テーブルが存在するカタログ名 | "DataLakeCatalog" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
feature_table | FeatureTable | 特徴テーブルのメタデータを含む FeatureTable オブジェクト |
呼び出し例
from wedata.feature_store.constants.engine_types import EngineTypes# ユーザー特徴テーブルを作成します--EMR on hive# create user's feature table--EMR on hivefeature_table = client.create_table(name=table_name, # テーブル名primary_keys=["wine_id"], # 主キーdf=wine_features_df, # データengine_type=EngineTypes.HIVE_ENGINE,data_source_name=data_source_name,timestamp_key="event_timestamp",tags={ # ビジネスタグ"purpose": "demo","create_by": "wedata"})# ユーザー特徴テーブルを作成します--DLC on iceberg(catalogを有効にしません)# create user's feature table--DLC on iceberg(disable catalog)feature_table = client.create_table(name=table_name, # テーブル名database_name=database_name,primary_keys=["wine_id"], # 主キーdf=wine_features_df, # データengine_type=EngineTypes.ICEBERG_ENGINE,data_source_name=data_source_name,timestamp_key="event_timestamp",tags={ # ビジネスタグ"purpose": "demo","create_by": "wedata"})# ユーザー特徴テーブルを作成します--DLC on iceberg(catalogを有効にします)# create user's feature table--DLC on iceberg(enable catalog)feature_table = client.create_table(name=table_name, # テーブル名primary_keys=["wine_id"], # 主キーdf=wine_features_df, # データengine_type=EngineTypes.ICEBERG_ENGINE,data_source_name=data_source_name,timestamp_key="event_timestamp",tags={ # ビジネスタグ"purpose": "demo","create_by": "wedata"},catalog_name=catalog_name)
エラーコード
ValueError:スキーマとデータが一致しない場合にエラーが発生します。
register_table
通常のテーブルを特徴テーブルとして登録し、特徴テーブルデータを返します。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
name | はい | str | 特徴テーブル名 | "user_features" |
timestamp_key | はい | str | タイムスタンプキー(後続のオフライン・オンライン特徴同期に使用) | "timestamp" |
engine_type | はい | wedata.feature_store.constants.engine_types.EngineTypes | エンジンタイプ EngineTypes.HIVE_ENGINE -- HIVEエンジン EngineTypes. ICEBERG_ENGINE -- ICEBERGエンジン | EngineTypes.HIVE_ENGINE |
data_source_name | はい | str | データソース名 | "hive_datasource" |
database_name | いいえ | Optional[str] | 特徴ライブラリ名 | "feature_db" |
primary_keys | いいえ | Union[str, List[str]] | 主キー列名(engine_typeがEngineTypes.HIVE_ENGINEの場合のみ有効) | "user_id" |
catalog_name | カタログが有効になっていない場合は、入力する必要はありません。 カタログを有効にしている場合は、必ず入力してください。 | str | 特徴テーブルが存在するカタログ名 | "DataLakeCatalog" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
dataframe | pyspark.DataFrame | 特徴テーブルデータを含むDataFrameオブジェクト |
呼び出し例
from wedata.feature_store.constants.engine_types import EngineTypes# 特徴テーブルを登録します--EMR on hive# register feature table--EMR on hiveclient.register_table(database_name=database_name, name=register_table_name, timestamp_key="event_timestamp",engine_type=EngineTypes.HIVE_ENGINE, data_source_name=data_source_name, primary_keys=["wine_id",])# 特徴テーブルを登録します--DLC on iceberg(catalogを有効にしません)# register feature table--DLC on iceberg(disable catalog)client.register_table(database_name=database_name, name=register_table_name, timestamp_key="event_timestamp",engine_type=EngineTypes.ICEBERG_ENGINE, data_source_name=data_source_name, primary_keys=["wine_id",])# 特徴テーブルを登録します--DLC on iceberg(catalogを有効にします)# register feature table--DLC on iceberg(enable catalog)client.register_table(database_name=database_name, name=register_table_name, timestamp_key="event_timestamp",engine_type=EngineTypes.HIVE_ENGINE, data_source_name=data_source_name, primary_keys=["wine_id",], catalog_name=catalog_name)
エラーコード
特定のエラーコードはありません。
read_table
特徴テーブルデータを読み取ります。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
name | はい | str | 特徴テーブル名 | "user_features" |
database_name | いいえ | Optional[str] | 特徴ライブラリ名 | "feature_db" |
is_online | いいえ | bool | オンライン特徴テーブルを読み取るかどうか(デフォルトはFalse) | True |
online_config | いいえ | Optional[RedisStoreConfig] | オンライン特徴テーブル設定(is_onlineがTrueの場合のみ有効) | RedisStoreConfig(...) |
entity_row | いいえ | Optional[List[Dict[str, Any]]] | エンティティ行データ(is_onlineがTrueの場合のみ有効) | [{"user_id": ["123", "456"]}] |
catalog_name | カタログが有効になっていない場合は、入力する必要はありません。 カタログを有効にしている場合は、必ず入力してください。 | str | 特徴テーブルが存在するカタログ名 | "DataLakeCatalog" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
dataframe | pyspark.DataFrame | 特徴テーブルデータを含むDataFrameオブジェクト |
呼び出し例
# オフライン特徴テーブルを読み取ります--EMR on hive--&--DLC on iceberg(catalogを有効にしません)# read offline feature table--EMR on hive--&--DLC on iceberg(disable catalog)get_df = client.read_table(name=table_name, database_name=database_name)get_df.show(30)# オンライン特徴テーブルを読み取ります--EMR on hive--&--DLC on iceberg(catalogを有効にしません)# read online feature table--EMR on hive--&--DLC on iceberg(disable catalog)online_config = RedisStoreConfig(host=redis_host, port=redis_password, db=redis_db, password=redis_password)primary_keys_rows = [{"wine_id": 1},{"wine_id": 3}]result = client.read_table(name=table_name,database_name=database_name, is_online=True, online_config=online_config, entity_row=primary_keys_rows)result.show()# オフライン特徴テーブルを読み取ります--DLC on iceberg(catalogを有効にします)# read offline feature table--DLC on iceberg(enable catalog)get_df = client.read_table(name=table_name, database_name=database_name, catalog_name=catalog_name)get_df.show(30)# オンライン特徴テーブルを読み取ります--DLC on iceberg(catalogを有効にします)# read online feature table--DLC on iceberg(enable catalog)primary_keys_rows = [{"wine_id": 1},{"wine_id": 3}]result = client.read_table(name=table_name,database_name=database_name, is_online=True, online_config=online_config, entity_row=primary_keys_rows, catalog_name=catalog_name)result.show()
エラーコード
特定のエラーコードはありません。
get_table
特徴テーブルデータを取得します。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
name | はい | str | 特徴テーブル名 | "user_features" |
database_name | いいえ | Optional[str] | 特徴ライブラリ名 | "feature_db" |
catalog_name | カタログが有効になっていない場合は、入力する必要はありません。 カタログを有効にしている場合は、必ず入力してください。 | str | 特徴テーブルが存在するカタログ名 | "DataLakeCatalog" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
feature_table | FeatureTable | 特徴テーブルのメタデータを含む FeatureTable オブジェクト |
呼び出し例
# 特徴テーブルデータを取得します--EMR on hive--&--DLC on iceberg(catalogを有効にしません)# get feature table data--EMR on hive--&--DLC on iceberg(disable catalog)featureTable = client.get_table(name=table_name, database_name=database_name)# オンライン特徴テーブルを読み取ります--DLC on iceberg(catalogを有効にします)# get feature table data--DLC on iceberg(enable catalog)featureTable = client.get_table(name=table_name, database_name=database_name, catalog_name=catalog_name)
エラーコード
特定のエラーコードはありません。
drop_table
特徴テーブルを削除します。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
name | はい | str | 削除する特徴テーブル名 | "user_features" |
database_name | いいえ | Optional[str] | 特徴ライブラリ名 | "feature_db" |
catalog_name | カタログを有効にしている場合は、必ず入力してください。 | str | 特徴テーブルが存在するカタログ名 | "DataLakeCatalog" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
無 | None | 戻り値はありません。 |
呼び出し例
# 特徴テーブルを削除します--EMR on hive--&--DLC on iceberg(catalogを有効にしません)# drop feature table data--EMR on hive--&--DLC on iceberg(disable catalog)client.drop_table(table_name)# 特徴テーブルを削除します--DLC on iceberg(catalogを有効にします)# drop feature table data--DLC on iceberg(enable catalog)client.drop_table(table_name,catalog_name="DataLakeCatalog")
エラーコード
特定のエラーコードはありません。
write_table
データを特徴テーブルに書き込みます(バッチ処理とストリーミング処理をサポートします)。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
name | はい | str | 特徴テーブルの正式名称(形式:<table>) | "user_features" |
df | いいえ | Optional[DataFrame] | 書き込むデータのDataFrame。 | spark.createDataFrame([...]) |
database_name | いいえ | Optional[str] | 特徴ライブラリ名 | "feature_db" |
mode | いいえ | Optional[str] | 書き込みモード(デフォルトはAPPEND) | "overwrite" |
checkpoint_location | いいえ | Optional[str] | ストリーミング処理のチェックポイントの場所 | "/checkpoints/user_features" |
trigger | いいえ | Dict[str, Any] | ストリーミング処理トリガーの設定 | {"processingTime": "10 seconds"} |
catalog_name | カタログが有効になっていない場合は、入力する必要はありません。 カタログを有効にしている場合は、必ず入力してください。 | str | 特徴テーブルが存在するカタログ名 | "DataLakeCatalog" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
streaming_query | Optional[StreamingQuery] | ストリーミング書き込みの場合はStreamingQueryオブジェクトを返し、それ以外の場合はNoneを返します。 |
呼び出し例
from wedata.feature_store.constants.constants import APPEND# バッチ書き込み--EMR on hive--&--DLC on iceberg(catalogを有効にしません)# batch write--EMR on hive--&--DLC on iceberg(disable catalog)client.write_table(name="user_features",df=user_data_df,database_name="feature_db",mode="append")# ストリーミング処理書き込み--EMR on hive--&--DLC on iceberg(catalogを有効にしません)# strem write--EMR on hive--&--DLC on iceberg(disable catalog)streaming_query = client.write_table(name="user_features",df=streaming_df,database_name="feature_db",checkpoint_location="/checkpoints/user_features",trigger={"processingTime": "10 seconds"})# バッチ書き込み--DLC on iceberg(catalogを有効にします)# batch write--EMR on hive--&--DLC on iceberg(enable catalog)client.write_table(name="user_features",df=user_data_df,database_name="feature_db",mode="append",catalog_name=catalog_name)# ストリーミング処理書き込み--DLC on iceberg(catalogを有効にします)# strem write--EMR on hive--&--DLC on iceberg(enable catalog)streaming_query = client.write_table(name="user_features",df=streaming_df,database_name="feature_db",checkpoint_location="/checkpoints/user_features",trigger={"processingTime": "10 seconds"},catalog_name=catalog_name)
エラーコード
特定のエラーコードはありません。
オフライン特徴利用
Feature Lookup
特徴テーブルに対して特徴検索を行います。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
table_name | はい | str | 特徴テーブルの名前 | "user_features" |
lookup_key | はい | Union[str, List[str]] | 特徴テーブルと訓練セットの間で結合するためのキーで、通常は主キーを使用します。 | 「user_id」または[「user_id」、「session_id」] |
is_online | いいえ | bool | オンライン特徴テーブルを読み取るかどうか(デフォルトはFalse) | True |
online_config | いいえ | Optional[RedisStoreConfig] | オンライン特徴テーブル設定(is_onlineがTrueの場合のみ有効) | RedisStoreConfig(...) |
feature_names | いいえ | Union[str, List[str], None] | 特徴テーブルから検索する特徴名 | ["age", "gender", "preferences"] |
rename_outputs | いいえ | Optional[Dict[str, str]] | 特徴の名前変更マッピング | {"age": "user_age"} |
timestamp_lookup_key | いいえ | Optional[str] | 時点検索に使用するタイムスタンプキー | "event_timestamp" |
lookback_window | いいえ | Optional[datetime.timedelta] | 時点検索の回溯ウィンドウ | datetime.timedelta(days=1) |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
FeatureLookup オブジェクト | FeatureLookup | 構築済みのFeatureLookupインスタンス |
呼び出し例
from wedata.feature_store.entities.feature_lookup import FeatureLookup# 特徴検索--EMR on hive--&--DLC on iceberg(catalogを有効にしません)--&--DLC on iceberg(catalogを有効にします)# feature lookup--EMR on hive--&--DLC on iceberg(disable catalog)--&--DLC on iceberg(enable catalog)wine_feature_lookup = FeatureLookup(table_name=table_name,lookup_key="wine_id",timestamp_lookup_key="event_timestamp")
エラーコード
特定のエラーコードはありません。
create_training_set
特徴テーブルに対して特徴検索を行います。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
df | いいえ | Optional[DataFrame] | 書き込むデータのDataFrame。 | spark.createDataFrame([...]) |
feature_lookups | はい | List[Union[FeatureLookup, FeatureFunction]] | 特徴クエリリスト | [FeatureLookup(...), FeatureFunction(...)] |
label | はい | Union[str, List[str], None] | タグ列名 | 「is_churn」または[「label1」、「label2」] |
exclude_columns | いいえ | Optional[List[str]] | 除外列名 | ["user_id", "timestamp"] |
database_name | いいえ | Optional[str] | 特徴ライブラリ名 | "feature_db" |
catalog_name | カタログが有効になっていない場合は、入力する必要はありません。 カタログを有効にしている場合は、必ず入力してください。 | str | 特徴テーブルが存在するカタログ名 | "DataLakeCatalog" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
training_set | TrainingSet | 構築済みのTrainingSetインスタンス |
呼び出し例
from wedata.feature_store.entities.feature_lookup import FeatureLookupfrom wedata.feature_store.entities.feature_function import FeatureFunction# 特徴検索の定義# define feature lookupwine_feature_lookup = FeatureLookup(table_name=table_name,lookup_key="wine_id",timestamp_lookup_key="event_timestamp")# 学習データの構築# prepare training datainference_data_df = wine_df.select(f"wine_id", "quality", "event_timestamp")# 学習セットを作成します--EMR on hive--&--DLC on iceberg(catalogを有効にしません)# create trainingset--EMR on hive--&--DLC on iceberg(disable catalog)training_set = client.create_training_set(df=inference_data_df, # 基礎データfeature_lookups=[wine_feature_lookup], # 特徴検索の設定label="quality", # タグ列exclude_columns=["wine_id", "event_timestamp"] # 不要な列を除外します)# 学習セットを作成します--DLC on iceberg(catalogを有効にします)# create trainingset--DLC on iceberg(enable catalog)training_set = client.create_training_set(df=inference_data_df, # 基礎データfeature_lookups=[wine_feature_lookup], # 特徴検索の設定label="quality", # タグ列exclude_columns=["wine_id", "event_timestamp"], # 不要な列を除外しますdatabase_name=database_name,catalog_name=catalog_name)# 最終的な学習用DataFrameを取得します# get final training DataFrametraining_df = training_set.load_df()# 学習セットデータを出力します# print trainingset dataprint(f"\\n=== 学習セットデータ ===")training_df.show(10, True)
エラーコード
ValueError: FeatureLookup は table_name を指定する必要があります。
log_model
MLflowモデルを記録し、特徴検索情報を関連付けます。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
model | はい | Any | 記録するモデルオブジェクト | sklearn.RandomForestClassifier() |
artifact_path | はい | str | モデル保存パス | "churn_model" |
flavor | はい | ModuleType | MLflow モデルタイプモジュール | mlflow.sklearn |
training_set | いいえ | Optional[TrainingSet] | モデルトレーニングに使用するTrainingSetオブジェクト | training_set |
registered_model_name | いいえ | Optional[str] | 登録するモデル名(カタログを有効にした後は、カタログのモデル名を記入する必要があります) | "churn_prediction_model" |
model_registry_uri | いいえ | Optional[str] | モデルレジストリアドレス | "databricks://model-registry" |
await_registration_for | いいえ | int | モデル登録の完了を待機する秒数(デフォルトは300秒) | 600 |
infer_input_example | いいえ | bool | 入力例を自動的に記録するかどうか(デフォルトはFalse) | True |
出力パラメータ
無
呼び出し例
# モデルを学習します# train modelfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import classification_reportfrom sklearn.ensemble import RandomForestClassifierimport mlflow.sklearnimport pandas as pdimport osproject_id=os.environ["WEDATA_PROJECT_ID"]mlflow.set_experiment(experiment_name=expirement_name)# mlflow情報報告アドレスを設定します。# set mlflow tracking_urimlflow.set_tracking_uri("http://30.22.36.75:5000")# Spark DataFrameをPandas DataFrameに変換して学習に使用します。# convert Spark DataFrame to Pandas DataFrame to traintrain_pd = training_df.toPandas()# タイムスタンプ列を削除します。# delete timestamp# train_pd.drop('event_timestamp', axis=1)# 特徴量とラベルを準備します。# prepare features and tagsX = train_pd.drop('quality', axis=1)y = train_pd['quality']# 学習セットとテストセットを分割します。# split traningset and testsetX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# または日付をタイムスタンプ(秒)に変換します。# or convert datatime to timestamp(second)for col in X_train.select_dtypes(include=['datetime', 'datetimetz']):X_train[col] = X_train[col].astype('int64') // 10**9 # ナノ秒→秒# 欠損値によってdtypeがobjectにダウングレードされていないことを確認します。# Verify that no missing values cause the dtype to be downgraded to object.X_train = X_train.fillna(X_train.median(numeric_only=True))# モデルを初期化して学習し、モデルを記録します--EMR on hive--&--DLC on iceberg(catalogを有効にしません)--&--DLC on iceberg(catalogを有効にします)# Initialize, train and log the model.--EMR on hive--&--DLC on iceberg(disable catalog)--&--DLC on iceberg(enable catalog)model = RandomForestClassifier(n_estimators=100, max_depth=3, random_state=42)model.fit(X_train, y_train)with mlflow.start_run():client.log_model(model=model,artifact_path="wine_quality_prediction", # モデルファイルのパス名model artifact pathflavor=mlflow.sklearn,training_set=training_set,registered_model_name=model_name, # モデル名(catalogを有効にした後はcatalogのモデル名を記述する必要があります)model name(if enable catalog, must be catalog model name))
エラーコード
特定のエラーコードはありません。
score_batch
バッチ推論を実行します。入力特徴量が欠落している場合(ただし、対応する主キーを渡す必要があることに注意してください)、推論プロセス中にモデルに記録されたfeature_specファイルに従って特徴量補完が自動的に実行されます。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
model_uri | はい | str | MLflowモデルのURIの場所 | "models:/churn_model/1" |
df | はい | DataFrame | 推論するDataFrame。 | spark.createDataFrame([...]) |
result_type | いいえ | str | モデルの戻り値の型(デフォルトは「double」) | "string" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
predictions | DataFrame | 予測結果を含むDataFrame |
呼び出し例
# score_batchを実行します--EMR on hive--&--DLC on iceberg(catalogを有効にしません)--&--DLC on iceberg(catalogを有効にします)# run score_batch--EMR on hive--&--DLC on iceberg(disable catalog)--&--DLC on iceberg(enable catalog)result = client.score_batch(model_uri=f"models:/{model_name}/1", df=wine_df)result.show()
エラーコード
特定のエラーコードはありません。
オンライン特徴テーブル操作
publish_table
オフライン特徴テーブルをオンライン特徴テーブルとして公開します。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
table_name | はい | str | オフライン特徴テーブルの正式名称(形式:<table>) | "user_features" |
data_source_name | はい | str | データソース名 | "hive_datasource" |
database_name | いいえ | Optional[str] | データベース名 | "feature_db" |
is_cycle | いいえ | bool | 定期的な公開を有効にするかどうか(デフォルトはFalse) | True |
cycle_obj | いいえ | TaskSchedulerConfiguration | 定期的なタスク設定オブジェクト | TaskSchedulerConfiguration(...) |
is_use_default_online | いいえ | bool | デフォルトのオンラインストレージ設定を使用するかどうか(デフォルトはTrue) | False |
online_config | いいえ | RedisStoreConfig | カスタムオンラインストレージ設定 | RedisStoreConfig(...) |
catalog_name | カタログが有効になっていない場合は、入力する必要はありません。 カタログを有効にしている場合は、必ず入力してください。 | str | 特徴テーブルが存在するカタログ名 | "DataLakeCatalog" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
無 | None | 戻り値はありません。 |
呼び出し例
from wedata.feature_store.common.store_config.redis import RedisStoreConfigfrom wedata.feature_store.cloud_sdk_client.models import TaskSchedulerConfigurationonline_config = RedisStoreConfig(host=redis_host, port=redis_password, db=redis_db, password=redis_password)# オフライン特徴テーブルをオンライン特徴テーブルとして公開します--EMR on hive--&--DLC on iceberg(catalogを有効にしません)# publish a offline feature table to online feature table--EMR on hive--&--DLC on iceberg(disable catalog)# Case 1 オフラインテーブルtable_nameを指定のオフラインデータソースからデフォルトのオンラインデータソースに渡し、スナップショット方式を採用します。# Case 1 Pass the offline table table_name from the specified offline data source to the default online data source in snapshot mode.result = client.publish_table(table_name=table_name, data_source_name=data_source_name, database_name=database_name,is_cycle=False, is_use_default_online=True)# Case 2 オフラインテーブルtable_nameを指定のオフラインデータソースから指定のデータソース(デフォルト以外)に渡し、スナップショット方式を採用します。ここでのIPは、登録済みデータソースにログインする際のデータソースIP情報と一致している必要があります。# Case 2 Sync the offline table table_name from the specified offline data source to the designated non-default data source in snapshot mode. Note that the IP address here must be consistent with the login IP information of the entered data source.result = client.publish_table(name=table_name, data_source_name=data_source_name, database_name=database_name,is_cycle=False, is_use_default_online=False, online_config=online_config)# Case 3 オフラインテーブルtable_nameを指定のオフラインデータソースからデフォルトのオンラインデータソースに渡し、周期方式を採用して、5分ごとに実行します。# Sync the offline table table_name from the specified offline data source to the default online data source in cycle mode, with a run interval of every five minutes.cycle_obj = TaskSchedulerConfiguration()cycle_obj.CrontabExpression = "0 0/5 * * * ?"result = client.publish_table(name=table_name, data_source_name=data_source_name, database_name=database_name,is_cycle=True, cycle_obj=cycle_obj, is_use_default_online=True)# オフライン特徴テーブルをオンライン特徴テーブルとして公開します--DLC on iceberg(catalogを有効にします)# publish a offline feature table to online feature table--DLC on iceberg(enable catalog)# Case 1 オフラインテーブルtable_nameを指定のオフラインデータソースからデフォルトのオンラインデータソースに渡し、スナップショット方式を採用します。# Case 1 Pass the offline table table_name from the specified offline data source to the default online data source in snapshot mode.result = client.publish_table(table_name=table_name, data_source_name=data_source_name, database_name=database_name,is_cycle=False, is_use_default_online=True, catalog_name=catalog_name)# Case 2 オフラインテーブルtable_nameを指定のオフラインデータソースから指定のデータソース(デフォルト以外)に渡し、スナップショット方式を採用します。ここでのIPは、登録済みデータソースにログインする際のデータソースIP情報と一致している必要があります。# Case 2 Sync the offline table table_name from the specified offline data source to the designated non-default data source in snapshot mode. Note that the IP address here must be consistent with the login IP information of the entered data source.result = client.publish_table(table_name=table_name, data_source_name=data_source_name, database_name=database_name,is_cycle=False, is_use_default_online=False, online_config=online_config, catalog_name=catalog_name)# Case 3 オフラインテーブルtable_nameを指定のオフラインデータソースからデフォルトのオンラインデータソースに渡し、周期方式を採用して、5分ごとに実行します。# Sync the offline table table_name from the specified offline data source to the default online data source in cycle mode, with a run interval of every five minutes.cycle_obj = TaskSchedulerConfiguration()cycle_obj.CrontabExpression = "0 0/5 * * * ?"result = client.publish_table(table_name=table_name, data_source_name=data_source_name, database_name=database_name,is_cycle=True, cycle_obj=cycle_obj, is_use_default_online=True, catalog_name=catalog_name)
エラーコード
特定のエラーコードはありません。
drop_online_table
オンライン特徴テーブルを削除します。
入力パラメータ
パラメータ名 | 必須/任意 | フィールドタイプ | フィールド説明 | 入力パラメータ例 |
table_name | はい | str | オフライン特徴テーブルの正式名称(形式:<table>) | "user_features" |
online_config | いいえ | RedisStoreConfig | カスタムオンラインストレージ設定 | RedisStoreConfig(...) |
database_name | いいえ | Optional[str] | データベース名 | "feature_db" |
出力パラメータ
結果名 | フィールドタイプ | フィールド説明 |
無 | None | 戻り値はありません。 |
呼び出し例
from wedata.feature_store.common.store_config.redis import RedisStoreConfig# オンラインテーブルを削除します--EMR on hive--&--DLC on iceberg(catalogを有効にしません)--&--DLC on iceberg(catalogを有効にします)# delete online feature table--EMR on hive--&--DLC on iceberg(disable catalog)--&--DLC on iceberg(enable catalog)online_config = RedisStoreConfig(host=redis_host, port=redis_password, db=redis_db, password=redis_password)client.drop_online_table(table_name=table_name, database_name=database_name, online_config=online_config)
エラーコード
特定のエラーコードはありません。
フィードバック