FileSystemデータソース
ダウンロード
フォーカスモード
フォントサイズ
利用制限
SMB共有ファイルシステムをサポートします:SMB(Server Message Block、サーバーメッセージブロックプロトコル)に基づくネットワークファイル共有メカニズムです。
FileSystemオフライン単一テーブル読み取りノードの設定
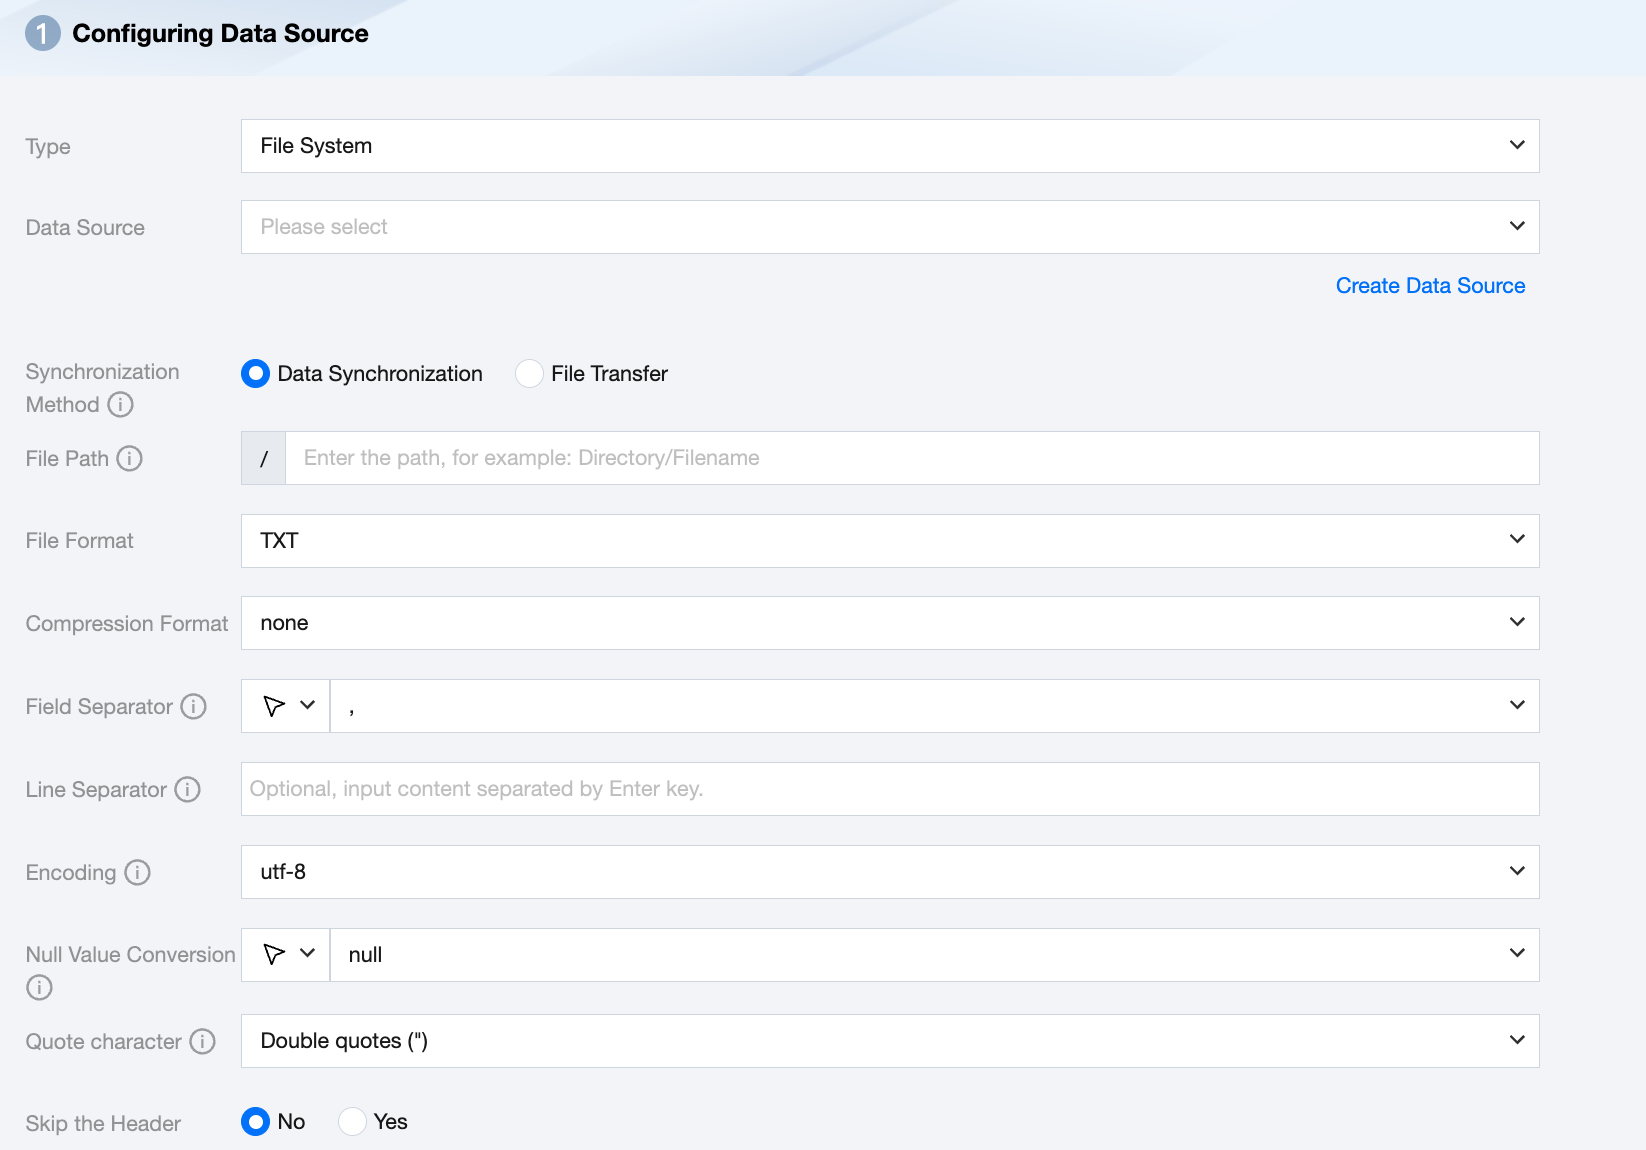
パラメータ | 説明 |
データソース | 現在のプロジェクトで利用可能なFileSystemデータソースを選択します。 |
同期方式 | FileSystemは2つの同期方式をサポートしています: データ同期:構造化データの内容を解析し、フィールド関係に基づいてデータ内容のマッピングと同期を行います。 ファイル転送:内容の解析を行わずにファイル全体を転送し、非構造化データの同期に適用できます。 注意: ファイル転送は、ソース側とターゲット側の両方がファイルタイプ(COS/HDFS/SFTP/FTP/Azure Blob/FileSystem/S3/Http)であるデータソースのみをサポートします。また、ソース側とターゲット側の同期方式は、いずれもファイル転送である必要があります。 |
ファイルパス | FileSystemファイルシステムのパスでは、*ワイルドカードを使用できます(ワイルドカードはパスの最後の階層にのみ使用できます。例:/a/b/c/file*)。 |
ファイルタイプ | FileSystemは、TXT、CSV、JSONの3種類のファイルタイプをサポートしています。 TXT:TextFileファイル形式を表します。 CSV:通常のHDFSファイル形式(論理的な2次元テーブル)を表します。 JSON:JSONファイル形式を表します。 |
フィールド区切り文字 | TXT/CSVファイルタイプで、データ同期方式で読み取る際に設定するフィールド区切り文字です。デフォルトでは(,)が入力されます。 注意: ${}を区切り文字として使用することはできません。${a}は設定されたパラメータaとして認識されます。 |
行区切り文字(任意) | TXT/CSVファイルタイプで、データ同期方式で読み取る際に設定する行区切り文字です。最大3つの値を入力でき、入力した複数の値はすべて行区切り文字として使用されます。入力しない場合、linuxのデフォルトは\\n、windowsのデフォルトは\\r\\nです。 注意: 1. 複数の行区切り文字を設定すると、読み取りパフォーマンスに影響します。 2. ${}を区切り文字として使用することはできません。${a}は設定されたパラメータaとして認識されます。 |
エンコーディング | ファイル読み取り時のエンコーディング設定です。utf8とgbkの2種類のエンコーディングをサポートしています。 |
NULL変換 | 読み取り時に、指定された文字列をNULLに変換します。NULLは未知または適用できない値を表し、0、空文字列、その他の数値とは異なります。 注意: ${}を指定文字列として使用することはできません。${a}は設定されたパラメータaとして認識されます。 |
圧縮形式 | 現在サポートしている形式:none、deflate、gzip、bzip2、lz4、snappy。 snappyには現在統一されたstream formatがないため、Data Integrationは現在、最も主流なもののみをサポートしています: hadoop-snappy(hadoop上のsnappy stream format) framing-snappy(googleが推奨するsnappy stream format) |
Quote character | 設定なし:ソース側はデータの元の内容に従って読み取りを行います。 二重引用符("):ソース側は二重引用符(")内の値をデータ内容として読み取ります。 注意:データ形式が正しくない場合、読み取り時にOOMが発生する可能性があります。 一重引用符('):ソース側は一重引用符(')内の値をデータ内容として読み取ります。 注意:データ形式が正しくない場合、読み取り時にOOMが発生する可能性があります。 |
ヘッダー行をスキップ | いいえ:読み取り時にヘッダーをスキップしません。 はい:読み取り時にヘッダーをスキップします。 |
データ型変換のサポート
読み取り
FileSystem読み取りでサポートされるデータ型および変換対応関係は以下の通りです:
FileSystemデータ型 | 内部型 |
INTEGER、LONG | LONG |
FLOAT、DOUBLE | DOUBLE |
STRING | STRING |
BOOL | BOOLEAN |
DATE、TIMESTAMP | DATE |
フィードバック