S3データソース
ダウンロード
フォーカスモード
フォントサイズ
S3オフライン単一テーブル読み取りノードの設定
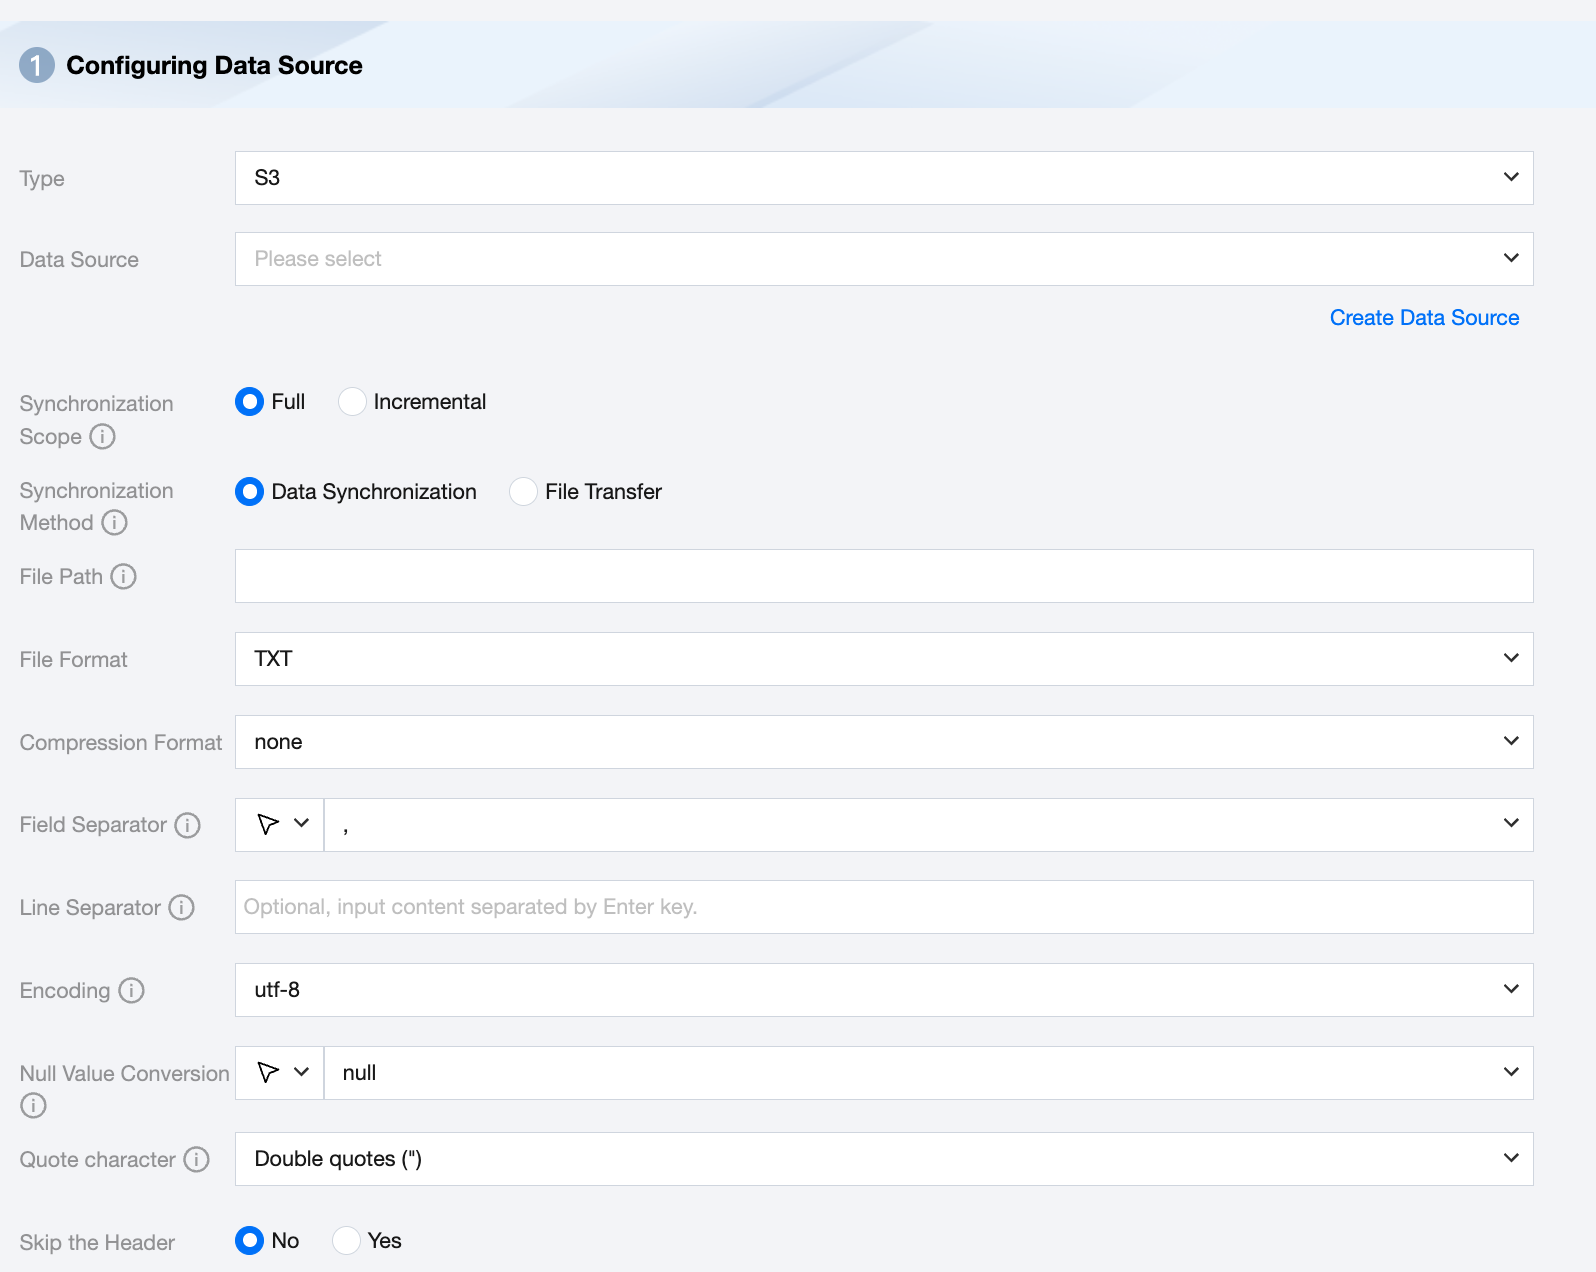
パラメータ | 説明 |
データソース | 現在のプロジェクトで利用可能なS3データソースを選択します。 |
同期範囲 | 全量:同期範囲はファイルパス配下のすべてのファイルです。 増分:同期範囲は、ファイルパス配下で前周期の計画スケジュール時間から今周期の計画スケジュール時間までの間に更新されたファイルです。同期タスクをデバッグする際、増分同期を選択した場合、デフォルトでファイルパス配下のすべてのファイルを同期します。 注意: 同期範囲は、ファイルパスがファイルディレクトリの形式である場合にのみ有効です。パスがファイルまで具体的に指定されている場合、同期範囲は有効にならず、ファイルに基づいて同期が行われます。 |
同期方式 | S3は2つの同期方式をサポートしています: データ同期:構造化データの内容を解析し、フィールド関係に基づいてデータ内容のマッピングと同期を行います。 ファイル転送:内容の解析を行わずにファイル全体を転送し、非構造化データの同期に適用できます。 注意: ファイル転送は、ソース側とターゲット側の両方がファイルタイプ(COS/HDFS/SFTP/FTP/S3/Azure Blob/Http)であるデータソースのみをサポートします。また、ソース側とターゲット側の同期方式は、いずれもファイル転送である必要があります。 |
ファイルパス | S3ファイルシステムのパスでは、*ワイルドカードを使用できます。 S3ファイルパスにはバケット名を含める必要があります。例:s3a://bucket_name。 |
ファイルタイプ | S3は、TXT、ORC、PARQUET、CSV、JSONの5種類のファイルタイプをサポートしています。 TXT:TextFileファイル形式を表します。 ORC:ORCFileファイル形式を表します。 PARQUET:通常のParquetファイル形式を表します。 CSV:通常のHDFSファイル形式(論理的な2次元テーブル)を表します。 JSON:JSONファイル形式を表します。 |
フィールド区切り文字 | TXT/CSVファイルタイプで、データ同期方式で読み取る際に設定するフィールド区切り文字です。デフォルトでは(,)が入力されます。 注意: ${}を区切り文字として使用することはできません。${a}は設定されたパラメータaとして認識されます。 |
行区切り文字(任意) | TXT/CSVファイルタイプで、データ同期方式で読み取る際に設定する行区切り文字です。最大3つの値を入力でき、入力した複数の値はすべて行区切り文字として使用されます。入力しない場合、linuxのデフォルトは\\n、windowsのデフォルトは\\r\\nです。 注意: 1. 複数の行区切り文字を設定すると、読み取りパフォーマンスに影響します。 2. ${}を区切り文字として使用することはできません。${a}は設定されたパラメータaとして認識されます。 |
エンコーディング | ファイル読み取り時のエンコーディング設定です。utf8とgbkの2種類のエンコーディングをサポートしています。 |
NULL変換 | 読み取り時に、指定された文字列をNULLに変換します。NULLは未知または適用できない値を表し、0、空文字列、その他の数値とは異なります。 注意: ${}を指定文字列として使用することはできません。${a}は設定されたパラメータaとして認識されます。 |
圧縮形式 | 現在サポートしている形式:none、deflate、gzip、bzip2、lz4、snappy。 snappyには現在統一されたstream formatがないため、Data Integrationは現在、最も主流なもののみをサポートしています: hadoop-snappy(hadoop上のsnappy stream format) framing-snappy(googleが推奨するsnappy stream format) |
Quote character | 設定なし:ソース側はデータの元の内容に従って読み取りを行います。 二重引用符("):ソース側は二重引用符(")内の値をデータ内容として読み取ります。注意:データ形式が正しくない場合、読み取り時にOOMが発生する可能性があります。 一重引用符('):ソース側は一重引用符(')内の値をデータ内容として読み取ります。注意:データ形式が正しくない場合、読み取り時にOOMが発生する可能性があります。 |
ヘッダー行をスキップ | いいえ:読み取り時にヘッダーをスキップしません。 はい:読み取り時にヘッダーをスキップします。 |
S3オフライン単一テーブル書き込みノードの設定
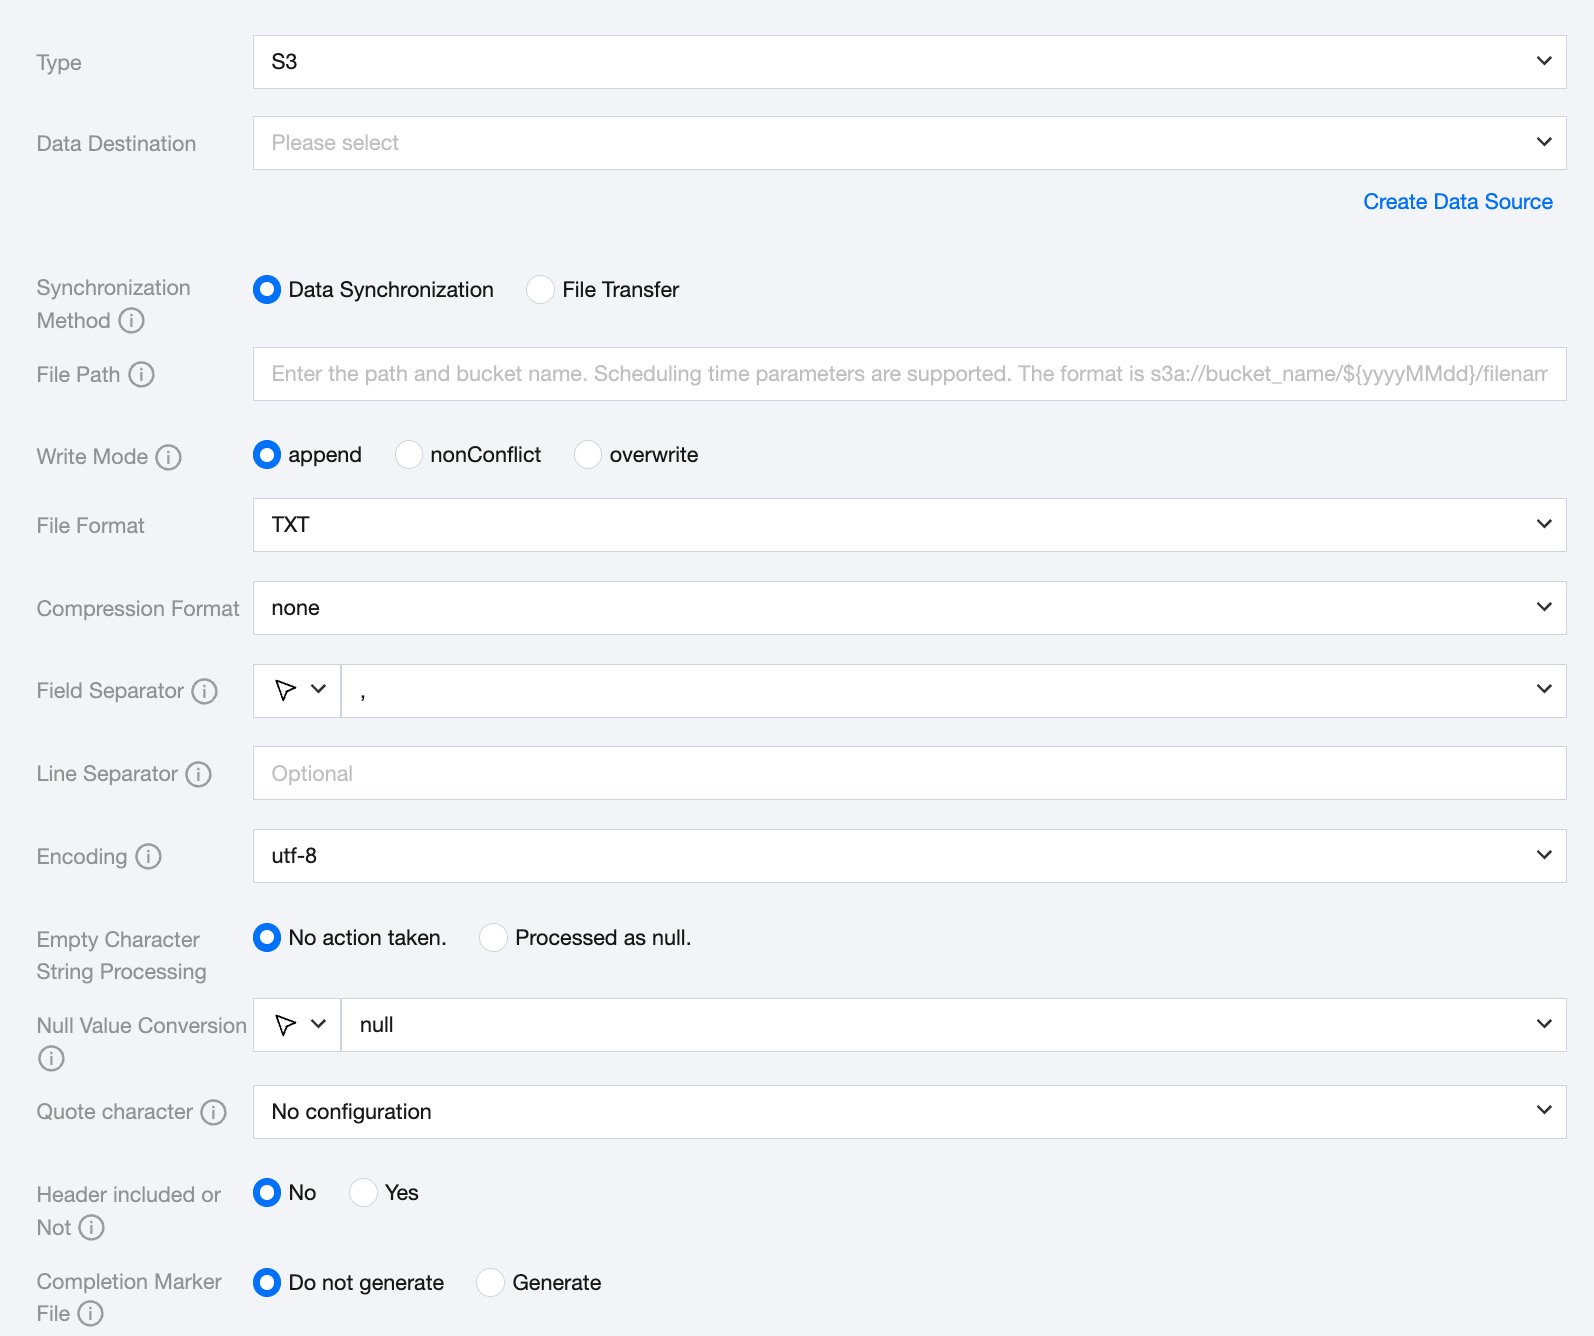
パラメータ | 説明 |
データソース | 現在のプロジェクトで利用可能なS3データソースを選択します。 |
同期方式 | S3は2つの同期方式をサポートしています: データ同期:構造化データの内容を解析し、フィールド関係に基づいてデータ内容のマッピングと同期を行います。 ファイル転送:内容の解析を行わずにファイル全体を転送し、非構造化データの同期に適用できます。 注意: ファイル転送は、ソース側とターゲット側の両方がファイルタイプ(COS/HDFS/SFTP/FTP/S3/Azure Blob/Http)であるデータソースのみをサポートします。また、ソース側とターゲット側の同期方式は、いずれもファイル転送である必要があります。 |
ファイルパス | S3ファイルシステムのパスに書き込みます。 S3ファイルパスにはバケット名を含める必要があります。例:s3a://bucket_name。 |
書き込みモード | overwrite:書き込み前にファイル名をプレフィックスとするすべてのファイルをクリーンアップします。 append:書き込み前に何も処理を行わず、ファイル名が競合しないことを保証します。 nonConflict:ファイル名が重複した場合にエラーが発生します。 |
ファイルタイプ | S3は、TXT、ORC、PARQUET、CSVの4種類のファイルタイプをサポートしています。 TXT:TextFileファイル形式を表します。 ORC:ORCFileファイル形式を表します。 PARQUET:通常のParquetファイル形式を表します。 CSV:通常のHDFSファイル形式(論理的な2次元テーブル)を表します。 |
フィールド区切り文字 | TXT/CSVファイルタイプで、データ同期方式で書き込む際に設定するフィールド区切り文字です。デフォルトでは(,)が入力されます。 注意: ${}を区切り文字として使用することはできません。${a}は設定されたパラメータaとして認識されます。 |
行区切り文字(任意) | TXT/CSVファイルタイプで、データ同期方式で書き込む際に設定する行区切り文字です。入力した複数の値はすべて行区切り文字として使用されます。入力しない場合、linuxのデフォルトは\\n、windowsのデフォルトは\\r\\nです。手動で入力する場合、1つの値をターゲット側の行区切り文字として入力してデータを書き込むことができます。 注意:${} は区切り文字としてサポートされていません。${a} は設定パラメータ a として認識されます。 |
エンコーディング | ファイル書き込み時のエンコーディング設定です。utf8とgbkの2種類のエンコーディングをサポートしています。 |
空文字列の処理 | 処理なし:書き込み時に空文字列を処理しません。 NULLとして処理:書き込み時に空文字列をNULLとして処理します。 |
NULL変換 | 書き込み時に、NULLを指定された文字列に変換します。NULLは未知または適用できない値を表し、0、空文字列、その他の数値とは異なります。 注意: ${}を指定文字列として使用することはできません。${a}は設定されたパラメータaとして認識されます。 |
圧縮形式 | 現在サポートしている形式:none、deflate、gzip、bzip2、lz4、snappy。 snappyには現在統一されたstream formatがないため、Data Integrationは現在、最も主流なもののみをサポートしています: hadoop-snappy(hadoop上のsnappy stream format) framing-snappy(googleが推奨するsnappy stream format) |
Quote character | 設定なし:ターゲット側でデータを書き込む際に引用符の追加操作は行われず、値はソース側と一致します。 二重引用符("):ターゲット側でデータを書き込む際に、各値に自動的に二重引用符"を追加します。例えば"123"のようになります。 一重引用符('):ターゲット側でデータを書き込む際に、各値に自動的に一重引用符'を追加します。例えば'123'のようになります。 |
ヘッダー行を含むかどうか | いいえ:書き込み時にヘッダーを含みません。 はい:書き込み時にヘッダーを含みます。 |
完了マークファイル | 空白の.okファイルは、タスク転送の完了を示します。 生成しない:タスク完了後、空の.okファイルを生成しません。(デフォルトで選択) 生成:タスク完了後、空の.okファイルを生成します。 |
完了マークファイル名 | 入力時には完全なファイルパス、名前、拡張子を含める必要があります。デフォルトでは、ターゲットパスにターゲットファイル名と拡張子に基づいて.okファイルが生成されます。 データ同期、ファイル転送モードで時間スケジュールパラメータ${yyyyMMdd}などを使用できます。 ファイル転送モードで組み込み変数${filetrans_di_src}を使用してソースファイル名を表すことができます。 例えば:/user/test/${filetrans_di_src}_${yyyyMMdd}.okです。 注意: ファイル転送モードの「ターゲットファイル名」で${filetrans_di_src}を使用してソースファイル名を参照し、かつ完了マークファイルがターゲットファイル名とサフィックスに基づいて.okファイルを生成する場合、生成される完了マークファイルの数はソース側のファイル数によって決まります。 |
フィードバック