Kafka/CKafka データソース
ダウンロード
フォーカスモード
フォントサイズ
サポートバージョン
1. Kafka 2.4.x、2.7.x、2.8.xバージョンをサポートします。
2. Kafka/CKafkaのいずれもKafkaデータソースを選択でき、Kafkaの手順に従って読み書き設定を行います。
利用制限
parameter.groupIdとparameter.kafkaConfig.group.idを同時に設定する場合、parameter.groupIdの優先順位はkafkaConfig設定情報のgroup.idよりも高くなります。
Kafkaオフライン単一テーブル読み取りノードの設定
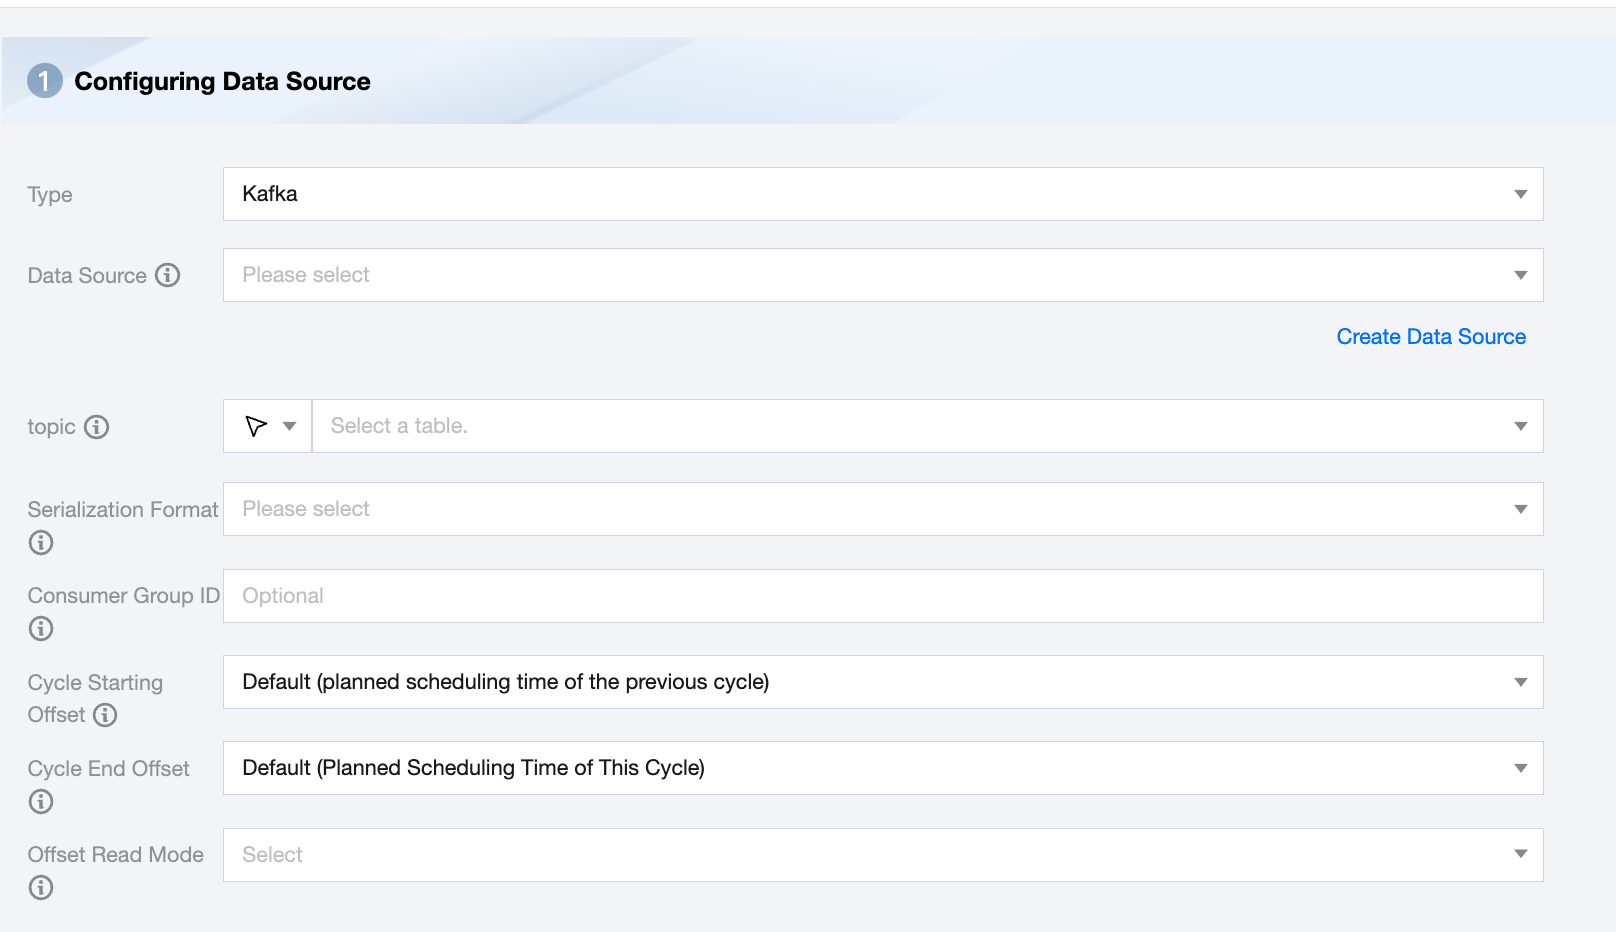
パラメータ | 説明 |
データソース | Kafka読み取り側データソースタイプはKafka、Ckafkaをサポートします。 |
topic | KafkaのTopicは、Kafkaが処理するリソースのメッセージソース(feeds of messages)の集合体です。 |
シリアライズ形式 | 読み取り対象のKafkaデータは、定数列、データ列、属性列をサポートします。 定数列:一重引用符で囲まれた列は定数列です。例えば["'abc'", "'123'"]のようになります。 データ列 お客様のデータがJSONである場合、JSONの属性を取得できます。例えば["event_id"]のようになります。 お客様のデータがJSONである場合、JSONのネストされた子属性を取得できます。例えば["tag.desc"]のようになります。 属性列 __key__はメッセージのkeyを表します。 __value__はメッセージの完全な内容を表します。 __partition__は現在のメッセージが存在するパーティションを表します。 __headers__は現在のメッセージのheaders情報を表します。 __offset__は現在のメッセージのオフセット量を表します。 __timestamp__は現在のメッセージのタイムスタンプを表します。 |
コンシューマーグループid | このパラメータが他のコンシューマープロセスと重複しないようにしてください。これにより、消費オフセットの正確性が保証されます。このパラメータを指定しない場合、デフォルトで group.id=WeData_ group_${タスクid} が設定されます。 |
周期開始位置 | タスク周期実行時、毎回Kafkaの開始位置を読み取ります。デフォルトは前周期の計画スケジュール時間です。選択可能:パーティション開始位置、コンシューマーグループの現在位置、指定位置、指定時間。 指定時刻:データがKafkaに書き込まれる際に、unixtimeタイムスタンプが自動的に生成され、そのデータの時刻記録として使用されます。同期タスクは、ユーザーが設定したyyyymmddhhmmssの数値を取得し、その値をunixtimestampに変換してからKafkaから対応するデータを読み取ります。例えば、「beginDateTime」:「20210125000000」のようになります。 パーティション開始位置:Kafkaトピックの各パーティションで削除されていない最小のオフセットのデータからデータの抽出を開始します。 コンシューマーグループの現在位置:タスク設定で指定されたコンシューマーグループIDに保存された位置からデータの読み取りを開始します。通常、このグループIDを使用してデータを読み取るプロセスが最後に停止した位置です(このグループIDを使用するプロセスが、設定されたこのData Integrationタスクのみであることを確認し、グループIDの共有によるデータ損失を回避することをお勧めします)。グループの現在位置を使用する場合は、必ずコンシューマーグループIDを設定してください。設定しない場合、Data IntegrationタスクはランダムにグループIDを生成します。新しいグループIDには保存された位置がないため、位置リセットポリシーによってはタスクエラーが発生したり、先頭または末尾の位置からデータの読み取りが開始されたりします。また、グループ位置はクライアント側で定期的に自動的にKafkaサーバーへコミットされます。そのため、タスク失敗後にタスクを再実行すると、データが重複または欠落する可能性があります。また、ウィザードモードでは、終了位置を超えて読み取ったレコードは自動的に破棄されます。これらの破棄されたデータのグループ位置はすでにサーバーへコミットされているため、次の周期タスクの実行時にはこれらの破棄されたデータを読み取ることができません。 |
周期終了位置 | タスク周期実行時、毎回Kafkaの終了位置を読み取ります。デフォルトは今周期の計画スケジュール時間です。keyTypeまたはvalueTypeがSTRINGに設定されている場合、この設定項目で指定されたエンコーディングを使用して文字列を解析します。 |
位置読み取りモード | 手動で同期タスクを実行する際にデータ同期を開始する開始位置です。2つの読み取りモードを提供します。 latest:前回のオフセット位置から読み取ります。 earliest:開始位置から読み取ります。 |
Kafkaオフライン単一テーブル書き込みノードの設定
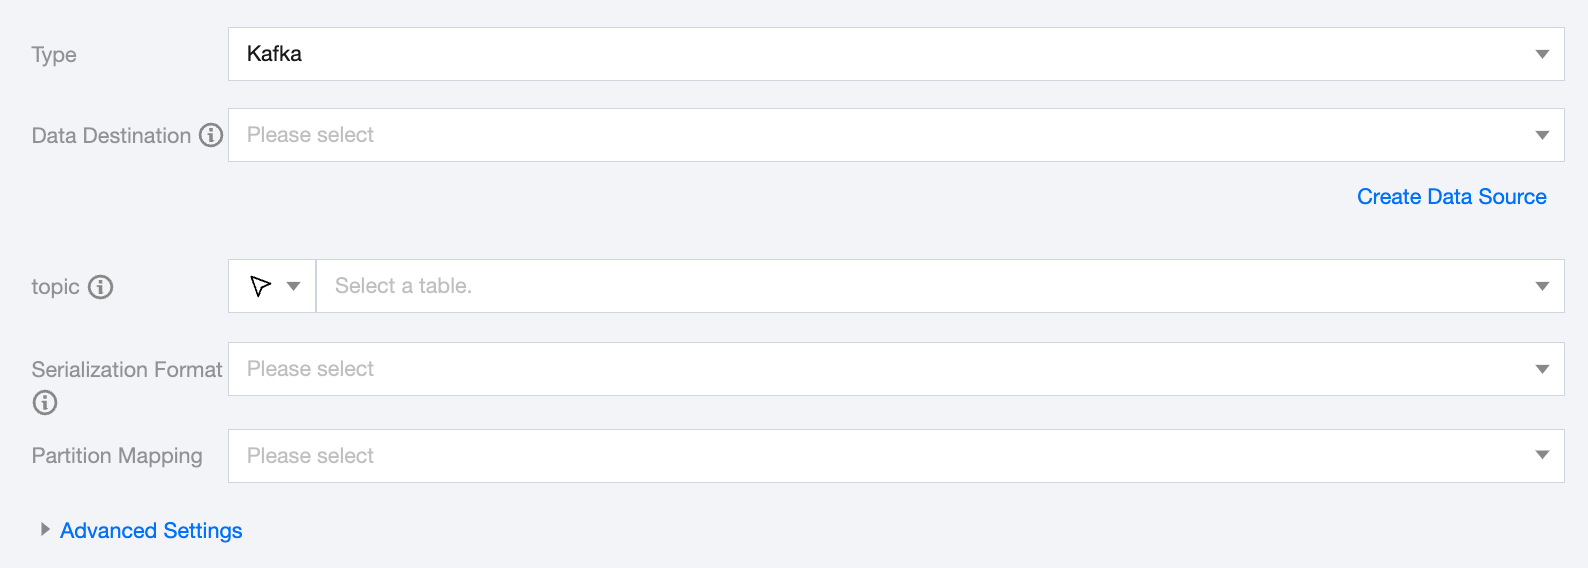
パラメータ | 説明 |
データの転送先 | Kafka読み取り側データソースタイプはKafka、Ckafkaをサポートします。 |
Topic | KafkaのTopicは、Kafkaが処理するリソースのメッセージソース(feeds of messages)の集合体です。 |
シリアライズ形式 | 読み取り対象のKafkaデータは、定数列、データ列、属性列をサポートします。 定数列:一重引用符で囲まれた列は定数列です。例えば["'abc'", "'123'"]のようになります。 データ列: お客様のデータがJSONである場合、JSONの属性を取得できます。例えば["event_id"]のようになります。 お客様のデータがJSONである場合、JSONのネストされた子属性を取得できます。例えば["tag.desc"]のようになります。 属性列: __key__はメッセージのkeyを表します。 __value__はメッセージの完全な内容を表します。 __partition__は現在のメッセージが存在するパーティションを表します。 __headers__は現在のメッセージのheaders情報を表します。 __offset__は現在のメッセージのオフセット量を表します。 __timestamp__は現在のメッセージのタイムスタンプを表します。 |
Partition パーティションマッピング | ラウンドロビンによるパーティション書き込み、指定フィールドのハッシュに基づく書き込み、パーティション指定の3つのモードをサポートします。 指定フィールドに基づくHash書き込みモードを選択する場合、フィールド名を指定する必要があります。 指定パーティションモードを選択する場合、パーティション番号を設定する必要があります。 |
詳細設定(任意) | 業務ニーズに応じてパラメータを設定できます。 |
データ型変換のサポート
読み取り
その他のデータ型はデフォルトでString型に変換されます。
Kafka value の書き込み形式 | ソースフィールドタイプ | 内部型 |
JSON | Integer、Long、BigInteger | Long |
| Float、Double | Double |
| Boolean | Bool |
| JSONArray、JSONObject | String |
CSV | Integer、Long、BigInteger | Long |
| Float、Double | Double |
| Boolean | Bool |
| JSONArray、JSONObject | String |
AVRO | Integer、Long、BigInteger | Long |
| Float、Double | Double |
| Boolean | Bool |
| JSONArray、JSONObject | String |
書き込み
その他のデータ型はデフォルトでString型に変換されます。
Kafka value の書き込み形式 | 内部型 | ターゲット側フィールドタイプ |
JSON | Long | Integer、Bigint |
| Double | Float、Double、Decimal |
| Bool | Boolean |
| String | String、Varchar、Array |
| Date | Date、Timestamp |
CSV | Long | Integer、Bigint |
| Double | Float、Double、Decimal |
| Bool | Boolean |
| String | String、Varchar、Array |
| Date | Date、Timestamp |
AVRO | Long | Integer、Bigint |
| Double | Float、Double、Decimal |
| Bool | Boolean |
| String | String、Varchar、Array |
| Date | Date、Timestamp |
フィードバック