Flinkを使用したMySQLまたはTDSQL-C MySQLサブスクリプションデータの消費
ダウンロード
フォーカスモード
フォントサイズ
操作シナリオ
データ購読Kafka版(現在のKafka ServerバージョンはV2.6.0)では、Avro形式の購読データに対して、Flinkクライアント(クライアントタイプはDataStream APIのみサポート)を使用して消費できます。本シナリオでは、flink-dts-connectorを使用してデータを消費するDemo例を提供します。
前提条件
1. データ消費タスクを作成しました。
2. 消費グループを作成しました。
3. Flinkをインストールし、Flinkタスクを正常に実行できる状態です。
注意事項
Demo にはデータ消費の使用方法のデモは含まれておらず、データの印刷処理のみが行われています。お客様はこれに基づいてデータ処理ロジックを自身で作成する必要があります。他の言語の Kafka クライアントを使用してデータを消費し、解析することもできます。
現在、外部ネットワーク経由でデータ購読のKafkaに接続して消費することはサポートされておらず、Tencent Cloudの内部ネットワークからのアクセスのみがサポートされています。また、購読するデータベースインスタンスが属する地域とデータを消費する地域は同じである必要があります。
DTS購読に組み込まれているKafkaの単一メッセージ処理には一定の上限があります。ソースデータベース内の単一行データが5MBを超えると、購読タスクでエラーが発生する可能性があります。
指定のデータベース/テーブルオブジェクト(ソースインスタンス全体ではない)を購読し、かつKafkaの単一パーティションを使用するシナリオでは、DTSは増分データを解析した後、購読対象のデータのみをKafka Topicに書き込みます。その他の購読対象外のデータは空のトランザクションに変換されてKafka Topicに書き込まれるため、データを消費する際に空のトランザクションが発生します。空のトランザクションのBegin/CommitメッセージにはトランザクションのGTID情報が保持されており、GTIDの連続性と完全性を保証できます。また、複数の空のトランザクションも圧縮処理され、メッセージ数が削減されます。
データの再入可能性を保証するために、DTS購読はチェックポイントメカニズムを導入しています。メッセージがKafka Serverに書き込まれる際、通常10秒ごとにチェックポイントが1つ挿入され、データ同期の位置を識別するために使用されます。タスクが中断された後に再起動すると、中断位置を認識してチェックポイントからの再開を実現します。また、コンシューマー側はチェックポイントメッセージを受信すると、Kafkaの消費位置のコミットを一度実行し、これによりコンシューマー側のデータ再入可能性を実現します。
消費デモのダウンロード
デモ言語 | Avro(MySQL/TDSQL-C MySQL) |
Java |
Java Flinkデモの操作手順
コンパイル環境:MavenまたはGradleパッケージ管理ツール、JDK8。ユーザーはパッケージツールを自由に選択できます。以下ではMavenを例に説明します。
実行環境:Tencent Cloud CVM(購読インスタンスと同じ地域である必要があり、Kafkaサーバーの内部ネットワークアドレスにアクセスできます)、JRE8をインストールします。
操作手順:
1. Java Flink Demoをダウンロードしてから、そのファイルを解凍してください。
2. resourcesディレクトリに入り、以下のコマンドを実行してください:
java -jar avro-tools-1.8.2.jar compile -string schema Record.avsc [コード生成パス]説明:
demoのディレクトリにコードが既に生成されている場合は、この手順をスキップできます。
3. pom.xmlファイルでFlinkのバージョンを変更します。以下のコード内のversionは、お客様が使用するFlinkのバージョンと一致させる必要があります。
<dependency><groupId>org.apache.flink</groupId><artifactId>flink-connector-kafka_${scala.binary.version}</artifactId><version>1.13.6</version></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-streaming-java_${scala.binary.version}</artifactId><version>1.13.6</version><scope>provided</scope></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-avro</artifactId><version>1.13.6</version></dependency>
4. pomファイルがあるディレクトリに入り、Mavenを使用してパッケージ化するか、IDEAを使用して直接パッケージ化してください。
5. Mavenを使用してパッケージ化します:mvn clean package。
6. FlinkクライアントタイプがDataStream APIのシナリオでは、Flinkクライアントコマンドを使用してタスクを送信し、消費を開始します。
./bin/flink run consumerDemo-avro-flink-1.0-SNAPSHOT.jar --brokers xxx --topic xxx --group xxx --user xxx --password xxx —trans2sqlbrokersはデータ購読Kafkaの内部ネットワークアクセスアドレス、topicはデータ購読タスクの購読topicです。これらは購読詳細ページで確認できます。group、user、passwordはそれぞれ消費グループの名前、アカウント、パスワードです。消費管理ページで確認できます。trans2sqlはSQL文に変換するかどうかを示します。Javaコードでは、このパラメータを含む場合はSQL文に変換することを示し、含まない場合は変換しません。7. 消費状況を観察します。
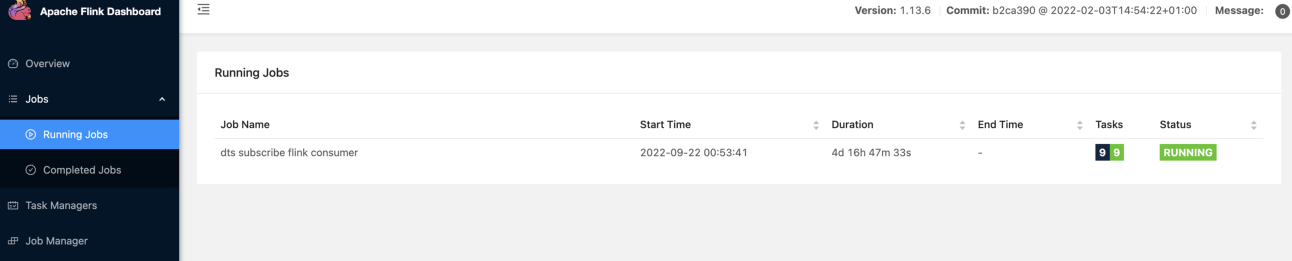
実行中のタスクを確認します。
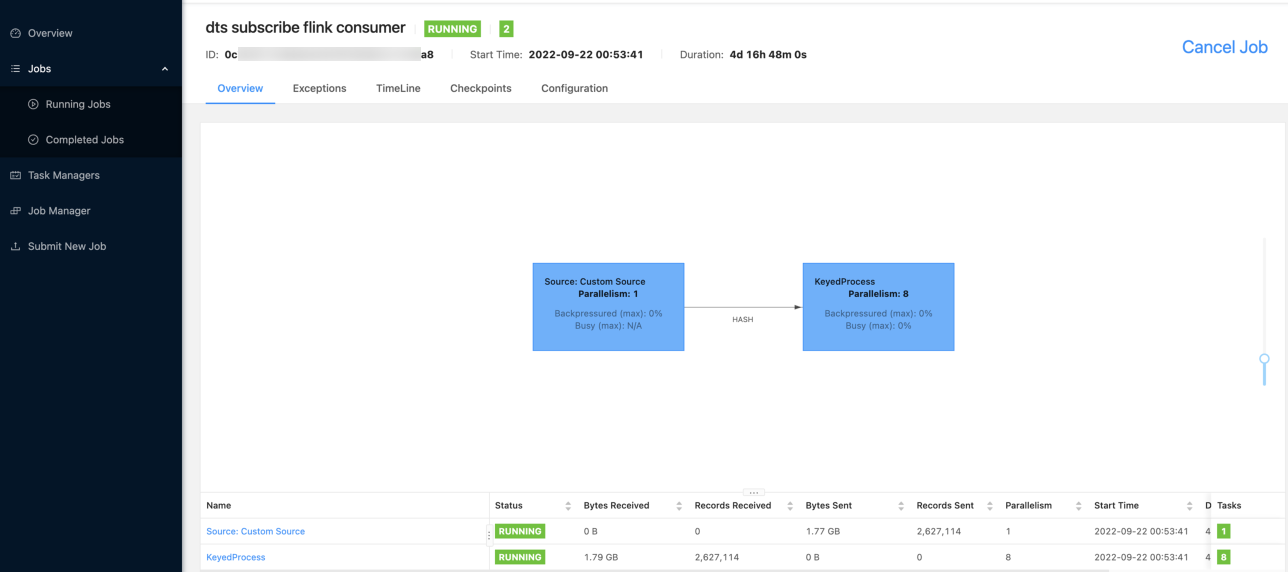
タスクの詳細を確認します。
フィードバック