TDSQL MySQLデータ購読の作成
ダウンロード
フォーカスモード
フォントサイズ
本シナリオでは、DTSを使用してTencent CloudデータベースTDSQL MySQLのデータ購読タスクを作成する操作手順を紹介します。
前提条件
購読対象のTencent Cloudデータベースを準備し、データベースのバージョンが要件を満たしていることを確認してください。詳細はデータ購読がサポートするデータベースを参照してください。
ソースインスタンスでbinlogを有効にしました。
ソースインスタンスに購読アカウントを作成しました。必要なアカウント権限は以下の通りです:REPLICATION CLIENT、REPLICATION SLAVE、PROCESS、およびすべてのオブジェクトに対するSELECT権限。
具体的な権限付与ステートメントは以下の通りです:
create user '移行アカウント' IDENTIFIED BY 'アカウントパスワード';grant SELECT, REPLICATION CLIENT,REPLICATION SLAVE,PROCESS on *.* to '移行アカウント'@'%';flush privileges;
制約事項
1. 購読したメッセージはDTS内蔵Kafka(単一Topic)に保存されます。現在のデフォルト保存期間は直近1日で、単一Topicの最大ストレージは500Gです。データの保存期間が1日を超えた場合、またはデータ量が500Gを超えた場合、内蔵Kafkaは最初に書き込まれたデータから削除を開始します。そのため、ユーザーはデータが消費される前に削除されないよう、タイムリーに消費してください。
2. データ消費の地域は、購読タスクが属する地域と同じである必要があります。
3. 現在、geometry関連のデータ型はサポートされていません。
4. データ購読ソースがTDSQL for MySQLの場合、権限付与ステートメントを直接実行して権限を付与することはサポートされていません。そのため、購読アカウントの権限は、TDSQLコンソールでインスタンスIDをクリックし、アカウント管理ページで追加する必要があります。
5. 購読アカウントに必要な権限は、上記の権限付与ステートメントに示された権限です。購読アカウントに対して
__tencentdb__の権限を付与する操作では、コンソールの権限変更ポップアップでオブジェクトレベルの特権を選択し、すべての権限にチェックを入れてください。6. データ購読ソースがTDSQL for MySQLの場合、セカンダリパーティションテーブルの購読はサポートされていません。
6.1 購読タスクの開始前にソースデータベースでセカンダリパーティションテーブルが作成された場合、検証タスクは不合格となります。
6.2 購読タスクの実行中にソースデータベースでセカンダリパーティションテーブルが作成された場合、購読されるセカンダリパーティションテーブルのデータは子テーブルのデータです(購読対象としてデータベース全体またはインスタンス全体を選択している場合、ソースデータベースで購読タスクの開始後に作成されたセカンダリパーティションテーブルも購読されるため、最終的にセカンダリパーティションテーブルが購読される結果となります)。セカンダリパーティションテーブルは子テーブルによって実装されているため、購読タスクの実行中にセカンダリパーティションテーブルを作成することはお勧めしません。作成した場合、以下の例のような購読データの差異が生じます。
例:ソースデータベースのテーブル名「test_a」がセカンダリパーティションテーブルである場合、DTSが購読するこのテーブルのDMLのテーブル名は「test_a_tdsql_subp0/test_a_tdsql_subp1」です。
7. 購読タスク中に購読対象の変更などの操作を行うと、タスクが再起動されます。再起動後、ユーザーがKafkaクライアントでデータを消費する際に重複が発生する可能性があります。
7.1 DTSは最小データ単位で伝送を行います。増分データは、checkpoint位置を1つマークするごとに1つのデータ単位となります。再起動時に、ちょうど1つのデータ単位の伝送が完了している場合は、データの重複は発生しません。再起動時に、1つのデータ単位がまだ伝送中である場合は、再度起動した後にこのデータ単位を再取得してデータの整合性を確保するため、データの重複が発生します。
7.2 ユーザーは、重複データが気になる場合、データを消費する際に重複排除ロジックを設定してください。
8. ソース側のTDSQL MySQLではテーブル数に制限があり、インスタンス全体で最大5000個です。これを超えるとDTSタスクがエラーを報告します。また、テーブル数が多すぎると、ソース側のアクセス時間が長くなり、パフォーマンスのジッターや低下を引き起こします。
注意事項
データ購読ソースがTDSQL for MySQLの購読タスクである場合、各シャードのDDL操作はすべて購読され、Kafkaに配信されます。そのため、1つのシャーディングテーブルに対するDDL操作では、重複したDDLステートメントが発生します。例えば、インスタンスAに3つのシャードがあり、1つのシャーディングテーブルtableAを購読している場合、テーブルtableAに対するDDLステートメントは3件購読されます。
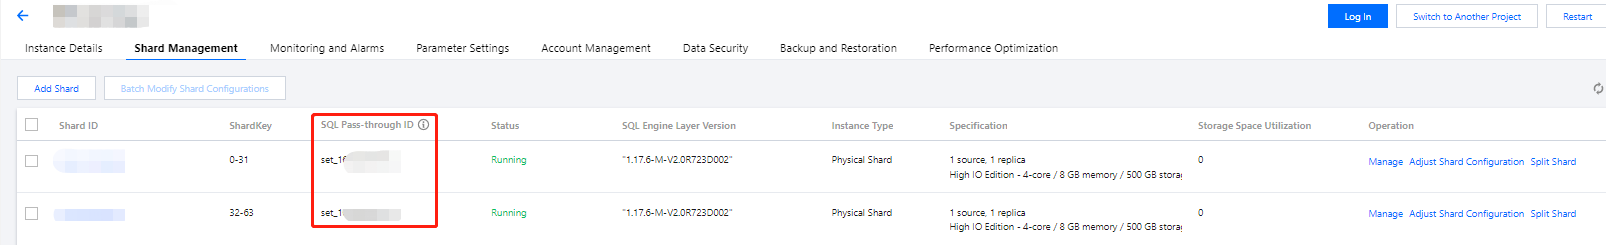
Kafka内の各メッセージのメッセージヘッダーにはシャード情報が含まれており、key/valueの形式でメッセージヘッダーに存在します。keyはShardId、valueはSQLパススルーIDです。SQLパススルーIDに基づいて、そのメッセージがどのシャードからのものかを区別できます。ユーザーはTDSQLコンソール > インスタンスリスト > シャード管理でSQLパススルーIDを確認できます。
サポートされる購読のSQL操作
操作タイプ | サポートされる SQL 操作 |
DML | INSERT、UPDATE、DELETE |
DDL | CREATE DATABASE、DROP DATABASE、CREATE TABLE、ALTER TABLE、DROP TABLE、RENAME TABLE |
操作手順
1. DTSコンソールにログインし、左側のナビゲーションでデータ購読を選択し、データ購読を新規作成をクリックします。
2. データ購読の新規作成ページで、対応する設定を選択し、今すぐ購入をクリックします。
パラメータ | 説明 |
課金モデル | サポートされているのは、年額・月額プランと従量課金です。 |
データベース | 具体的なデータベースタイプに応じて選択してください。 |
リージョン | ソースデータベースがTencent Cloudデータベースの場合、ここでの地域はソースデータベースインスタンスの地域と一致させる必要があります。ソースデータベースがTencent Cloudデータベース以外の場合、ここでの地域選択はデータ消費の地域と一致させます。データ消費地域に特別な要件がない場合は、ソースデータベースに最も近い地域を選択してください。 |
バージョン | 2.0を選択してください。 |
仕様 | ビジネス要件に応じてスペックを選択してください。 |
タグ | 購読タスクにタグキーとタグ値を設定し、タグによって複数のタスクを効率的に管理できるようにします。 |
サブスクリプションインスタンス名 | 作成後に名前を付けることを選択した場合、デフォルトのタスク名はタスクIDと一致します。購読タスクの作成が完了した後、タスク名を再設定できます。 「今すぐ名前を付ける」を選択し、下の入力ボックスにタスク名を入力してください。 |
契約条件 |
3. 購入が成功したら、データ購読リストに戻り、操作列の購読を設定をクリックして、購入したばかりの購読を設定します。設定が完了してから使用できます。
4. データ購読の設定ページで、データ購読タスクを選択し、完了後に接続テストをクリックします。テストが成功し、ネットワークを設定した後、保存して次へをクリックします。
データ購読タスクの設定
設定項目 | 説明 |
インスタンスタイプ | 購入時に選択したデータベースタイプは変更できません。 |
アクセスタイプ | 現在はソースデータベースがTencent Cloudデータベースインスタンスであるシナリオのみをサポートしています。「クラウドデータベース」を選択してください。 |
クラウドデータベースインスタンス | クラウドデータベースインスタンス:ソースデータベースのインスタンスID。 読み取り専用/災害復旧インスタンスを選択できますが、メインインスタンスを選択することをお勧めします。サブスクリプションサービスがソースデータベースに与える負荷は非常に小さいです。 |
アカウント/パスワード | アカウント/パスワード:ソースデータベースのアカウント、パスワード。 |
ネットワーク設定
設定項目 | 説明 |
ネットワーク | 購読タスクKafkaにアクセスするVPC環境(VPCとサブネットを含む)を事前に指定してください。その後、このVPCを介してデータ購読サービスを消費できます。 説明: 同一VPCからのアクセス:同じVPC内のすべてのCVMは、追加設定なしでサブスクリプションデータに正常にアクセスできます。 VPC間アクセス:コンシューマー側CVMが別のVPCにある場合、CCNを設定してVPC間アクセスを実現する必要があります。 |
5. 購読タイプとオブジェクト選択ページで、購読タイプを選択し、保存して次へをクリックします。
設定項目 | 説明 |
サブスクリプションタイプ | データ更新:ソースデータベースの全オブジェクトのデータ更新を購読します。これにはデータのINSERT、UPDATE、DELETE操作が含まれます。 構造更新:ソースデータベースの全オブジェクトの構造の作成、変更、削除を購読します。 全インスタンス:ソースデータベースの全オブジェクトのデータ更新と構造更新を購読します。 |
Kafkaバージョン | DTS内蔵Kafkaのバージョンを表示します。変更はできません。 |
Topicパーティション数 | データを内蔵KafkaのTopicに配信するパーティション数を設定します。パーティション数を増やすと、データの書き込みおよび消費速度を向上できます。単一パーティションではメッセージの順序を保証できますが、複数パーティションではメッセージの順序を保証できません。消費するメッセージの順序に厳密な要件がある場合は、パーティション数を1に選択してください。 |
Topicパーティションポリシー | テーブル名によるパーティショニング:同じテーブル名のデータを同じパーティションに書き込みます。 テーブル名+PKによるパーティショニング:同じPKのデータは同じパーティションに書き込まれます。ホットデータのテーブルに適しており、ホットテーブルのデータを異なるパーティションに分散して、並行消費効率を向上させることができます。 |
6. 事前検証ページでは、事前検証タスクの実行には2~3分かかると予想されます。事前検証が完了した後、開始をクリックしてデータ購読タスクの設定を完了します。
説明:
7. 開始をクリックすると、購読タスクは初期化され、3~4分かかると予想されます。初期化が成功すると、実行中状態になります。
8. 消費グループの追加。データ購読Kafka版は、ユーザーが複数のコンシューマグループを作成することをサポートします(1つの購読タスクで最大10個のコンシューマグループを作成できます)。これによりマルチポイント消費が可能になります。データ購読Kafka版の消費はKafkaのコンシューマグループに依存するため、データを消費する前にコンシューマグループを作成する必要があります。
9. 購読インスタンスが実行中状態になると、データの消費を開始できます。Kafkaの消費にはパスワード認証が必要です。具体的な例についてはデータ消費Demoを参照してください。複数言語のDemoコードを提供しており、消費の主な流れと主要なデータ構造についても説明しています。
フィードバック