データ一貫性検証の作成
ダウンロード
フォーカスモード
フォントサイズ
操作シナリオ
データ一貫性の検証とは、DTSがデータ移行のソースデータベースとターゲットデータベースのテーブルデータを比較し、比較結果と不一致の詳細を提供することで、ユーザーが切り替え前に同期結果を迅速に検証できるようにするものです。データ一貫性の検証タスクは独立して実行され、ソースデータベースの通常の業務に影響を与えず、DTSのタスクにも影響を与えません。
説明:
一貫性の検証は補助的なデータ検証手段にすぎません。正式な切り替え前に、結果が切り替え要件を満たしていることを確認するために、ユーザー自身でリハーサル操作を行ってください。
現在データ一貫性の検証をサポートしているリンクは以下の通りです:
PostgreSQL > PostgreSQL
注意事項と制約事項
1. データ一貫性の検証タスクはソースデータベースインスタンスの負荷を増加させる可能性があるため、業務への影響が少ない時間帯に操作を行ってください。
2. 現在、移行タイプが全量移行+増分移行の場合のみ、データ一貫性の検証をサポートしています。
3. サンプリング比較で検証が必要なテーブルには主キーまたは一意キーが必要です。そうでない場合、検証はスキップされます。行数検証では主キーまたは一意キーは必須ではありません。テーブルに主キーまたは一意キーがなく、データが1万件を超える場合、完全比較は実行できません。
4. データ一貫性の検証タスクがまだ終了していないときに、ユーザーがDTSタスクの完了または終了を選択すると、データ一貫性の検証タスクは失敗します。
データ一貫性の検証タスクの作成
説明:
データ検証タスクを単独で作成する場合、独立検証のみをサポートし、組み込み検証はサポートしません。
独立検証はDTSタスクから独立しており、ソース側とターゲット側の同じデータブロックを選択して比較します。DTSタスクの実行が停止した後は、検証の開始はサポートされません。
タスクの実行中かつ増分同期の段階にある場合のみ、独立検証タスクを開始できます。タスクが完了している場合、検証タスクを開始することはできません。ユーザーは、切り替えの異なる段階に基づいて、複数回に分けて異なる検証方法で検証タスクを開始できます。
1. DTSコンソールにログインし、左側のナビゲーションでデータ移行ページを選択し、タスクリストの操作列で表示をクリックするか、タスクIDを直接クリックしてタスク詳細を表示します。
2. データ一貫性の検証をクリックし、データ一貫性の検証のタスクリストに入り、データ一貫性の検証を作成をクリックして、データ検証タスクを新規作成します。

検証タスクの詳細を設定します。具体的には以下の通りです:

パラメータ | 説明 |
検証方式 | 独立検証:検証サービスはDTSタスクから独立しており、移行対象外の他のデータを比較できます。 |
検証内容 | ソース側とターゲット側のデータオブジェクト構造を検証します。構造が一致していることを確認済みの場合は、構造検証を無効にすると時間を節約できます。 |
検証基準 | デフォルトではソース側を検証基準とします。 |
検証タイプ | 完全検証:選択した検証オブジェクトの完全なデータを検証します。 行数検証:選択した検証オブジェクトに対して、データ行数のみを比較します。行数比較を選択した場合、テーブルオブジェクトにPKは必須ではなく、PKなしのテーブルでも検証を実行できます。 サンプリング検証:選択した検証オブジェクトから一定の割合を抽出して検証します。サンプリング割合は10%、20%、30%……90%をサポートします。 |
検証対象 | すべての移行オブジェクト:検証範囲は移行タスクで選択されたすべてのオブジェクトです。 カスタム選択:選択した移行オブジェクトの中から、検証を行うオブジェクトを選択します。 |
スレッド数選択 | 設定範囲は1~8です。実際の状況に応じて選択してください。スレッド数を増やすと一貫性の検証速度を向上させることができますが、ソースとターゲットデータベースの負荷も増加します。スレッド数を1つ増やすごとに、約1つのCPUの使用量が増加します。 |
3. 設定が完了したら、一貫性の検証を作成して開始をクリックすると、検証タスクが開始されます。
データ一貫性検証結果の確認
説明:
検証タスクで最初に不一致のテーブルが検出された場合、システムはタスク比較の結論を不一致としてマークし、タスク状態を失敗としてマークします。
1. 移行タスクのホームページにある最後の検証結果列で、検証結果(一致または不一致)を確認できます。詳細を見るをクリックすると、検証詳細ページに移動します。


2. 表示をクリックすると、検証結果を確認できます。
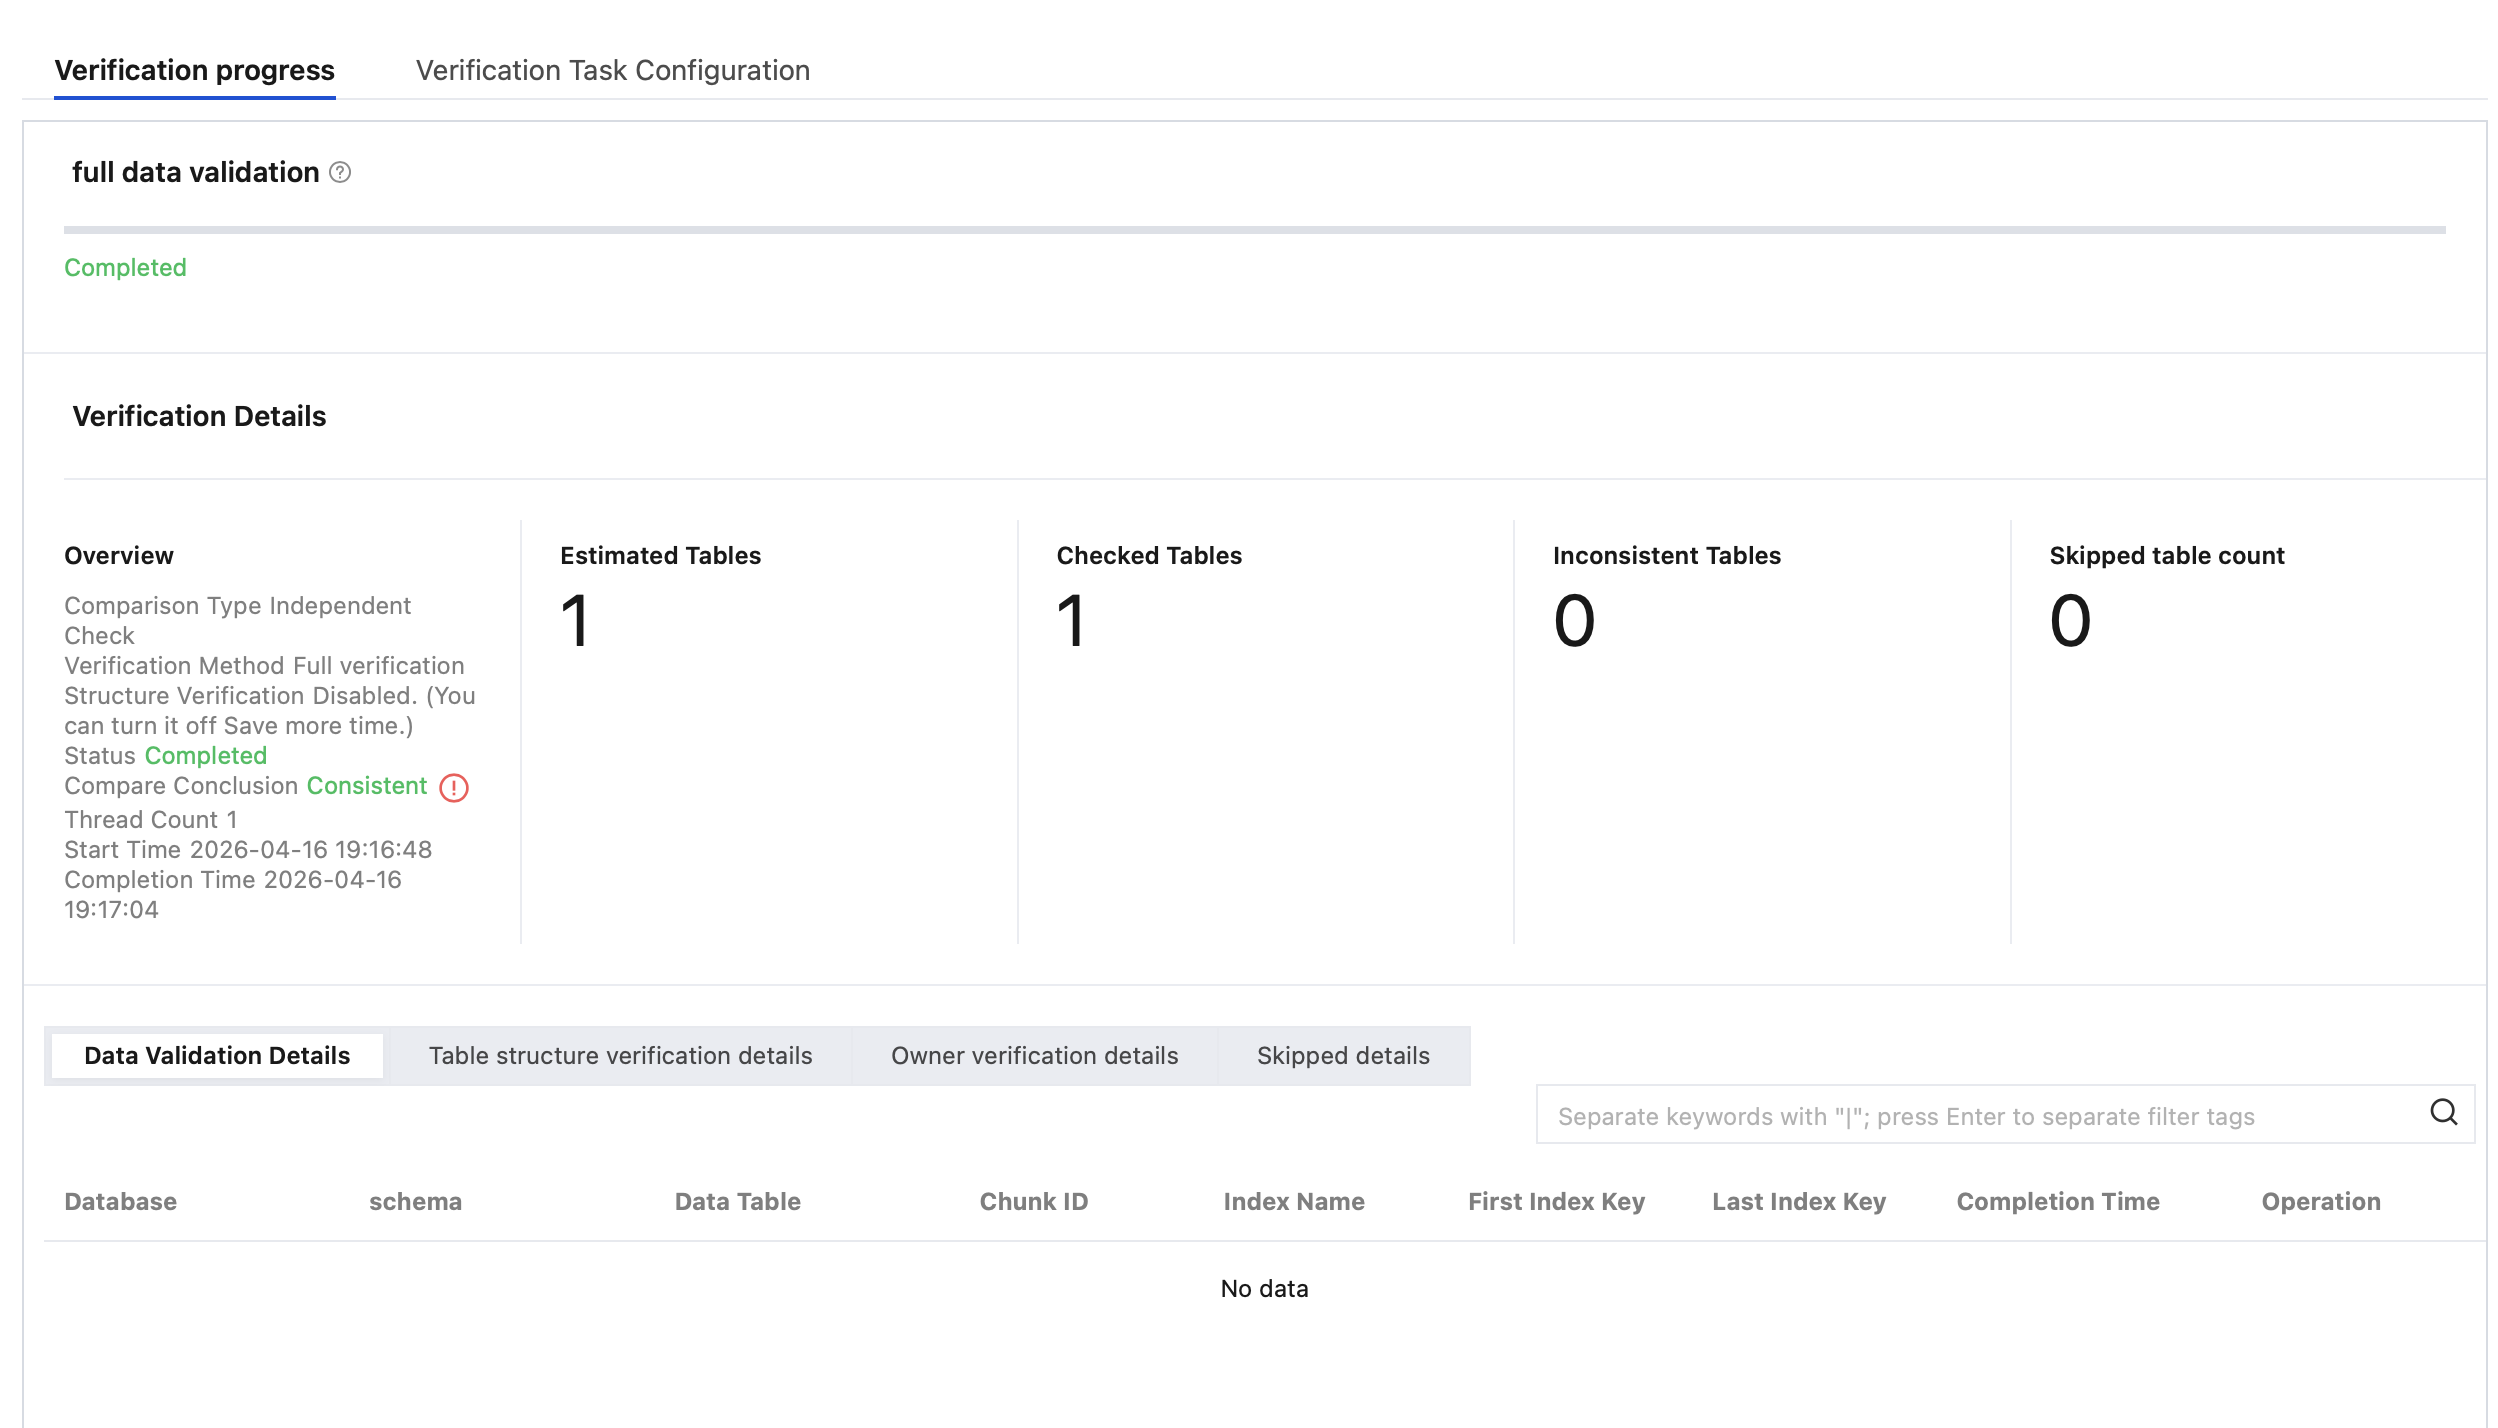
データ検証結果のまとめ
データ検証結果の集計情報は以下の表に示します:
項目 | 詳細 |
概要 | 比較タイプ:現在はすべて独立検証です。 比較方式:選択可能な方式は、完全比較、サンプリング比較、行数検証です。 構造検証:選択可能な方式はオンまたはオフです。 状態:現在の検証タスクの状態で、作成完了、実行待ち、実行中、または完了済みです。 比較結論:現在の検証タスクの実行結果で、不一致または一致です。 スレッド数:現在のタスクに設定されているスレッド数です。 |
推定テーブル総数 | システムが検証する必要があると予測されるすべてのテーブルの総数です。 |
検出済みテーブル数 | タスクが現在検出を完了したテーブルの数です。 |
不一致テーブル数 | 検出が完了したテーブルのうち、ソースとターゲット側で不一致が生じているテーブルの数です。具体的な不一致テーブルは、不一致の詳細で確認できます。 |
スキップ済みテーブル数 | 今回の検証でスキップされたテーブルの数です。 |
データ検証結果の詳細
PostgreSQLのデータ検証タスクでは、検証タスク内に以下のような不一致が表示されます。以下でそれぞれ説明します:
データ検証の詳細
このセクションでは、現在検証が完了したデータのうち、不一致の詳細が表示されます。詳細リストの操作列にある表示をクリックすると、特定のデータを特定できます。具体的には以下の図の通りです:


テーブル構造検証の詳細
構造検証をオンにしたタスクのみ、構造検証の詳細が表示されます。構造検証の実行中、システムは検証済みのすべての不一致テーブル構造の詳細を一覧表示します。
リスト内の構造フィールドの詳細をクリックすると、構造が一致しない詳細なSQLを確認できます。具体的には以下の図の通りです:
Owner検証の詳細
データ検証タスクは、検証済みのすべてのテーブルにおけるOWNER不一致の詳細を一覧表示します。
スキップ済みの詳細
データ検証タスクは、検証をスキップしたすべてのテーブルの詳細を一覧表示します。
実装原理
行数比較:ソーステーブルとターゲットテーブルの行数が一致しているかを検証します。
サンプリング比較:
PKまたは一意のインデックスがないテーブルはサンプリング比較を実行できず、システムは直接スキップします。
その他のテーブルでは、まずソースとターゲットの行数が一致しているかが比較されます。一致していない場合は不一致と判定され、システムはこれらのテーブルをスキップして他のテーブルの検証を行います。
テーブルの行数が一致している場合、システムはサンプリング比率に基づいて、1つのテーブルを複数のブロックに分割します。各ブロック内でランダムにいくつかの行データを選択し、ソースとターゲットのMD5値をそれぞれ計算して比較します。MD5が同じであれば一致していることを示します。
完全比較:
PKまたは一意のインデックスがないテーブルの場合:
テーブルが1万行を超える場合、システムはデータ一貫性の検証を行いません。
1万行を超えていない場合、システムはすべての列をソートしてからテーブル内のすべてのデータを取得し、ソースとターゲットのMD5をそれぞれ計算します。MD5が同じであれば一致していることを示します。
フィードバック