MongoDB購読タスクの作成
ダウンロード
フォーカスモード
フォントサイズ
本シナリオでは、DTSを使用してTencentDB for MongoDBのデータ購読タスクを作成する操作手順について説明します。
バージョン説明
現在、TencentDB for MongoDBのデータ購読のみをサポートしています。具体的なバージョンは3.6、4.0、4.2、4.4です。
MongoDB 3.6バージョンはコレクションレベルの購読のみをサポートします。
前提条件
購読対象のTencentDB for MongoDBデータベースを準備し、データベースのバージョンが要件を満たしていることを確認してください。詳細はデータ購読がサポートするデータベースを参照してください。
ソースインスタンスに読み取り専用アカウントを作成することをお勧めします。以下の構文を参照して操作できます。ソースデータベースがTencentDB for MongoDBの場合、MongoDBコンソールで読み取り専用アカウントを作成することもできます。
# 全インスタンス読み取り専用アカウントの作成use admindb.createUser({user: "username",pwd: "password",roles:[{role: "readAnyDatabase",db: "admin"}]})# 指定データベースの読み取り専用アカウントの作成use admindb.createUser({user: "username",pwd: "password",roles:[{role: "read",db: "指定データベースのデータベース名"}]})
注意事項
購読したメッセージはDTS内蔵Kafka(単一Topic)に保存されます。現在のデフォルト保存期間は直近1日で、単一Topicの最大ストレージは500Gです。データの保存期間が1日を超えるか、データ量が500Gを超えると、内蔵Kafkaは最初に書き込まれたデータから削除を開始します。そのため、データが消費される前に削除されないよう、ユーザーは速やかに消費してください。
データ消費の地域は、購読タスクが属する地域と同じである必要があります。
DTSに内蔵されているKafkaには、単一メッセージの処理に一定の上限があります。ソースデータベース内の単一行データが10MBを超えると、このデータはコンシューマー側で破棄される可能性があります。
ソースデータベースで選択済み購読対象の指定データベースまたはコレクションを削除すると、そのデータベースまたはコレクションの購読データ(Change Stream)は無効になります。ソースデータベースでそのデータベースまたはコレクションを再作成しても、データの購読を再開することはできません。購読タスクをリセットし、購読対象を再度選択する必要があります。
購読可能なSQL操作
操作タイプ | サポートされる SQL 操作 |
DML | INSERT、UPDATE、DELETE |
DDL | INDEX:createIndexes、createIndex、dropIndex、dropIndexes
COLLECTION:createCollection、drop、collMod、renameCollection
DATABASE:dropDatabase、copyDatabase |
購読設定手順
1. DTSコンソールにログインし、左側のナビゲーションでデータ購読を選択し、データ購読を新規作成をクリックします。
2. 新しいデータ購読ページで、対応する設定を選択し、今すぐ購入をクリックします。
課金モード:月額・年額プランと従量課金をサポートします。
地域:地域は、購読対象のデータベースインスタンスの地域と一致している必要があります。
データベース:MongoDBを選択します。
バージョン:kafka版を選択します。Kafkaクライアントから直接消費できます。
購読インスタンス名:現在のデータ購読インスタンスの名前を編集します。
購入数量:1回の購入で最大10個のタスクをサポートします。
3. 購入が完了したら、データ購読リストに戻り、先ほど購入したタスクを選択し、操作列で購読を設定をクリックします。
4. データベース購読の設定ページで、ソースデータベース情報を設定した後、接続性テストをクリックし、成功したら次へをクリックします。
アクセスタイプ:現在はクラウドデータベースのみをサポートしています。
クラウドデータベースインスタンス:クラウドデータベースインスタンスIDを選択します。
データベースアカウント/パスワード:購読インスタンスのアカウントとパスワードを追加します。アカウントには読み取り専用権限があります。
kafkaパーティション数:kafkaパーティション数を設定します。パーティション数を増やすと、データの書き込みと消費の速度を向上できます。シングルパーティションはメッセージの順序を保証できますが、マルチパーティションではメッセージの順序を保証できません。消費したメッセージの順序に厳密な要件がある場合は、kafkaパーティション数を1に選択してください。
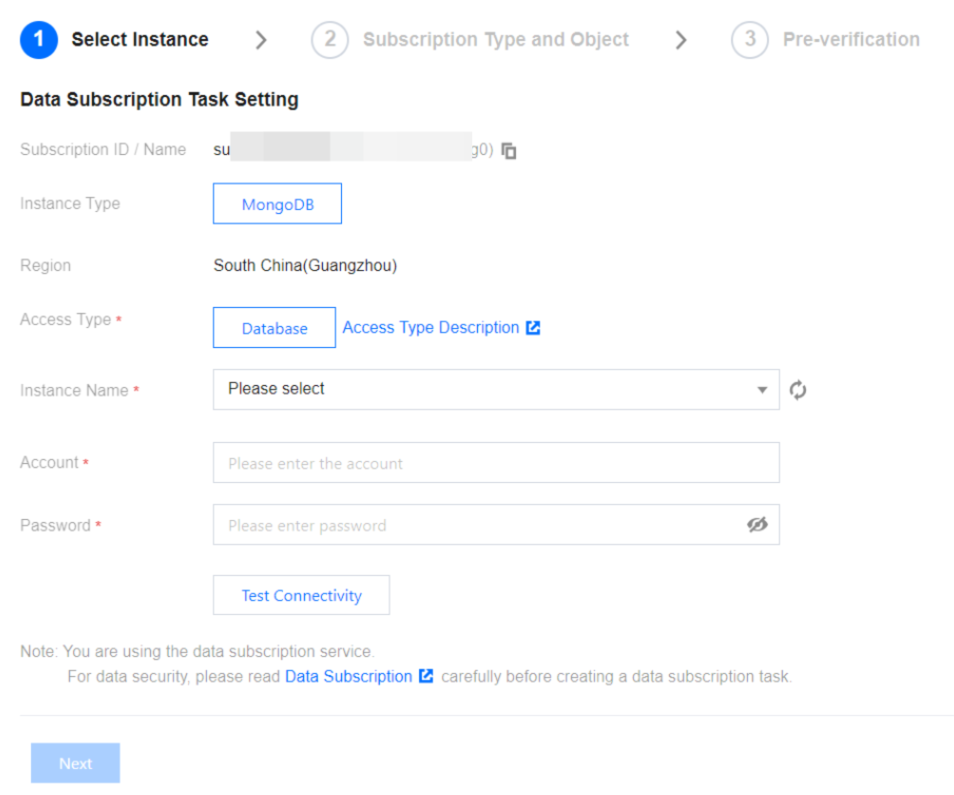
5. 購読タイプとオブジェクト選択ページで、購読パラメータを選択した後、設定を保存をクリックします。
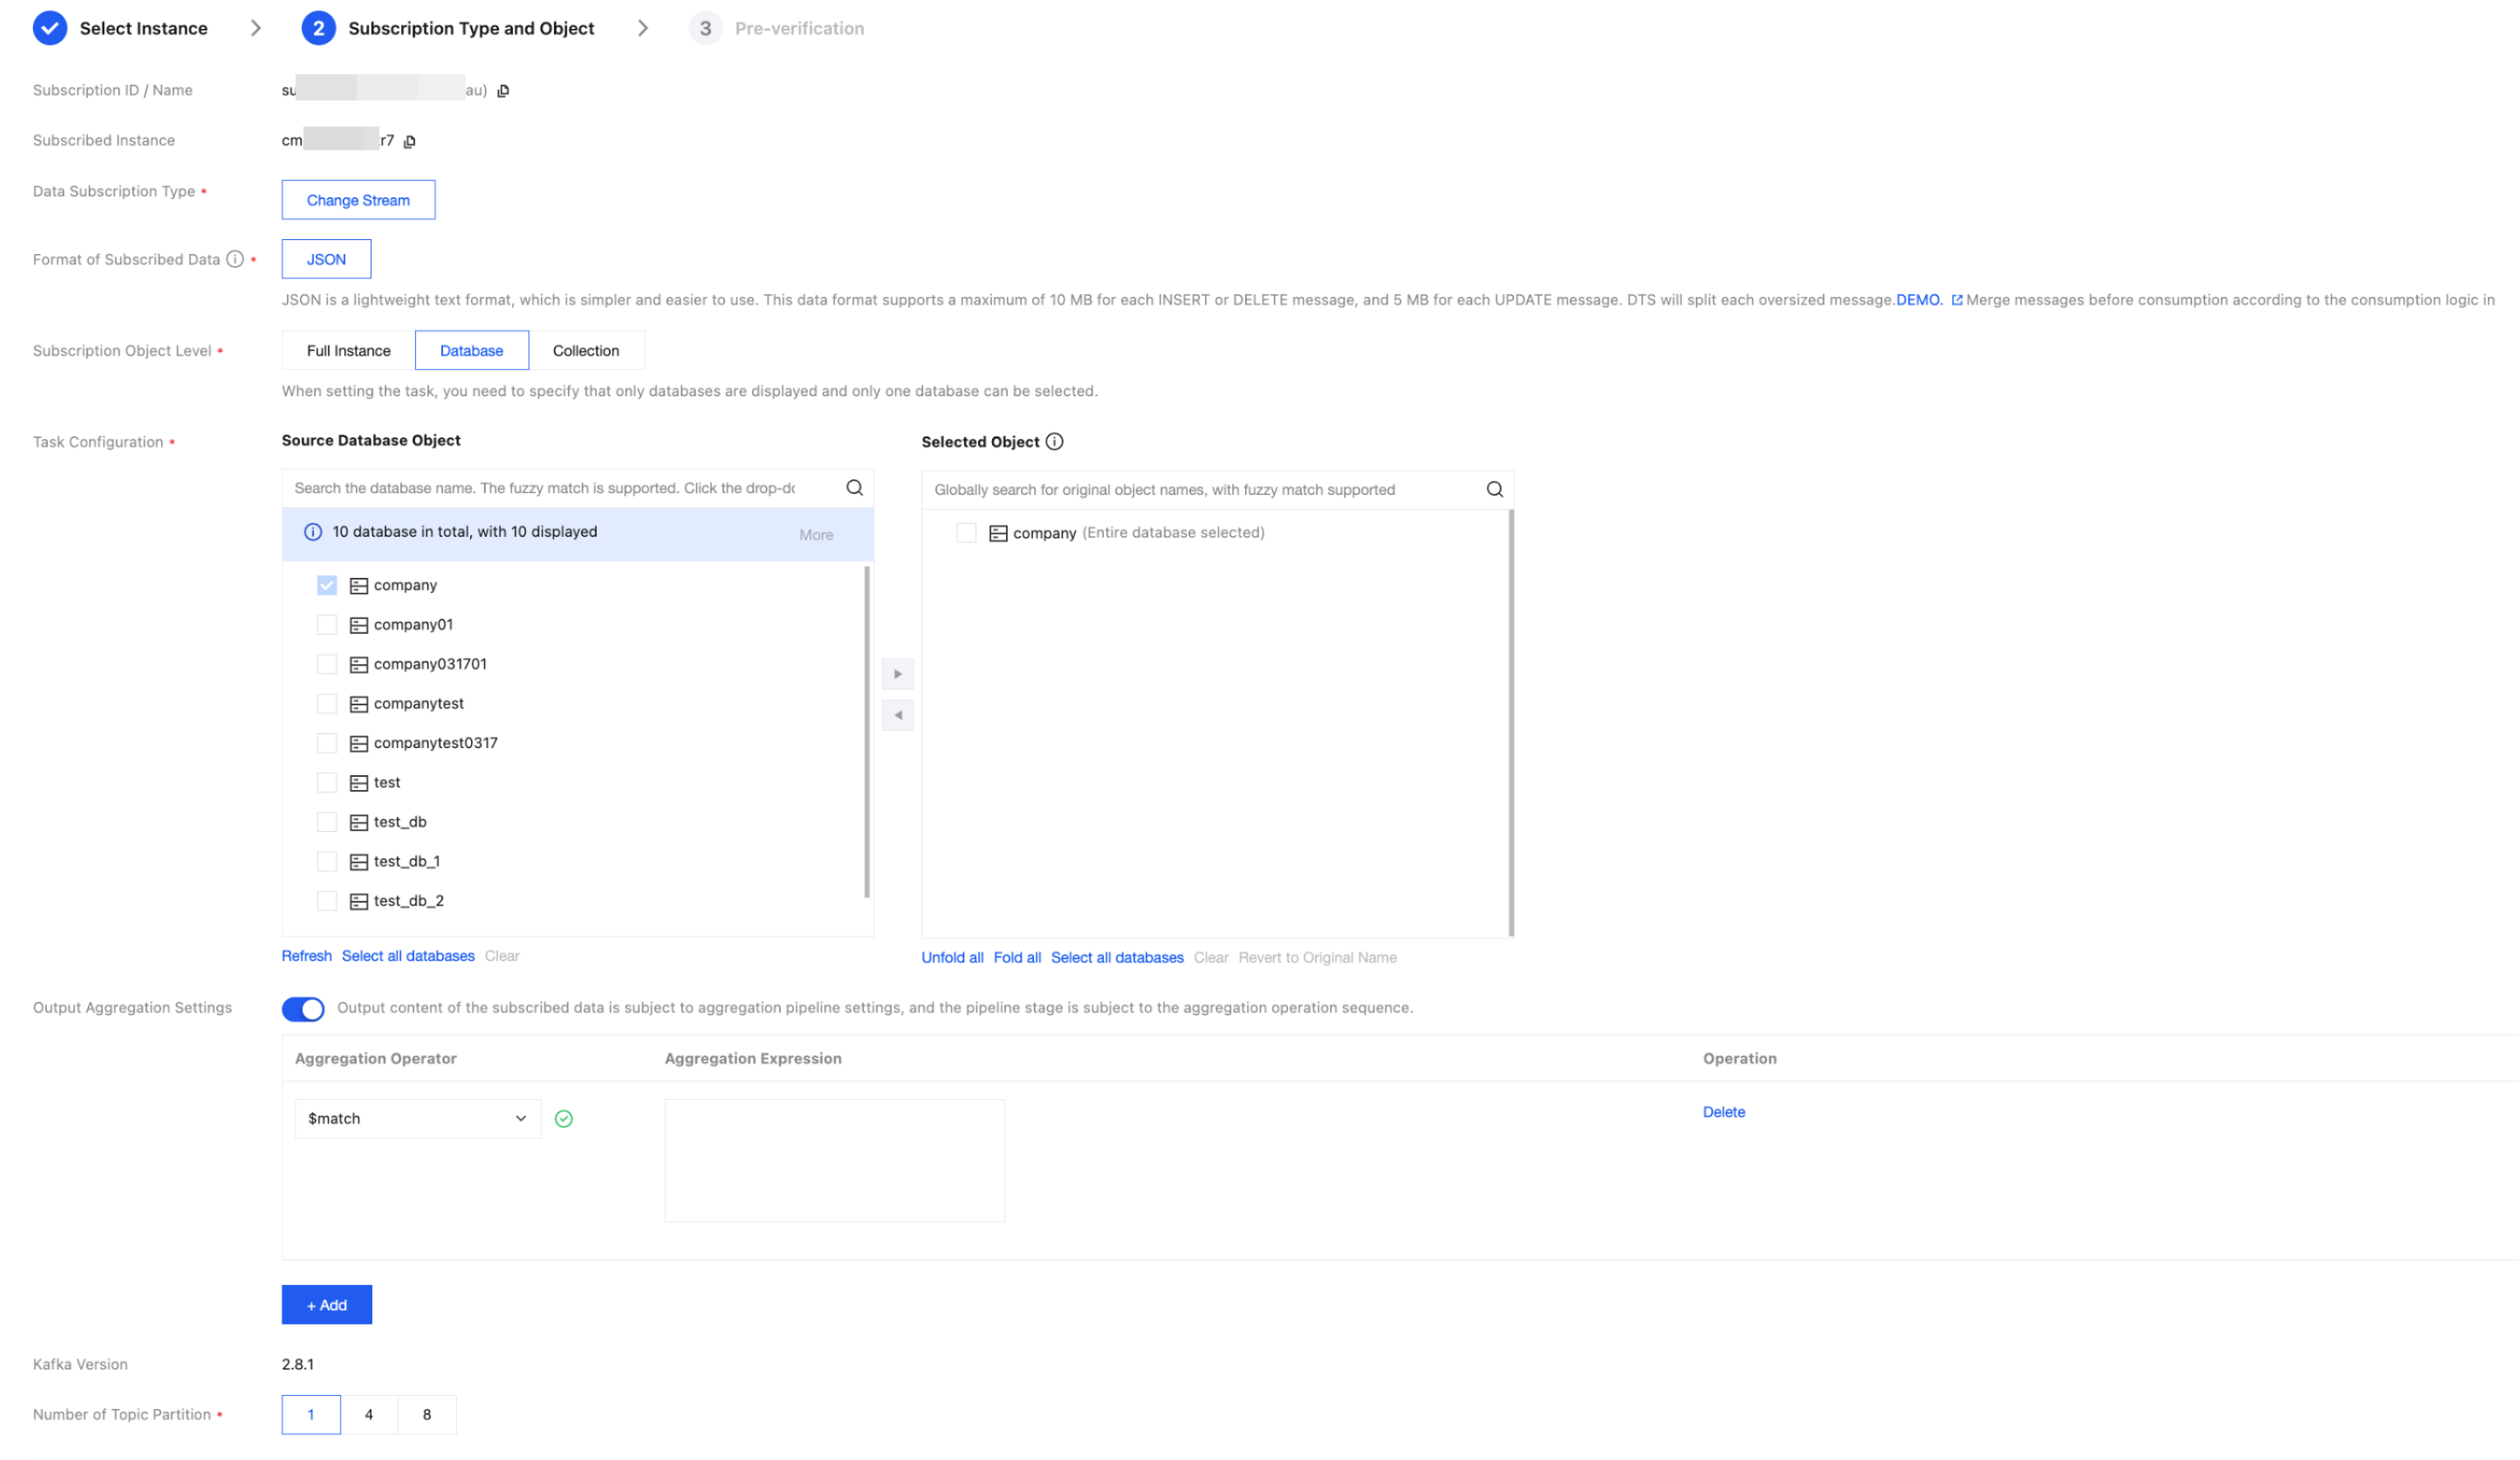
パラメータ | 説明 |
サブスクリプションタイプ | デフォルトはChange Streamで、変更できません。 |
サブスクリプションレベル | サブスクリプションレベル。全インスタンス、データベース、コレクションが含まれます。 全インスタンス:全インスタンスデータを購読します。 データベース:データベースレベルのデータを購読します。選択後、下のタスク設定では、1つのデータベースのみを選択できます。 コレクション:コレクションレベルのデータを購読します。選択後、下のタスク設定では、1つのコレクションのみを選択できます。 |
タスク設定 | サブスクリプションが必要なデータベース、コレクションを選択してください。選択できるのは1つのデータベースまたは1つのコレクションのみです。 |
出力集約設定 | |
Kafkaパーティションポリシー | コレクション名によるパーティショニング:ソースデータベースの購読データをコレクション名に従ってパーティショニングします。設定後、同じコレクション名のデータは同じKafkaパーティションに書き込まれます。 カスタムパーティションポリシー:まず正規表現を使用して購読データ内のデータベース名とコレクション名をマッチングし、マッチしたデータをコレクション名でパーティショニングするか、コレクション名 + objectidでパーティショニングします。 |
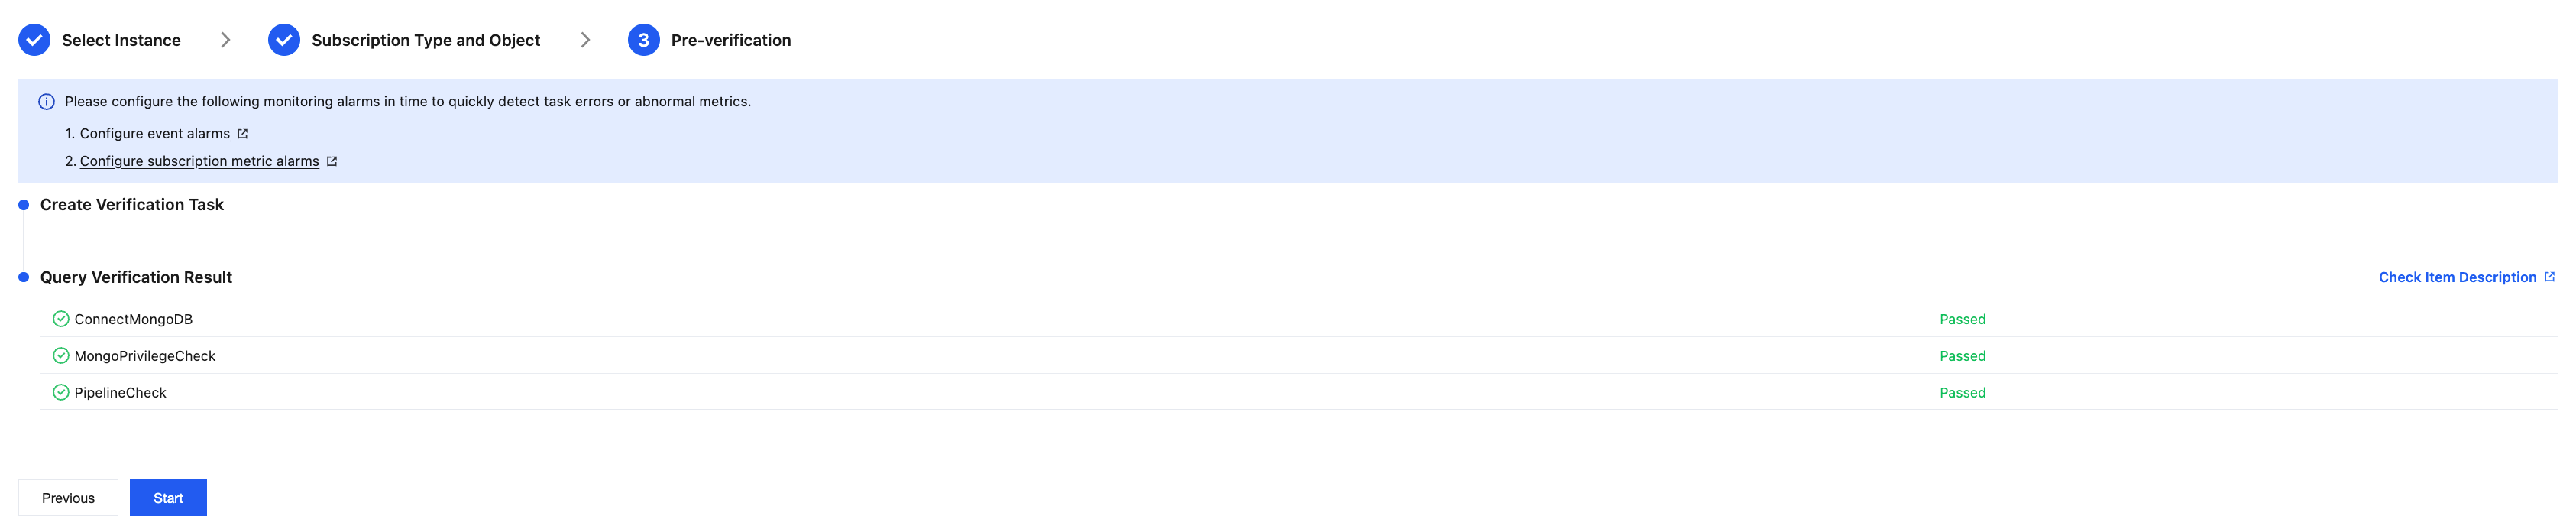
6. 事前検証ページでは、事前検証タスクの実行に2分~3分かかる見込みです。事前検証に合格した後、開始をクリックしてデータ購読タスクの設定を完了します。
説明:
7. 購読タスクは初期化を実行します。所要時間は3分~4分の見込みです。初期化が成功すると、実行中状態になります。
後続操作
1. 消費グループを追加。
データ購読Kafka版の消費はKafkaのコンシューマグループに依存します。そのため、データを消費する前にコンシューマグループを作成する必要があります。データ購読Kafka版は、ユーザーが複数のコンシューマグループを作成し、マルチポイント消費を行うことをサポートします。
2. 購読データを消費。
購読タスクが実行中状態になると、データの消費を開始できます。Kafkaの消費にはパスワード認証が必要です。詳細については、購読データの消費のDemoを参照してください。複数言語のDemoコードを提供しており、消費の主な流れと重要なデータ構造についても説明しています。
フィードバック