Redissonクライアントのタイムアウト再接続異常の分析と解決策
ダウンロード
フォーカスモード
フォントサイズ
本文は、Redissonクライアントがネットワーク変動やサービスフェイルオーバーに直面した際に発生する業務ブロッキング問題を簡潔に検討し、シンプルかつ効果的な業務レベルの解決策を提案し、類似問題の解決に示唆を提供することを目的とします。
問題の背景
Redissonクライアントを介してTencent Cloud 分散型キャッシュデータベースインスタンスに接続する際、VPCゲートウェイに障害が発生し、その継続時間は約10秒でした。ネットワーク接続を回復するため、障害のあるネットワークデバイスを隔離し、ネットワークリンクを再度復旧します。接続数は正常な業務レベルまで回復したものの、ネットワーク障害の影響を受けた業務ではエラーが継続的に発生していました。クライアントを再起動した後、システムはRedisデータベースとの接続を再確立し、業務リクエストは正常に回復しました。
異常分析
異常の発生プロセスに基づき、問題シーンを再現し、エラーログ情報を取得し、Redisson接続の内部動作メカニズムを深く分析し、潜在的な問題を特定します。
問題の再現
ネットワークの継続的なジッターという複雑なシナリオにおいて、テストと可視化を容易にするため、CVM上でiptablesルールを設定し、Redisサービスへのアクセスを遮断することでネットワークジッターの効果をシミュレートします。その後、遮断を解除してネットワークリンクを復旧し、業務リクエスト発生時のエラーログ情報を収集します。
1. コードの明確性と理解しやすさを確保するために、Tencent Cloud 分散型キャッシュデータベースサーバーに接続するためのシンプルなRedissonクライアント例を設計します。接続成功後、継続的なタスクをシミュレートするために簡単なwhileループを実行します。
説明:
以下のコードでは、
config-file.yaml設定ファイルにRedisサーバーのアドレス、ポート、パスワード、およびtimeout(3000ms)などの情報を設定します。設定情報に基づいて、Redisへの接続を確立します。本サンプルではRedisson 3.23.4バージョンを例に紹介します。異なるバージョンのRedissonではいくつかの差異が存在する可能性があるため、Redisson公式ドキュメントを参照するか問い合わせることをお勧めします。
package org.example;// Redisson関連のパッケージをインポートします。import org.redisson.Redisson;import org.redisson.api.RAtomicLong;import org.redisson.api.RedissonClient;import org.redisson.config.Config;import org.redisson.connection.balancer.RoundRobinLoadBalancer;// Java IO関連のパッケージをインポートします。import java.io.File;import java.io.IOException;public class Main {public static void main(String[] args) throws IOException {// YAMLファイルからRedissonの設定情報を読み取ります。Config config = Config.fromYAML(new File("/data/home/test**/redissontest/src/main/resources/config-file.yaml"));RedissonClient redisson = Redisson.create(config);// カウンタ変数を初期化します。int i = 0;// 1000000回ループします。while(i++ < 1000000){// 現在のカウンタ値をキーとして、アトミックな長整数オブジェクトを取得します。RAtomicLong atomicLong = redisson.getAtomicLong(Integer.toString(i));// アトミックな長整数オブジェクトの値に対してアトミックに1を減算する操作を実行します。atomicLong.getAndDecrement();}// Redissonクライアントを閉じます。redisson.shutdown();}}
2. クライアントが正常に起動し、しばらく動作した後、iptablesの設定を変更してRedisへの接続を遮断します。
sudo iptables -A INPUT -s 10.0.16.6 -p tcp --sport 6379 -m conntrack --ctstate NEW,ESTABLISHED -j DROP
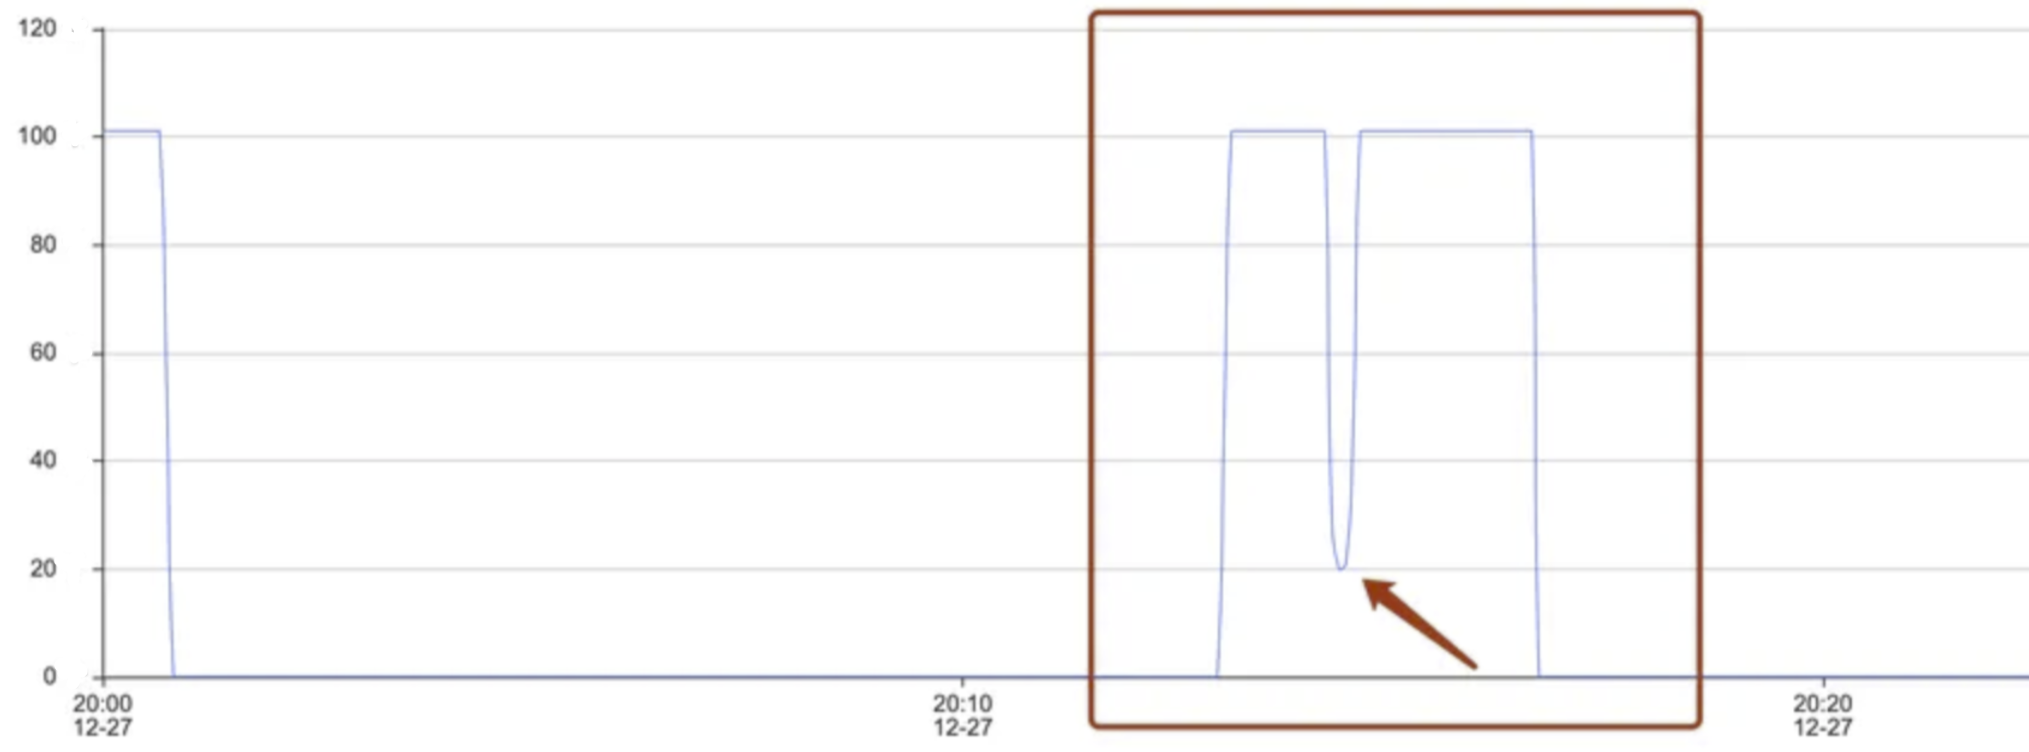
3. Distributed Cacheコンソールのシステム監視ページで、接続数の指標を確認します。この指標は直線的な下降傾向を示しており、下図の通りです。
4. 以下のコマンドを実行し、iptablesの設定を変更して接続の遮断を解除し、ネットワークを復旧します。
sudo iptables -D INPUT -s 10.0.16.6 -p tcp --sport 6379 -m conntrack --ctstate NEW,ESTABLISHED -j DROP
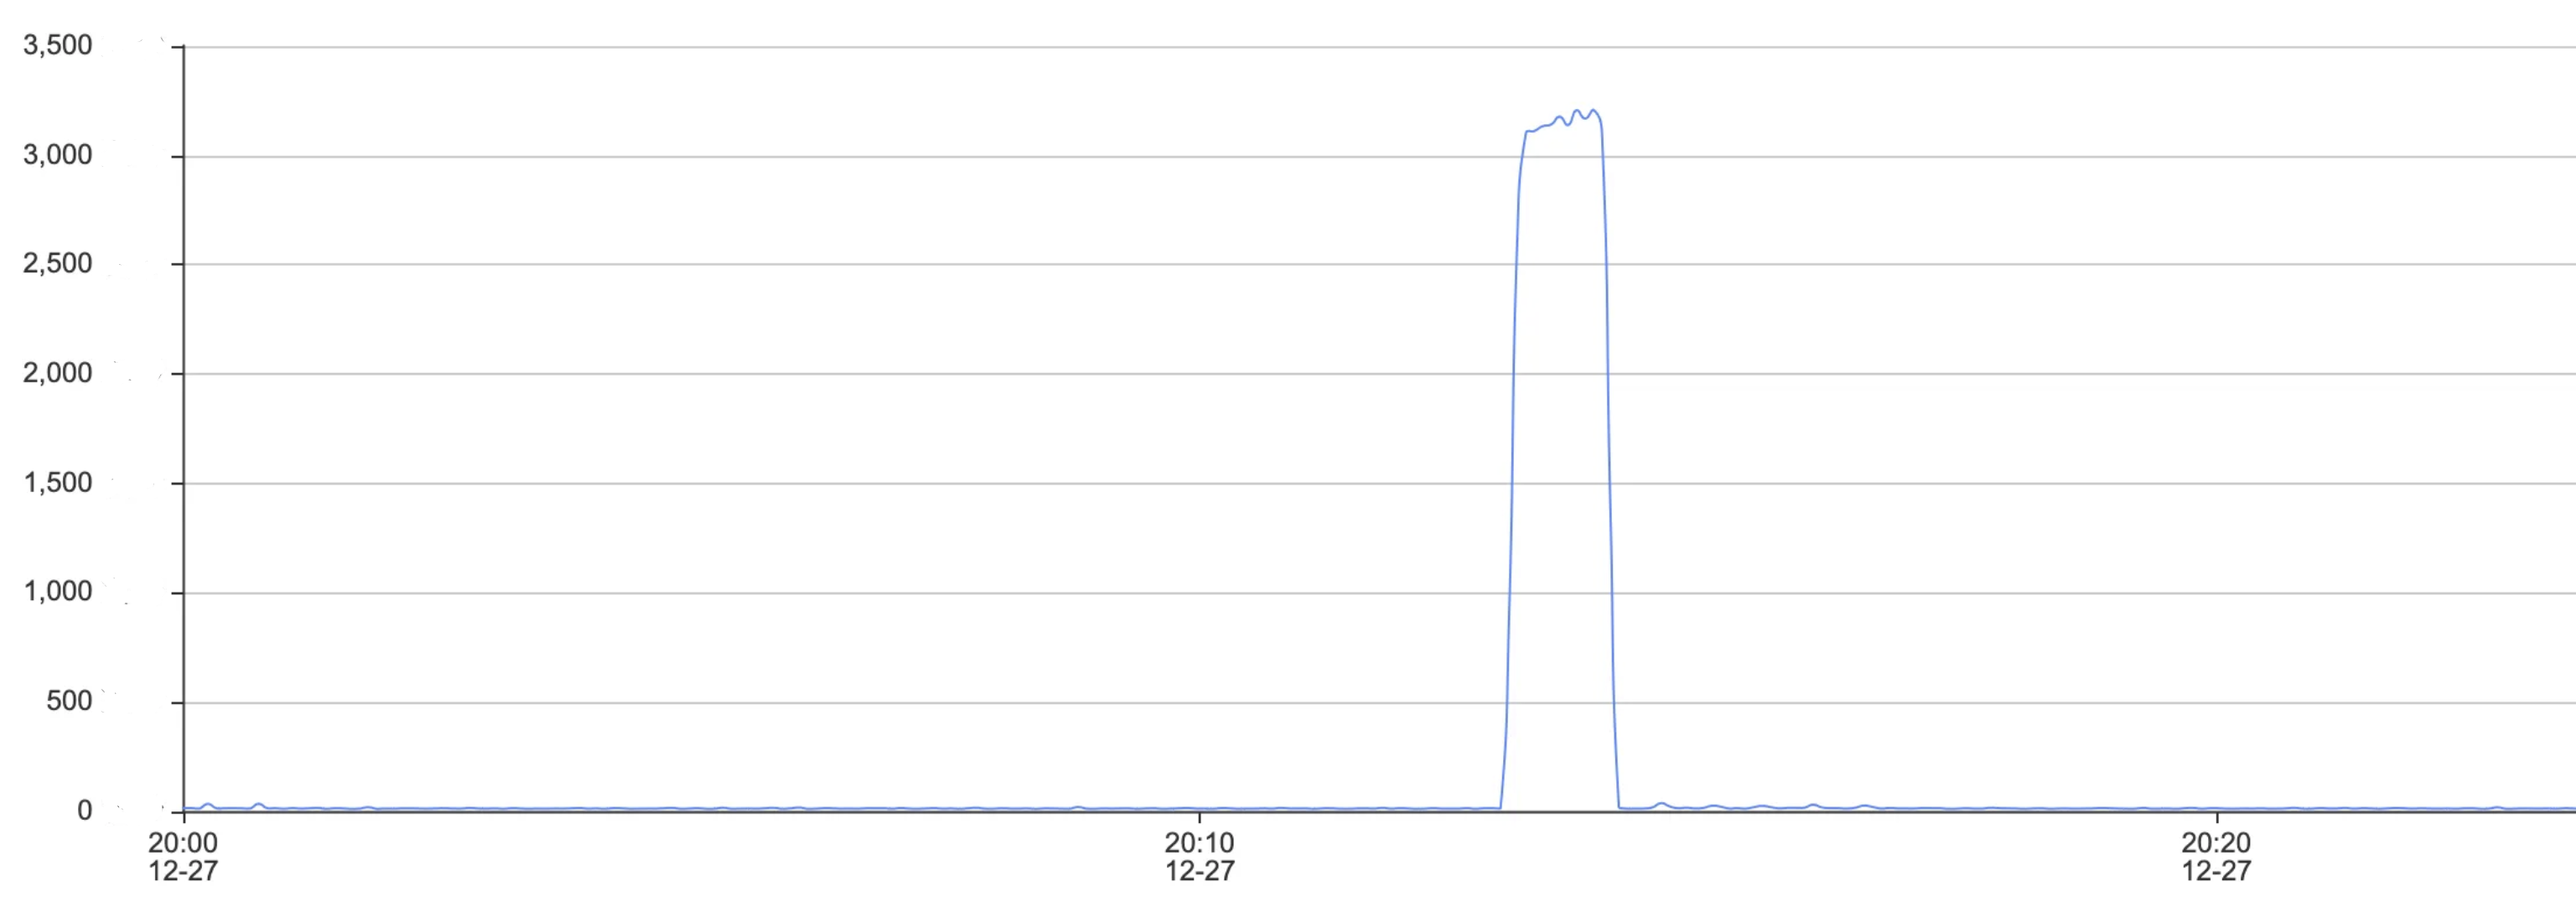
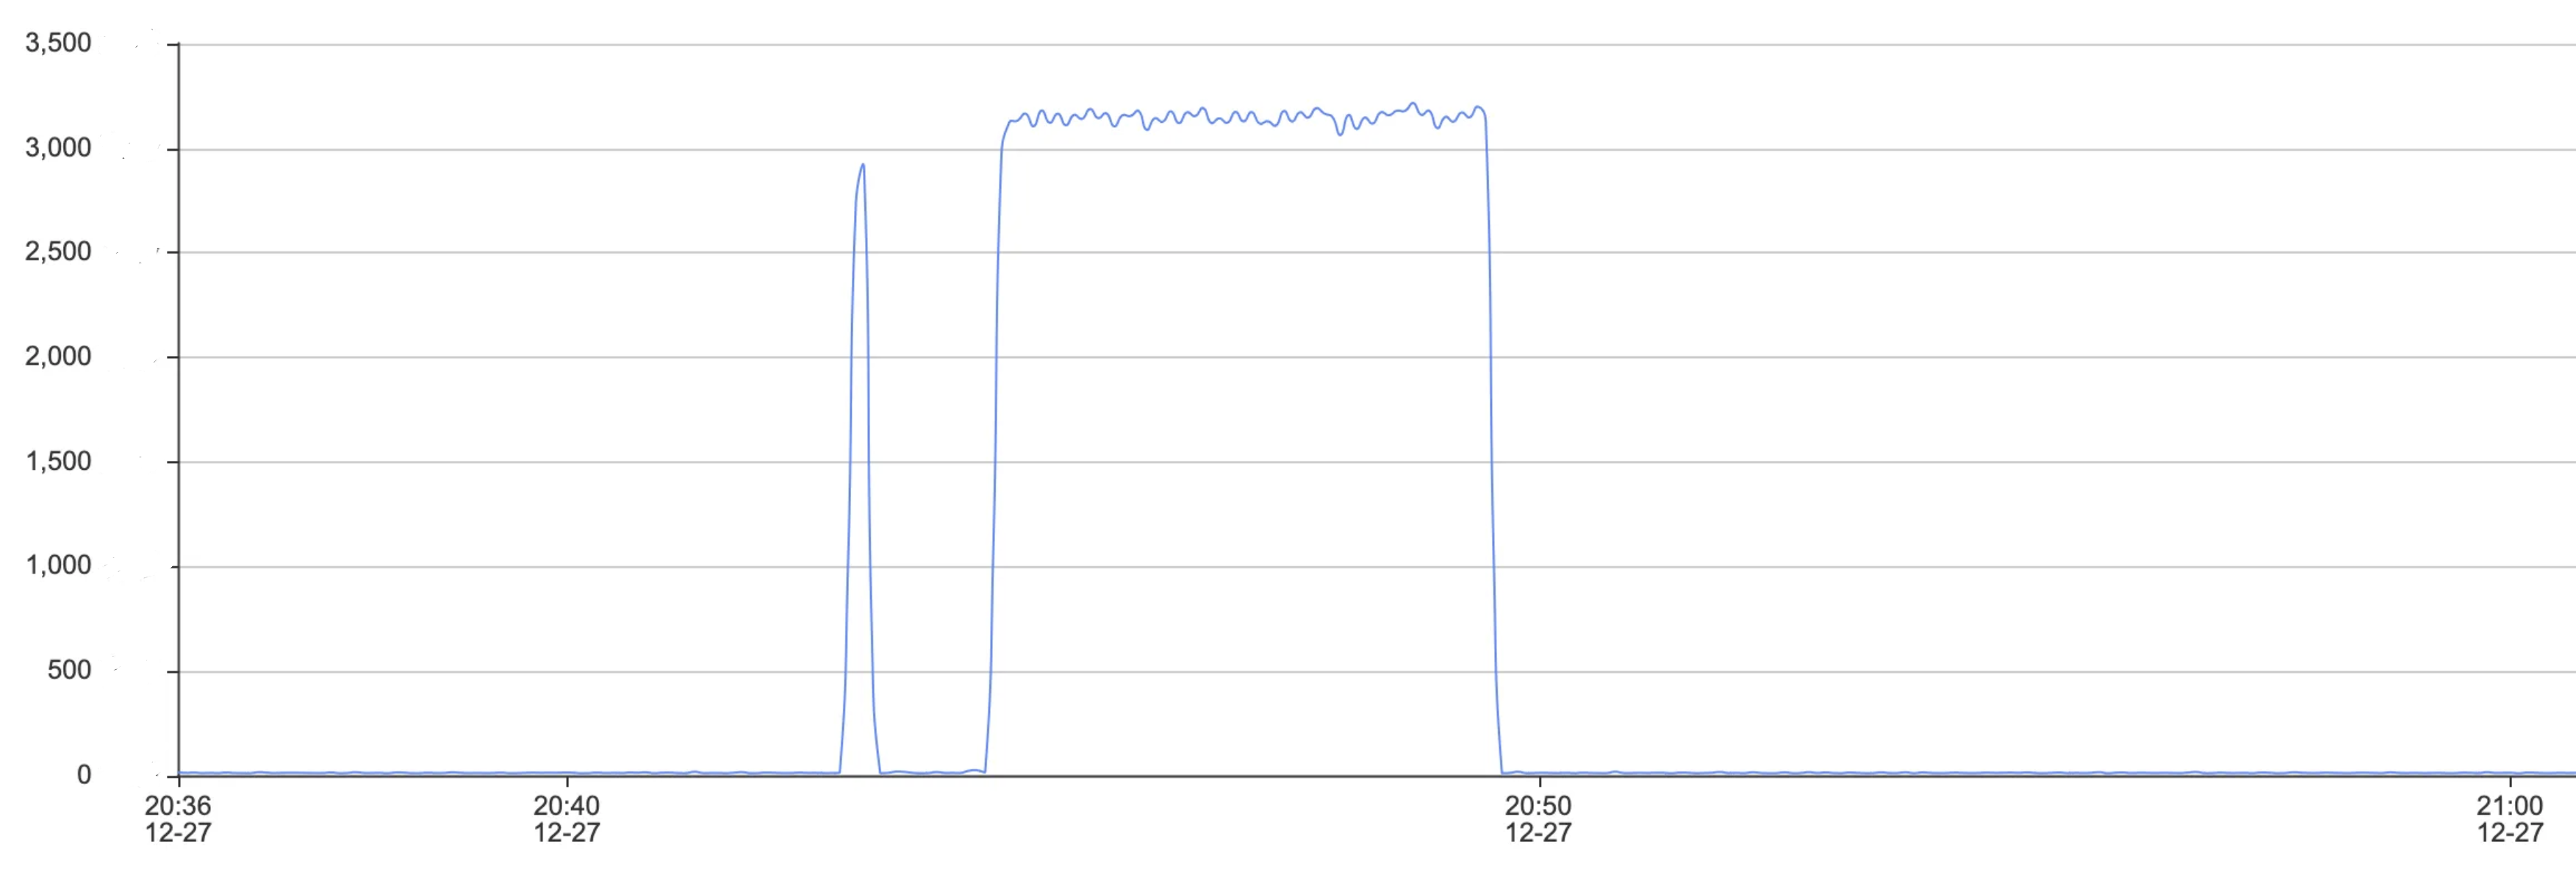
5. ネットワークが正常に復旧した後、クライアントは迅速に再接続を行います。Distributed Cacheコンソールのシステム監視ページで指標を再度確認します。接続数は元の水準に回復しますが、総リクエストは依然として異常であり、下記の通りです。
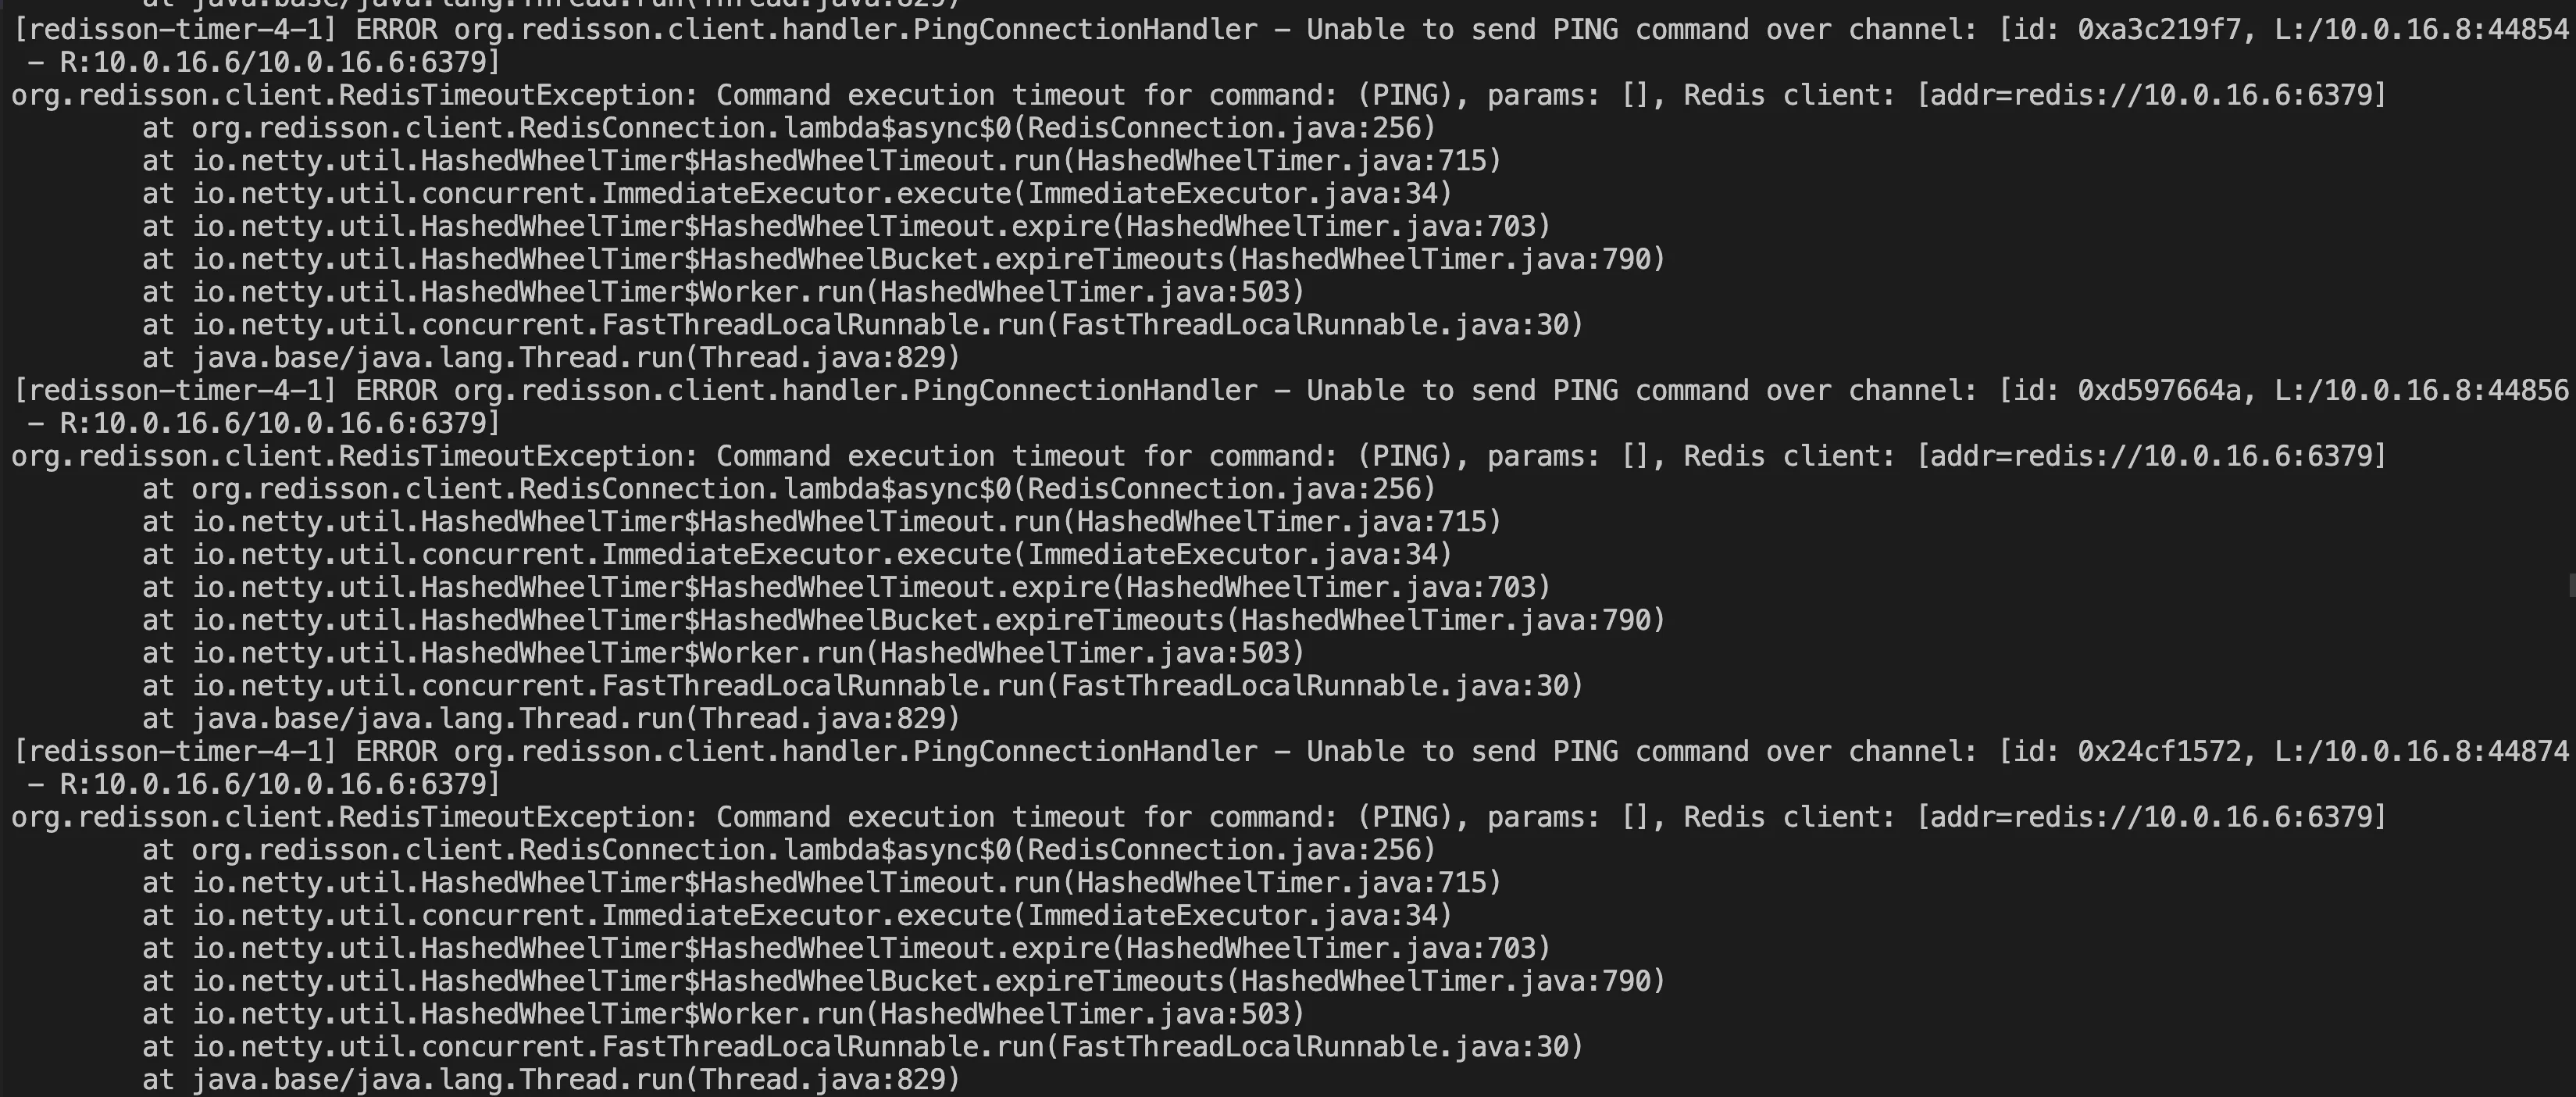
6. 異常ログ情報を取得します。下図に示す通りです。
ソースコードの分析
エラー情報に基づいてコードを逐一分析し、問題を特定することで、Redissonは再接続時に例外エラーが発生した後、新しいChannelを再取得しようとしない動作が原因で、リクエストが継続的にエラーを返すことを理解できます。
1. エラー情報
Unable to send PING command over channelが発生したため、PingConnectionHandlerのコードを確認します。以下に示します。PING再接続検出が失敗してエラーが発生した後、ctx.channel().close()を実行して異常なchannelを閉じ、さらにconnection.getRedisClient().getConfig().getFailedNodeDetector().onPingFailed();を実行して現在の接続クライアントの状態を検出していることがわかります。if(connection.getUsage() == 0 && future != null && (future.cancel(false) || cause(future) != null)) {Throwable cause = cause(future);if (!(cause instanceof RedisRetryException)) {if (!future.isCancelled()) {log.error("Unable to send PING command over channel: {}", ctx.channel(), cause);}log.debug("channel: {} closed due to PING response timeout set in {} ms", ctx.channel(), config.getPingConnectionInterval());ctx.channel().close();connection.getRedisClient().getConfig().getFailedNodeDetector().onPingFailed();} else {connection.getRedisClient().getConfig().getFailedNodeDetector().onPingSuccessful();sendPing(ctx);}} else {connection.getRedisClient().getConfig().getFailedNodeDetector().onPingSuccessful();sendPing(ctx);}
2. Connectionのソースをさらに分析します。
RedisConnection connection = RedisConnection.getFrom(ctx.channel());接続を作成するコンストラクタRedisConnection()を確認します。以下に示します。この関数はchannel属性を作成・更新し、接続の最終使用時刻を記録しますが、新しいChannelに切り替えて接続を試みる動作はありません。public <C> RedisConnection(RedisClient redisClient, Channel channel, CompletableFuture<C> connectionPromise) {this.redisClient = redisClient;this.connectionPromise = connectionPromise;updateChannel(channel);lastUsageTime = System.nanoTime();LOG.debug("Connection created {}", redisClient);}// updateChannelはChannelの属性を更新します。public void updateChannel(Channel channel) {if (channel == null) {throw new NullPointerException();}this.channel = channel;channel.attr(CONNECTION).set(this);}
3. クラスタ情報を更新すると、接続に以下のエラーメッセージが表示されます。
ERROR org.redisson.cluster.ClusterConnectionManager - Can't update cluster stateorg.redisson.client.RedisTimeoutException: Command execution timeout for command: (CLUSTER NODES), params: [], Redis client: [addr=redis://10.0.16.7:6379] at org.redisson.client.RedisConnection.lambda$async$0(RedisConnection.java:256) at io.netty.util.HashedWheelTimer$HashedWheelTimeout.run(HashedWheelTimer.java:715) at io.netty.util.concurrent.ImmediateExecutor.execute(ImmediateExecutor.java:34) at io.netty.util.HashedWheelTimer$HashedWheelTimeout.expire(HashedWheelTimer.java:703) at io.netty.util.HashedWheelTimer$HashedWheelBucket.expireTimeouts(HashedWheelTimer.java:790) at io.netty.util.HashedWheelTimer$Worker.run(HashedWheelTimer.java:503) at io.netty.util.concurrent.FastThreadLocalRunnable.run(FastThreadLocalRunnable.java:30) at java.base/java.lang.Thread.run(Thread.java:829)
4.
ClusterConnectionManager.javaでクラスタ更新のエラーメッセージ部分を特定できます。 Can't update cluster state例外がスローされた後、クラスタ状態の変更のみを確認し、接続プールから新しい接続を取得して操作する動作は行わず、そのまま返していることがわかります。private void checkClusterState(ClusterServersConfig cfg, Iterator<RedisURI> iterator, AtomicReference<Throwable> lastException) {if (!iterator.hasNext()) {if (lastException.get() != null) {log.error("Can't update cluster state", lastException.get());}// クラスタ状態の変更を確認します。scheduleClusterChangeCheck(cfg);return;}......}
ソリューション
上記の問題に基づき、業務側のコードを調整します。異常な接続が発生した場合には、現在の接続スレッドを能動的に中断し、Channelと接続設定を再構成して、再接続操作を行います。
コードの調整
以下のコードは、問題再現時に設計したコードを基に最適化し、異常再接続の操作を追加したものです。
package org.example;import org.redisson.Redisson;import org.redisson.api.RAtomicLong;import org.redisson.api.RedissonClient;import org.redisson.config.Config;import org.redisson.connection.balancer.RoundRobinLoadBalancer;import java.io.File;import java.io.IOException;public class Main {public static void main(String[] args) throws IOException {boolean connected = false;RedissonClient redisson = null;while (!connected) {try {Config config = Config.fromYAML(new File("/data/home/sharmaxia/redissontest/src/main/resources/config-file.yaml"));redisson = Redisson.create(config);connected = true;} catch (Exception e) {e.printStackTrace();try {Thread.sleep(1000);} catch (InterruptedException ex) {Thread.currentThread().interrupt(); //現在のスレッドを能動的に中断し、接続プールから接続を再取得します。}}}int i = 0;while (i++ < 1000000) {try {RAtomicLong atomicLong = redisson.getAtomicLong(Integer.toString(i));atomicLong.getAndDecrement();} catch (Exception e) {e.printStackTrace();try {Thread.sleep(1000);} catch (InterruptedException ex) {Thread.currentThread().interrupt(); //現在のスレッドを能動的に中断し、接続プールから接続を再取得します。}i--;}}redisson.shutdown();}}
結果の検証
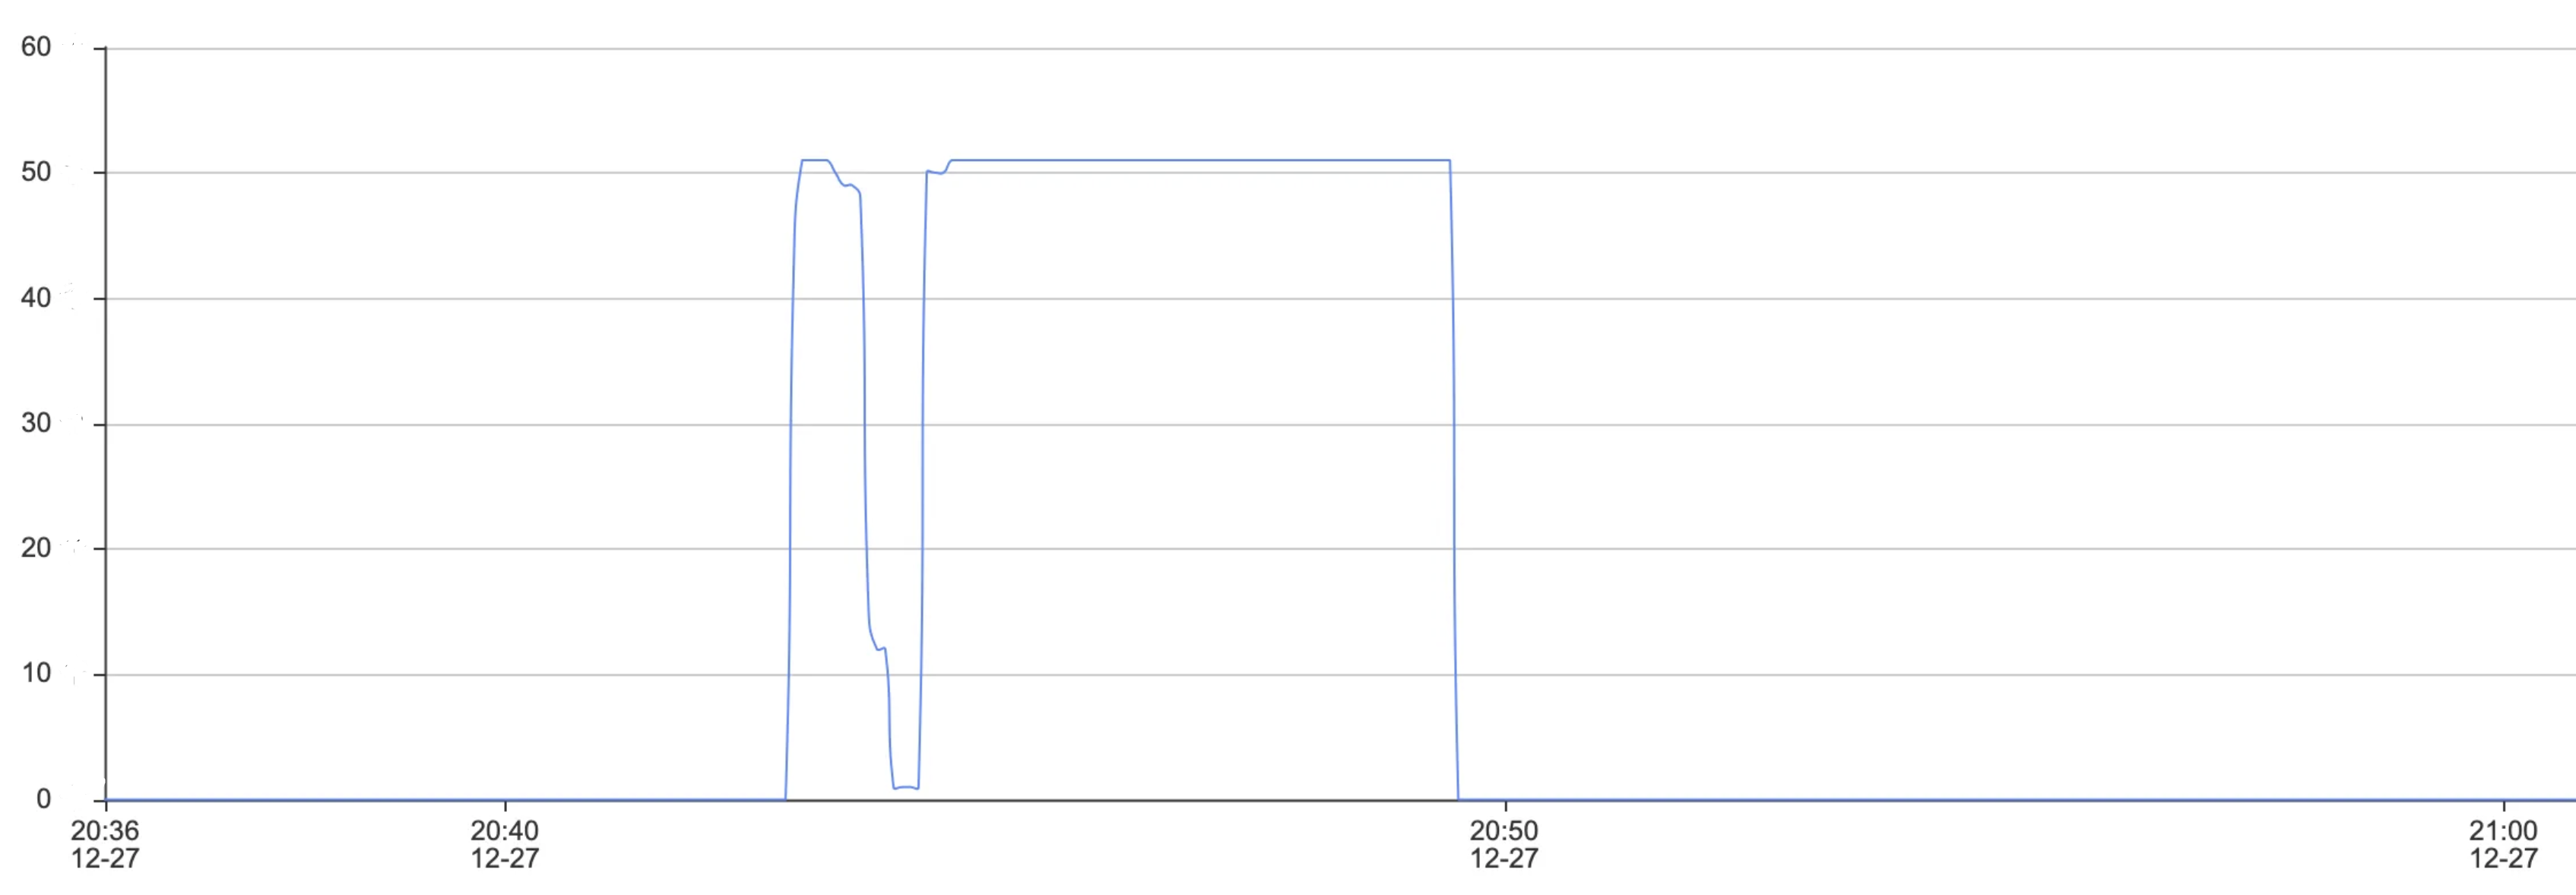
接続数と総リクエストの監視指標を確認し、業務が正常に戻ったことを確認します。これにより、コード調整後に、Redissonクライアントのタイムアウト再接続異常による業務障害が解決されたことを検証します。
接続数
総リクエスト数
フィードバック