CKafka 到 ClickHouse 使用云数据仓库 TCHouse-C 方案
下载
聚焦模式
字号
一、迁移场景
目标:CKafka 数据写入数据仓库 (ClickHouse) 。
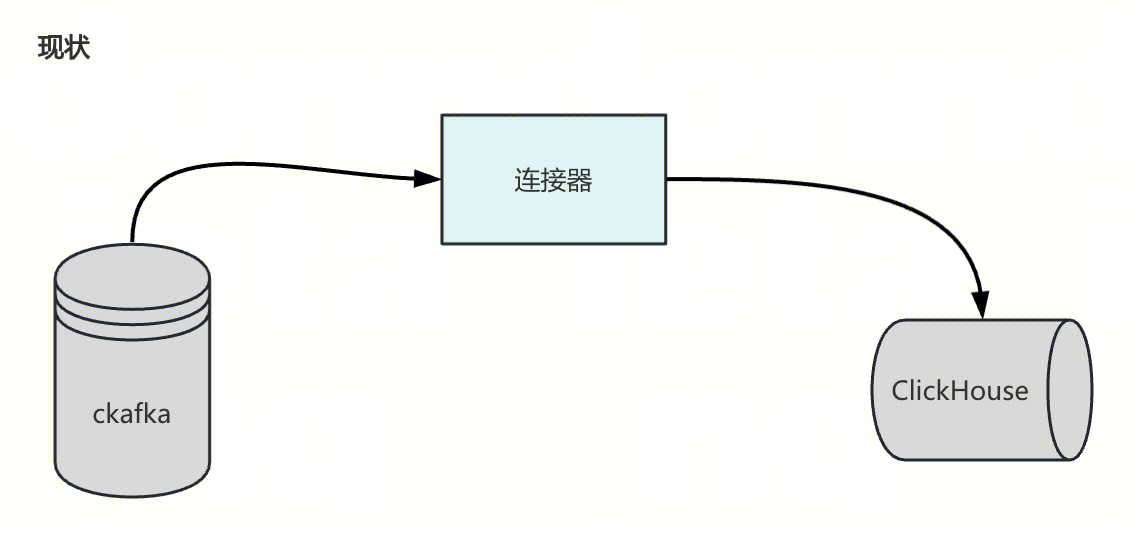
存量迁移方案:把 CKafka 中实时消费数据同步到云数据仓库 TCHouse-C。
新增的同步链路请直接参考本文档第四部分。
二、迁移步骤
简述:在 ClickHouse 平台创建 Kafka 引擎表和物化视图,把 Kafka 的表数据导入到数据仓库。
在 CKafka 控制台查询 topic 和 group 信息,ClickHouse 的仓库表信息。
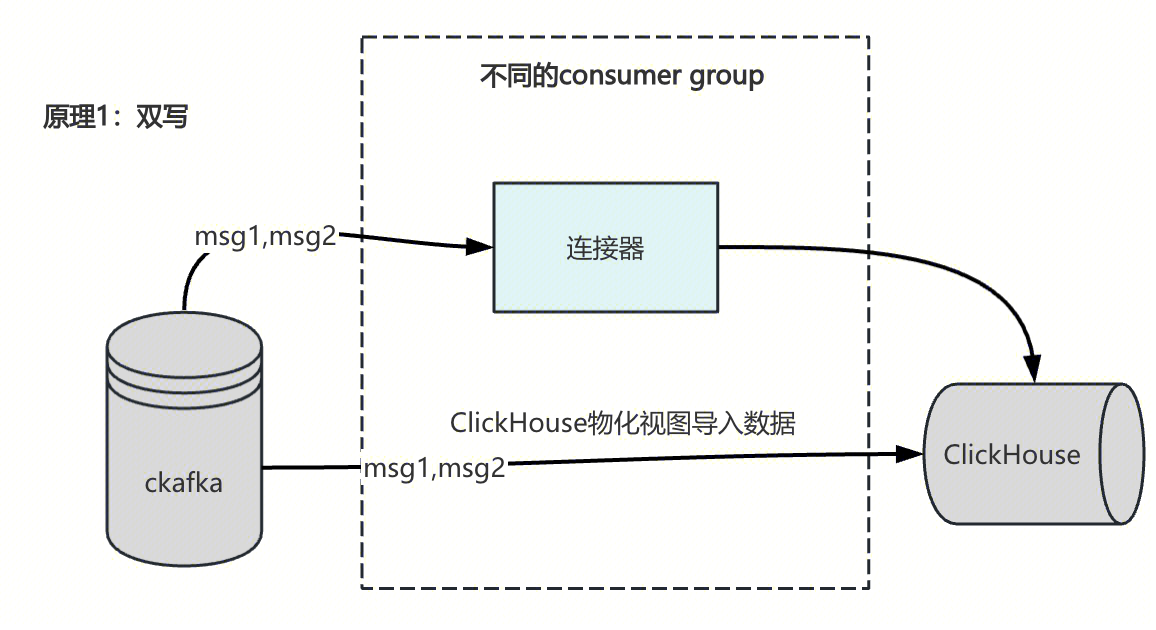
双写:在 TCHouse-C 平台建立 Kafka 消费表,建立全新的 consumer group。建立一条单独的导入数据任务,和连接器的任务区分,各自独立消费 kafka 数据。
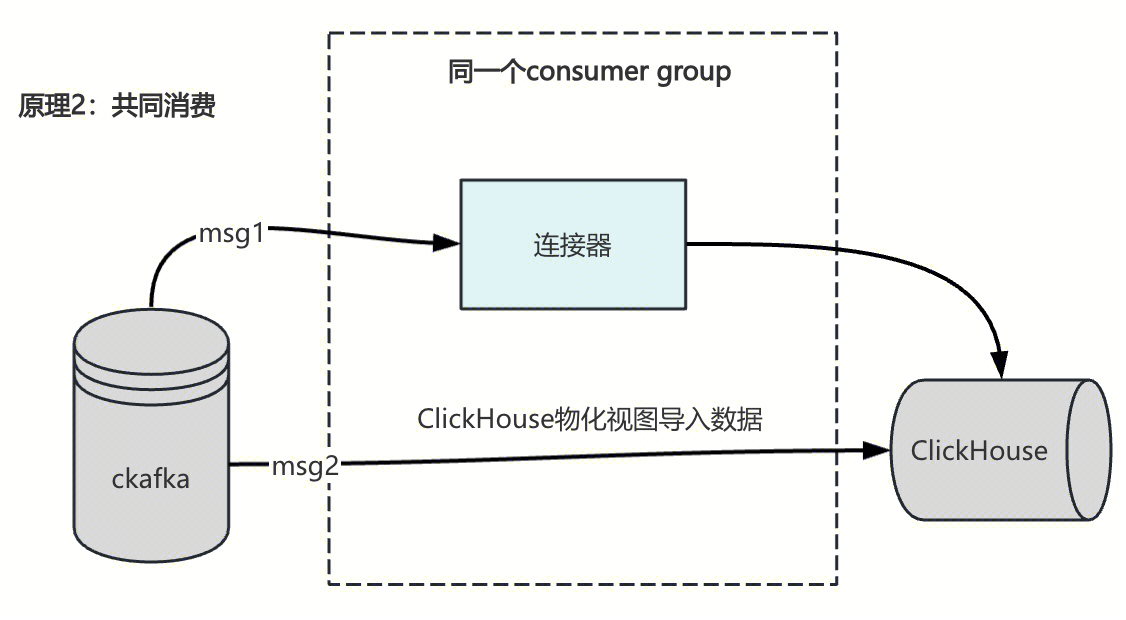
共同消费:共用连接器的 consumer group,click house 的导入数据任务相当于增加了一个消费组,和连接器任务共同消费 Kafka 数据。
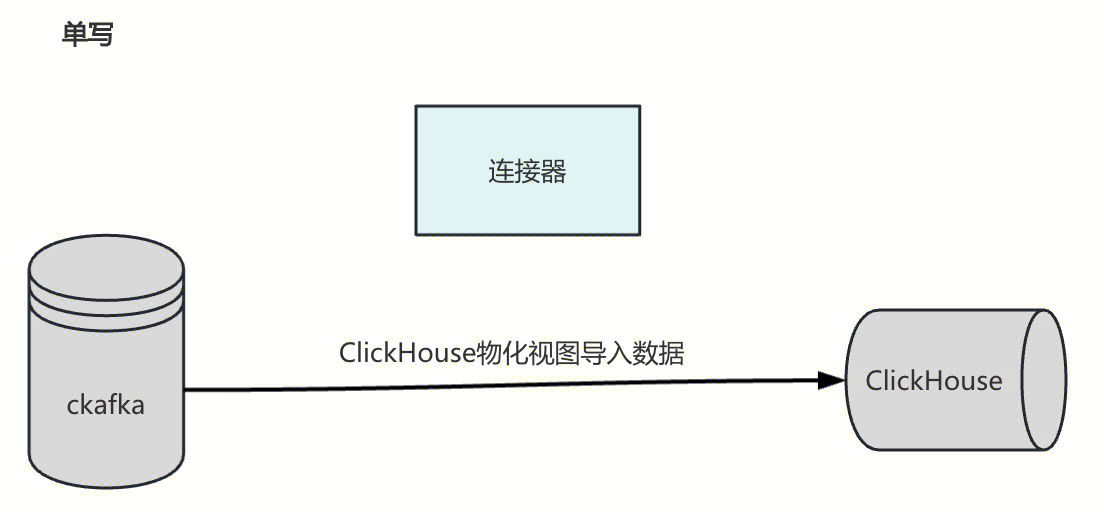
单写:在 CKafka 控制台停止连接器任务。
三、方案
3.1. 方案对比
方案 | 方案1:双写 -> 单写 | 方案2:共同消费 |
思路 | 创建全新的 consumer group,在 TCHouse-C 平台建立一条单独的导入数据任务。 | 共用连接器的 consumer group,click house 的导入数据任务相当于增加了一个消费组,和连接器任务共同消费 Kafka 数据 |
实施策略 | 主动迁移,提前规避风险。 低峰期主动启动 ClickHouse Kafka 数据导入任务,下线 CKafka 连接器 低峰期操作,风险可控 | 被动迁移,防止二次故障。 提前准备好 ClickHouse kafka 数据导入任务的 SQL 预案,在连接器故障后,启动任务。 在 Kafka 平台新建 consumer group 或者使用已存在的消费组; 连接器故障或者异常后,在 TCHouse-C 平台建立 Kafka 消费表,生成物化视图导入数据。 |
优点 | 链路独立,互不影响 低峰期操作,风险可控 | 数据不会重复 现有任务暂时不动,业务短期不受影响 |
缺点 | 双写产生的日志数据会有少量重复 | 共同消费有 rebalance 风险,若遇到 topic 是单分区,无法判断 ClickHouse 的导入任务是否正常; 自定义创建表要求高,若任务配置错误,有丢数据的风险; 需要提前收集连接器的消费组信息,隐藏深,易用性差。 故障后的止损预案,时效性低,故障影响面不可控; 仓库表可能存在少量数据重复。 |
回滚方案 | - | 双写阶段:如果遇到不符合预期,可以直接删除 TCHouse-C 平台的 Kafka 导入数据任务。 单写阶段:如果发现不符合预期,可以把连接器再次启动,同时删除 TCHouse-C 平台的 Kafka 导入数据任务。 |
兜底预案 | - | TCHouse-C 平台删除 Kafka 导入数据任务,即删除 kafka 消费表和物化视图; CKafka 连接器任务重启。 |
3.2. 注意事项
kafka_auto_offset_reset 配置已经失效,若消费组不存在,新建默认是从最老开始消费;已经存在的消费组,默认从消费位点开始消费。
四、POC 验证
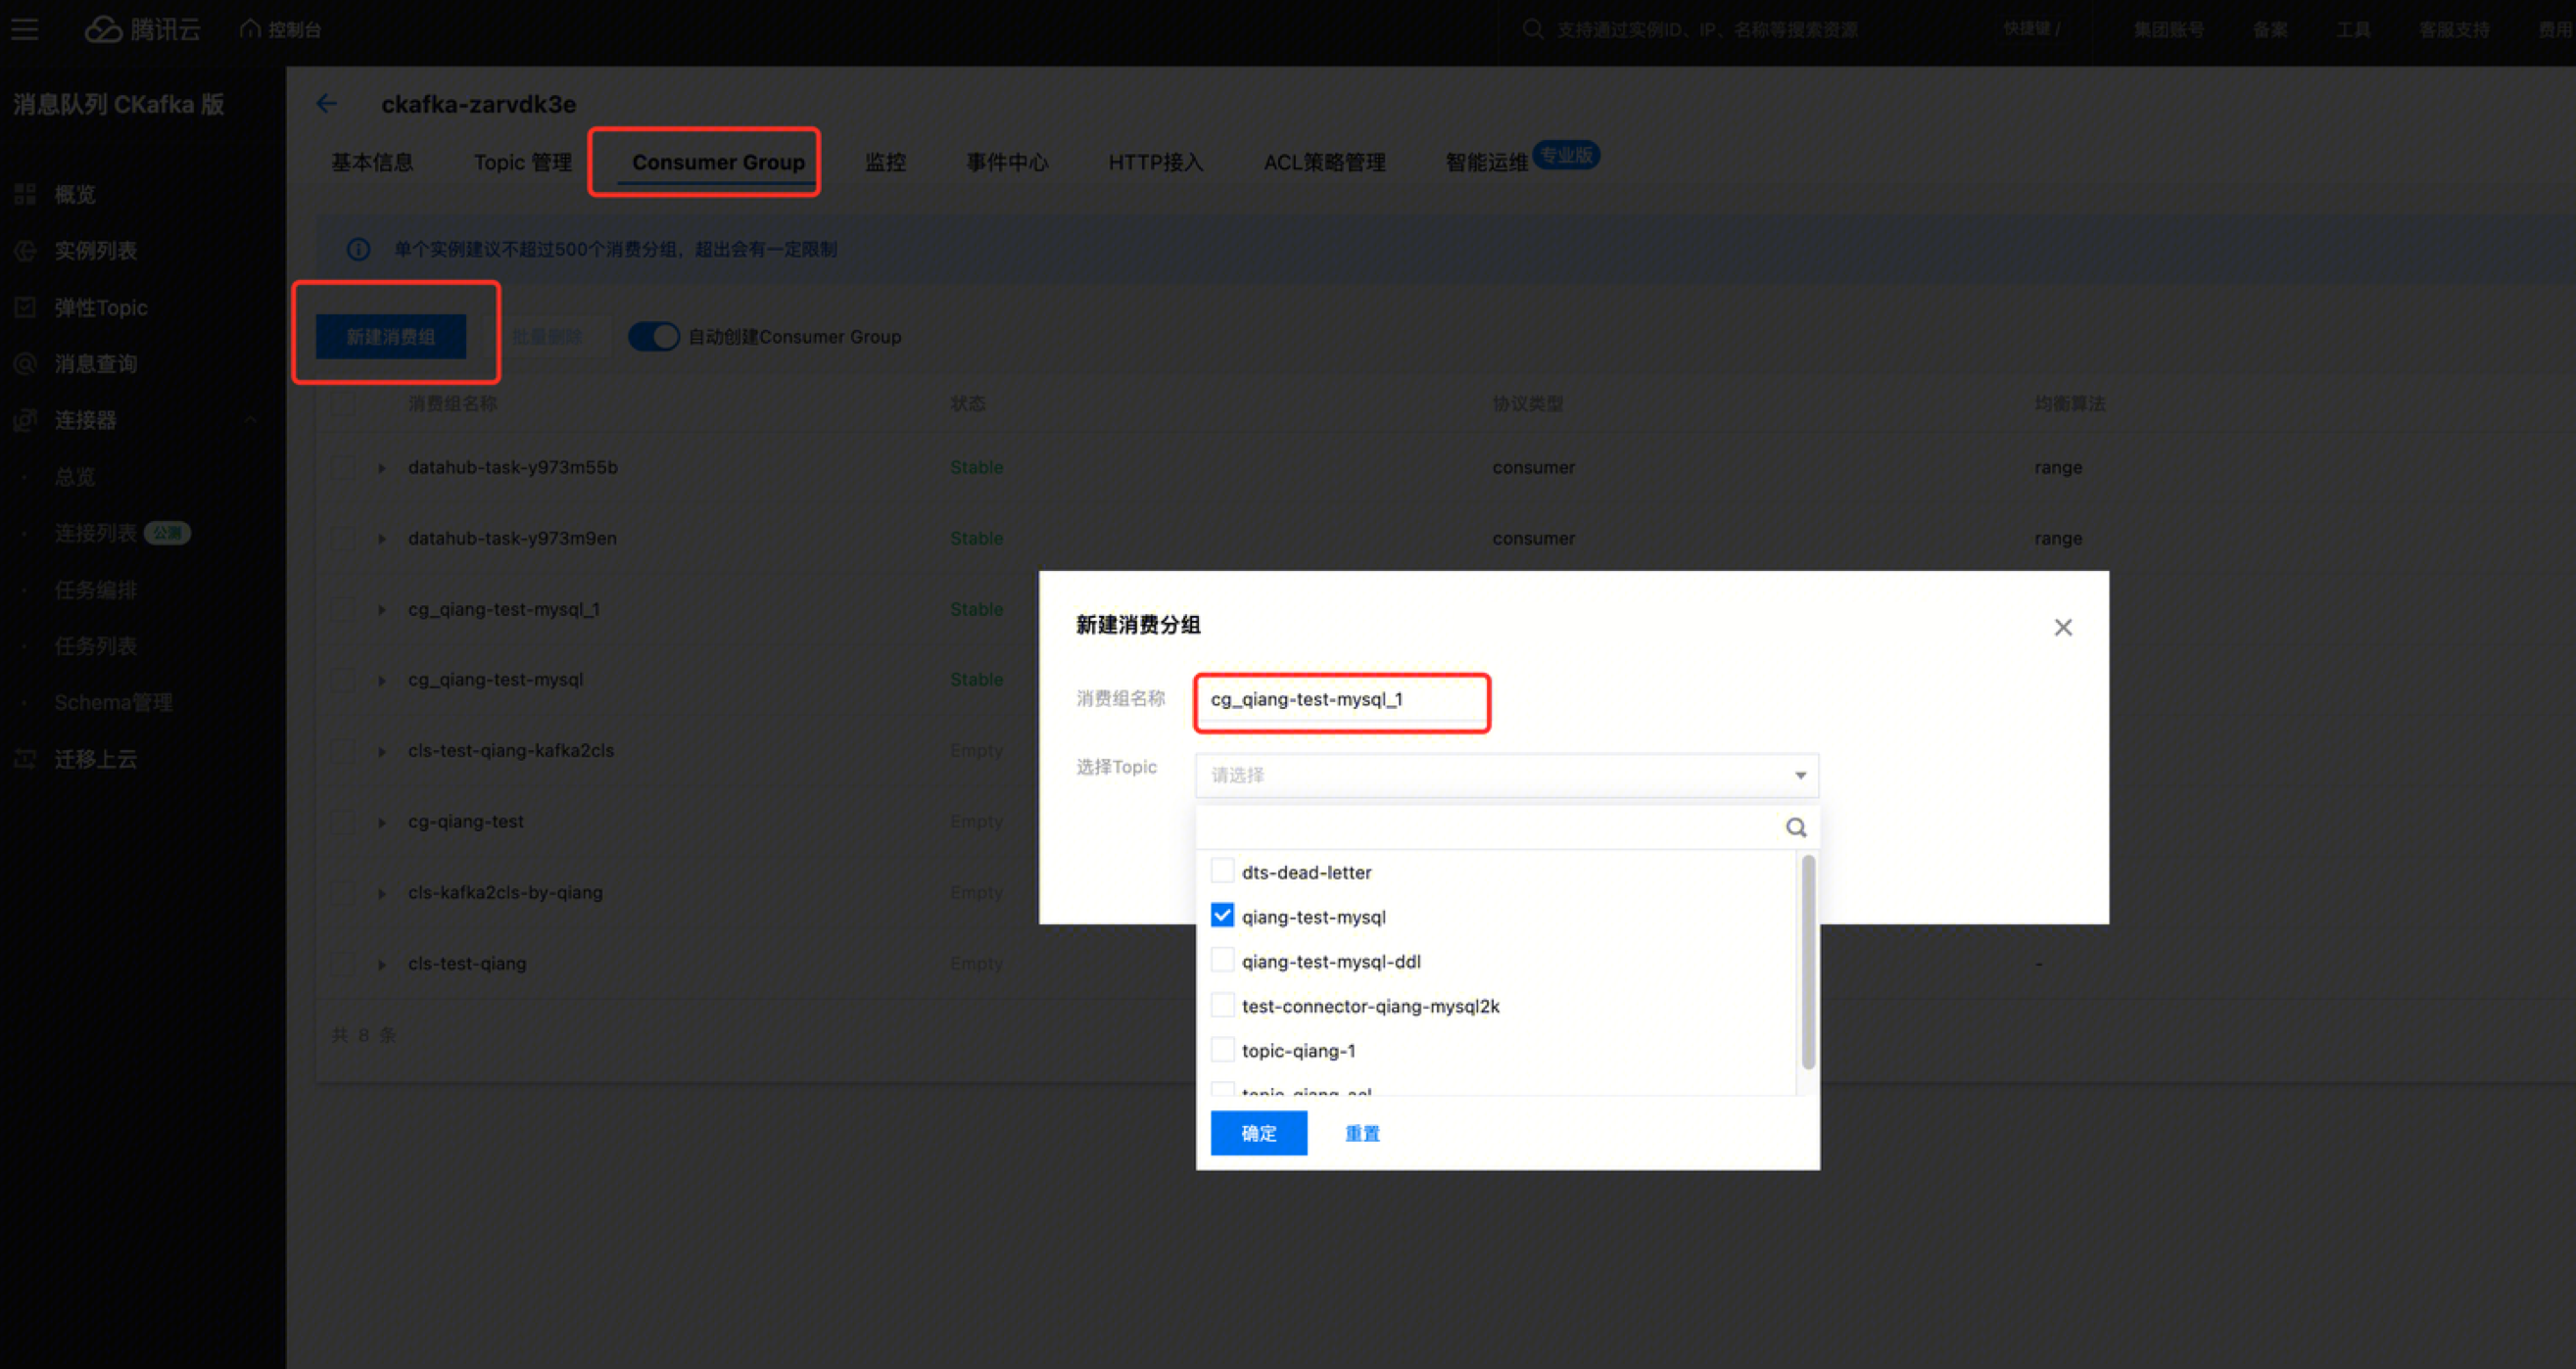
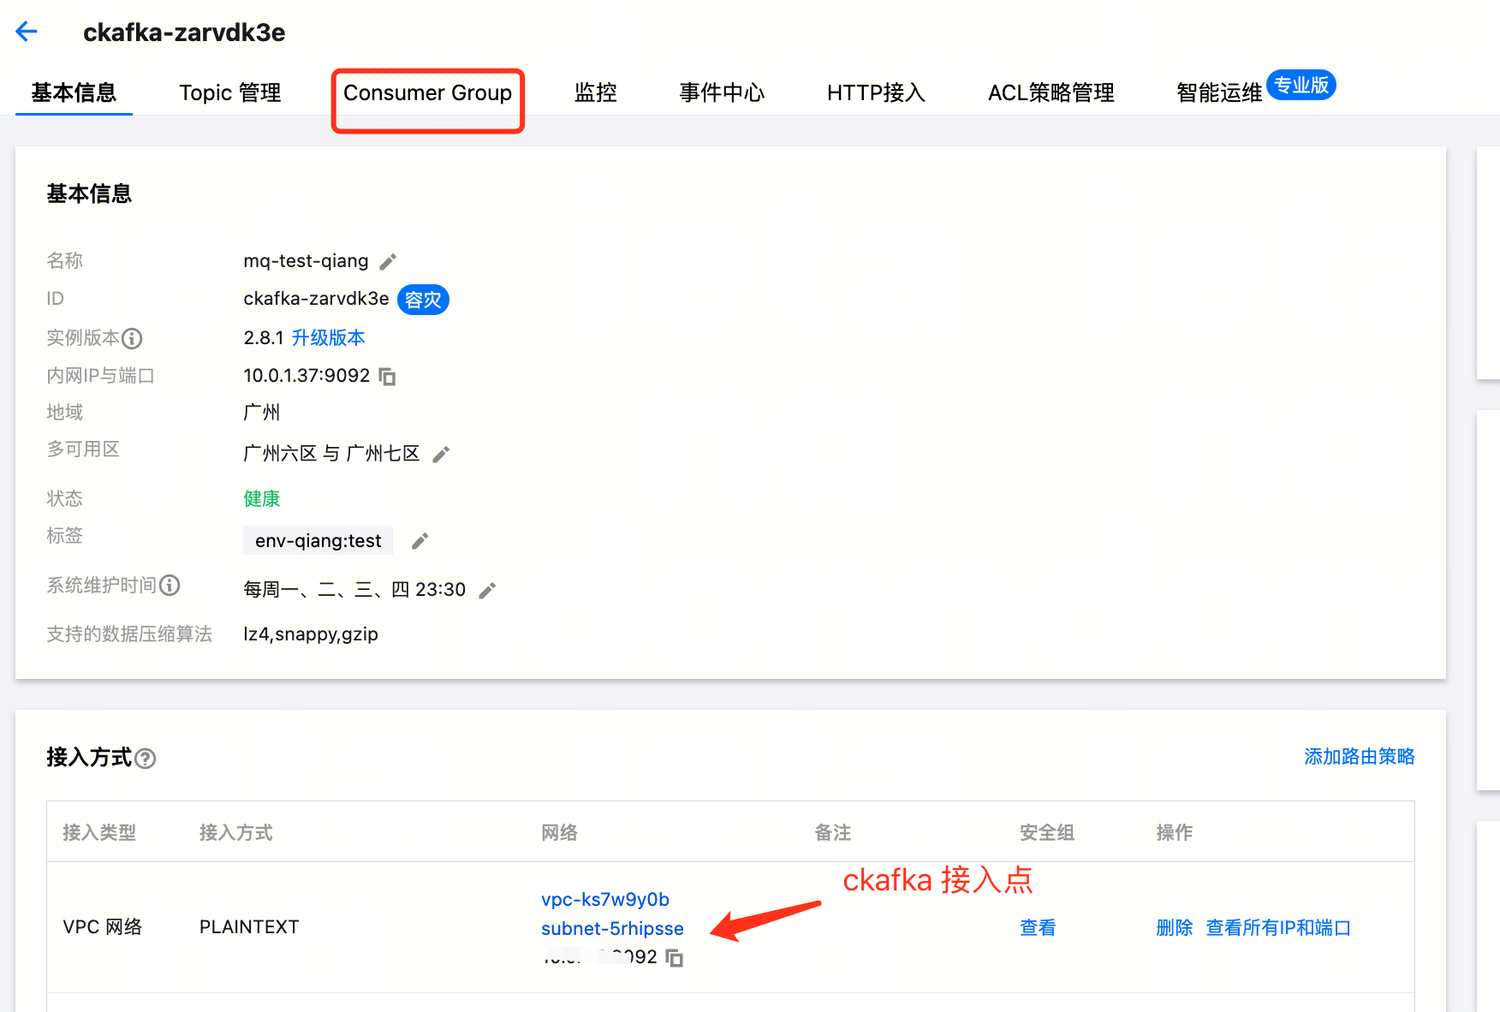
步骤1:确定需要导入的 Kafka topic 和消费组名称、CKafka 的 server 地址 vip,在 CKafka 平台创建消费组,默认从最老开始消费。
如果提前不创建消费组,TCHouse-C 平台默认从最老开始消费。
(如下图)在消息队列 CKafka 控制台新建消费组,默认从最新位置开始消费。
步骤2:TCHouse-C 平台 SQL 平台,创建如下表和视图。
-- 0 ckafka 查询导入到 ClickHouse 的 topic 信息-- 1 在 ClickHouse 中创建 Kafka 引擎表CREATE TABLE kafka_table_qiang_test_1 ON CLUSTER default_cluster (key String,value String) ENGINE = KafkaSETTINGSkafka_broker_list = '10.0.x.x:9092',kafka_topic_list = 'qiang-test-mysql',kafka_group_name = 'cg_qiang-test-mysql_1',kafka_format = 'JSONEachRow', -- 可以根据你的数据格式选择合适的格式,例如 JSON、Avro、CSVkafka_num_consumers = 1, -- 按需调整kafka_max_block_size = 65536,kafka_skip_broken_messages = 0; --默认是0-- 2 创建目标表用于存储数据--Kafka 引擎表本身只消费数据,不持久化,需要创建一个实际存储数据的表CREATE TABLE real_table_qiang_test_1 ON CLUSTER default_cluster (key String,value String) ENGINE = MergeTree()ORDER BY key;-- 3 创建物化视图(Materialized View)将数据从 Kafka 表导入到实际表中CREATE MATERIALIZED VIEW view_to_real_table_qiang_test_1 ON CLUSTER default_cluster TO real_table_qiang_test_1 ASSELECTkey,valueFROM kafka_table_qiang_test_1;-- 4 当开始往kafka发送数据的时候,查询 ClickHouse 中的数据SELECT * FROM real_table_qiang_test_1;select count(1) from INFORMATION_SCHEMA.real_table_qiang_test_1 limit 5;-- 5 若要暂停物化视图 来停止数据采集DROP VIEW IF EXISTS view_to_real_table_qiang_test_1 ON CLUSTER default_cluster;SELECT name FROM system.tables WHERE name LIKE '%view_to_real_table_qiang_test_1%'; -- 验证删除成功
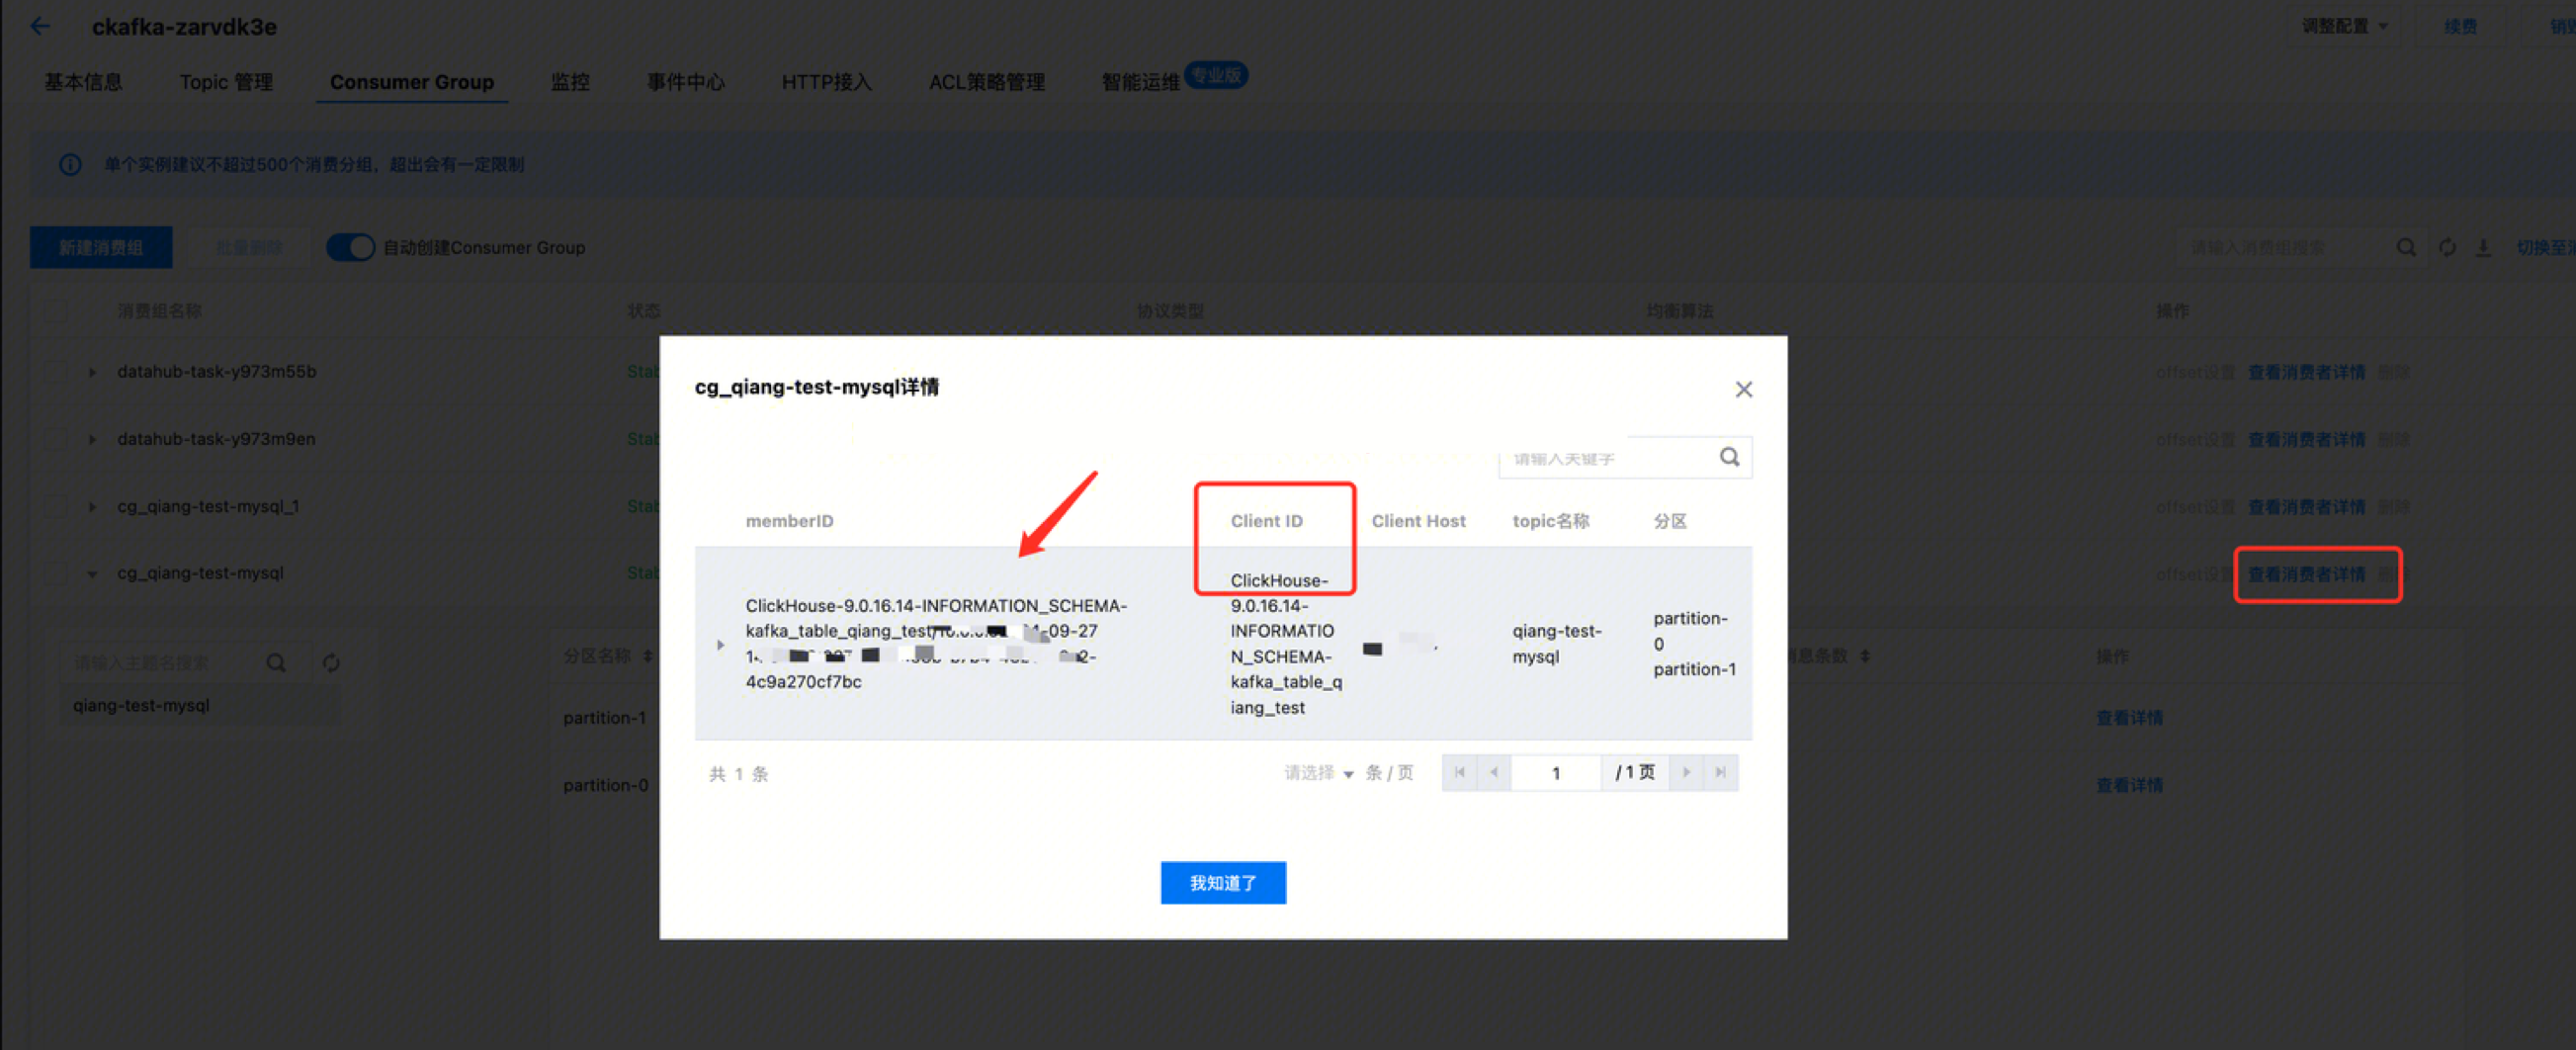
步骤3:检查消费的状态。如下图,查看 ClickHouse 的 client 已经正常链接,再检查消费的监控。
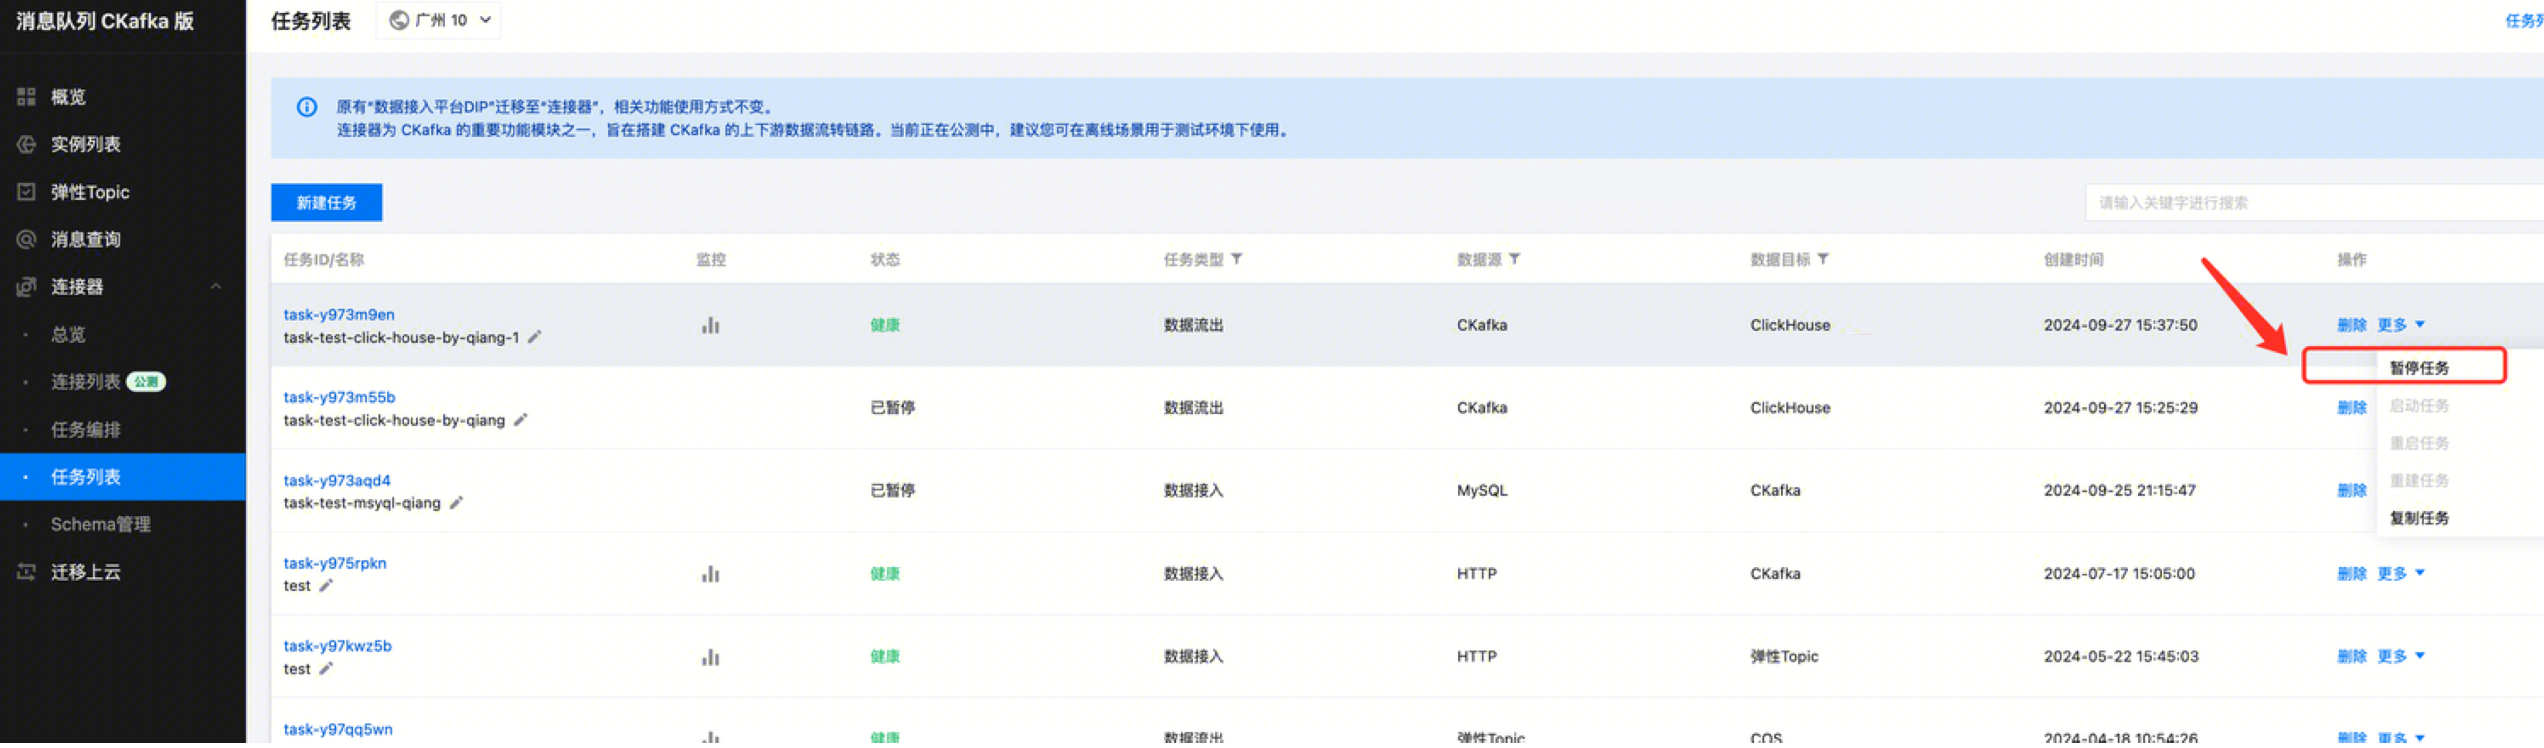
步骤4:在 消息队列 CKafka 版控制台 > 连接器 > 任务列表,找到对应的连接任务,暂停 CKafka 连接器任务。
五、附录
如何查找连接器的消费组
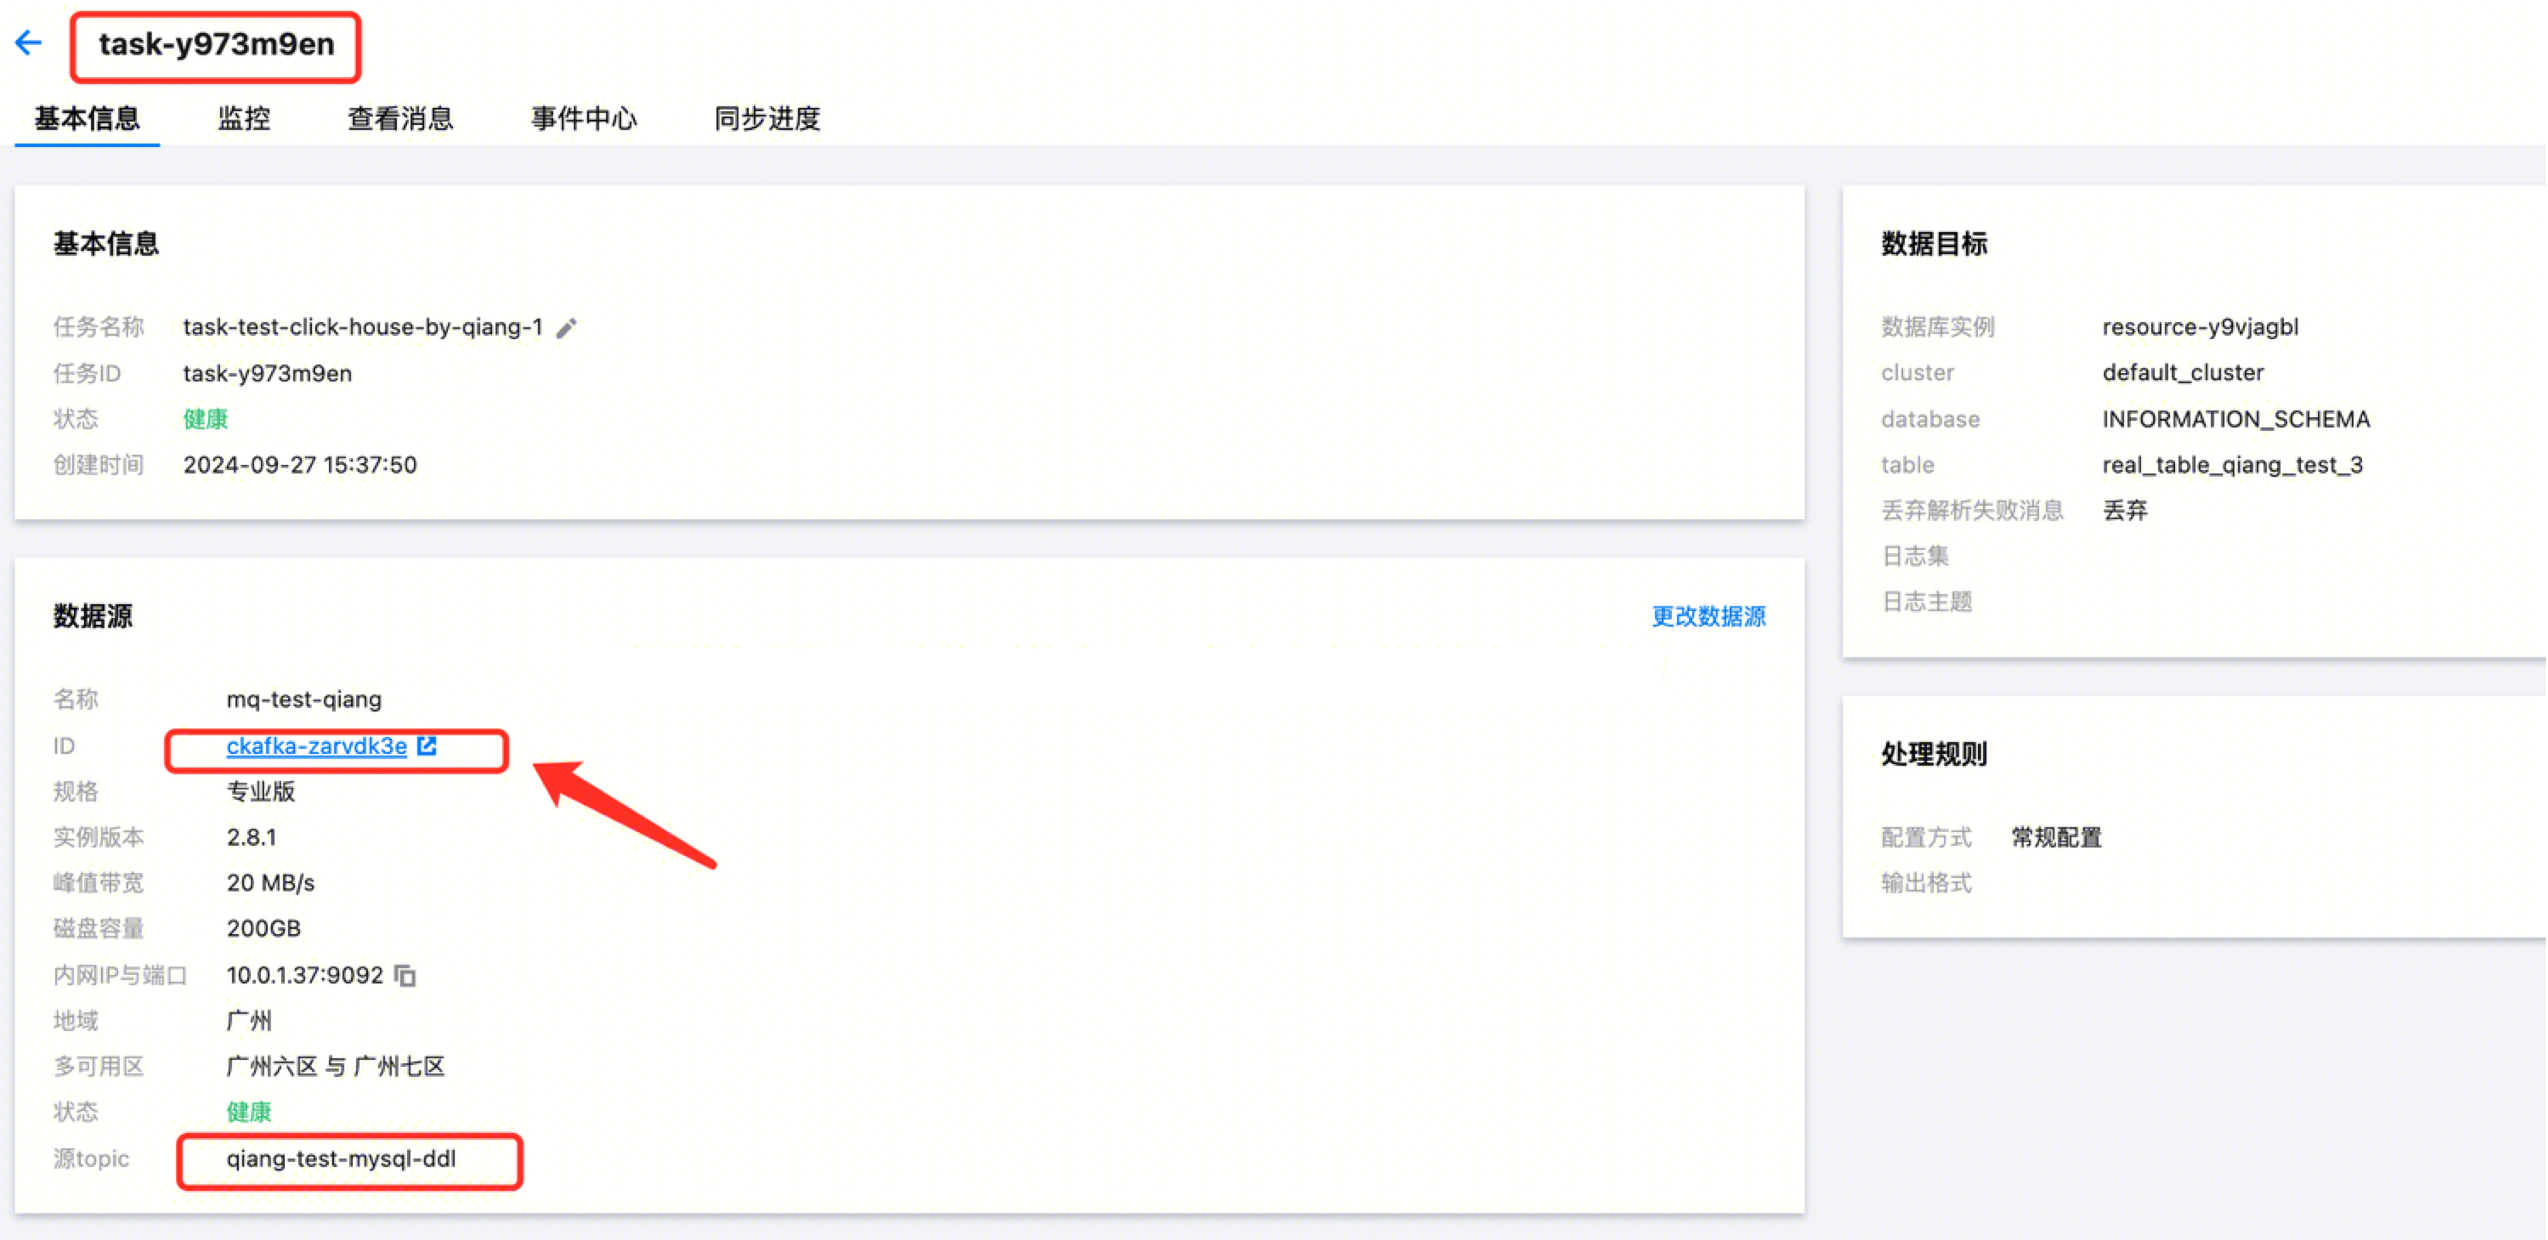
打开连接器任务,获取 CKafka 实例、任务 ID 和 Topic 名称。
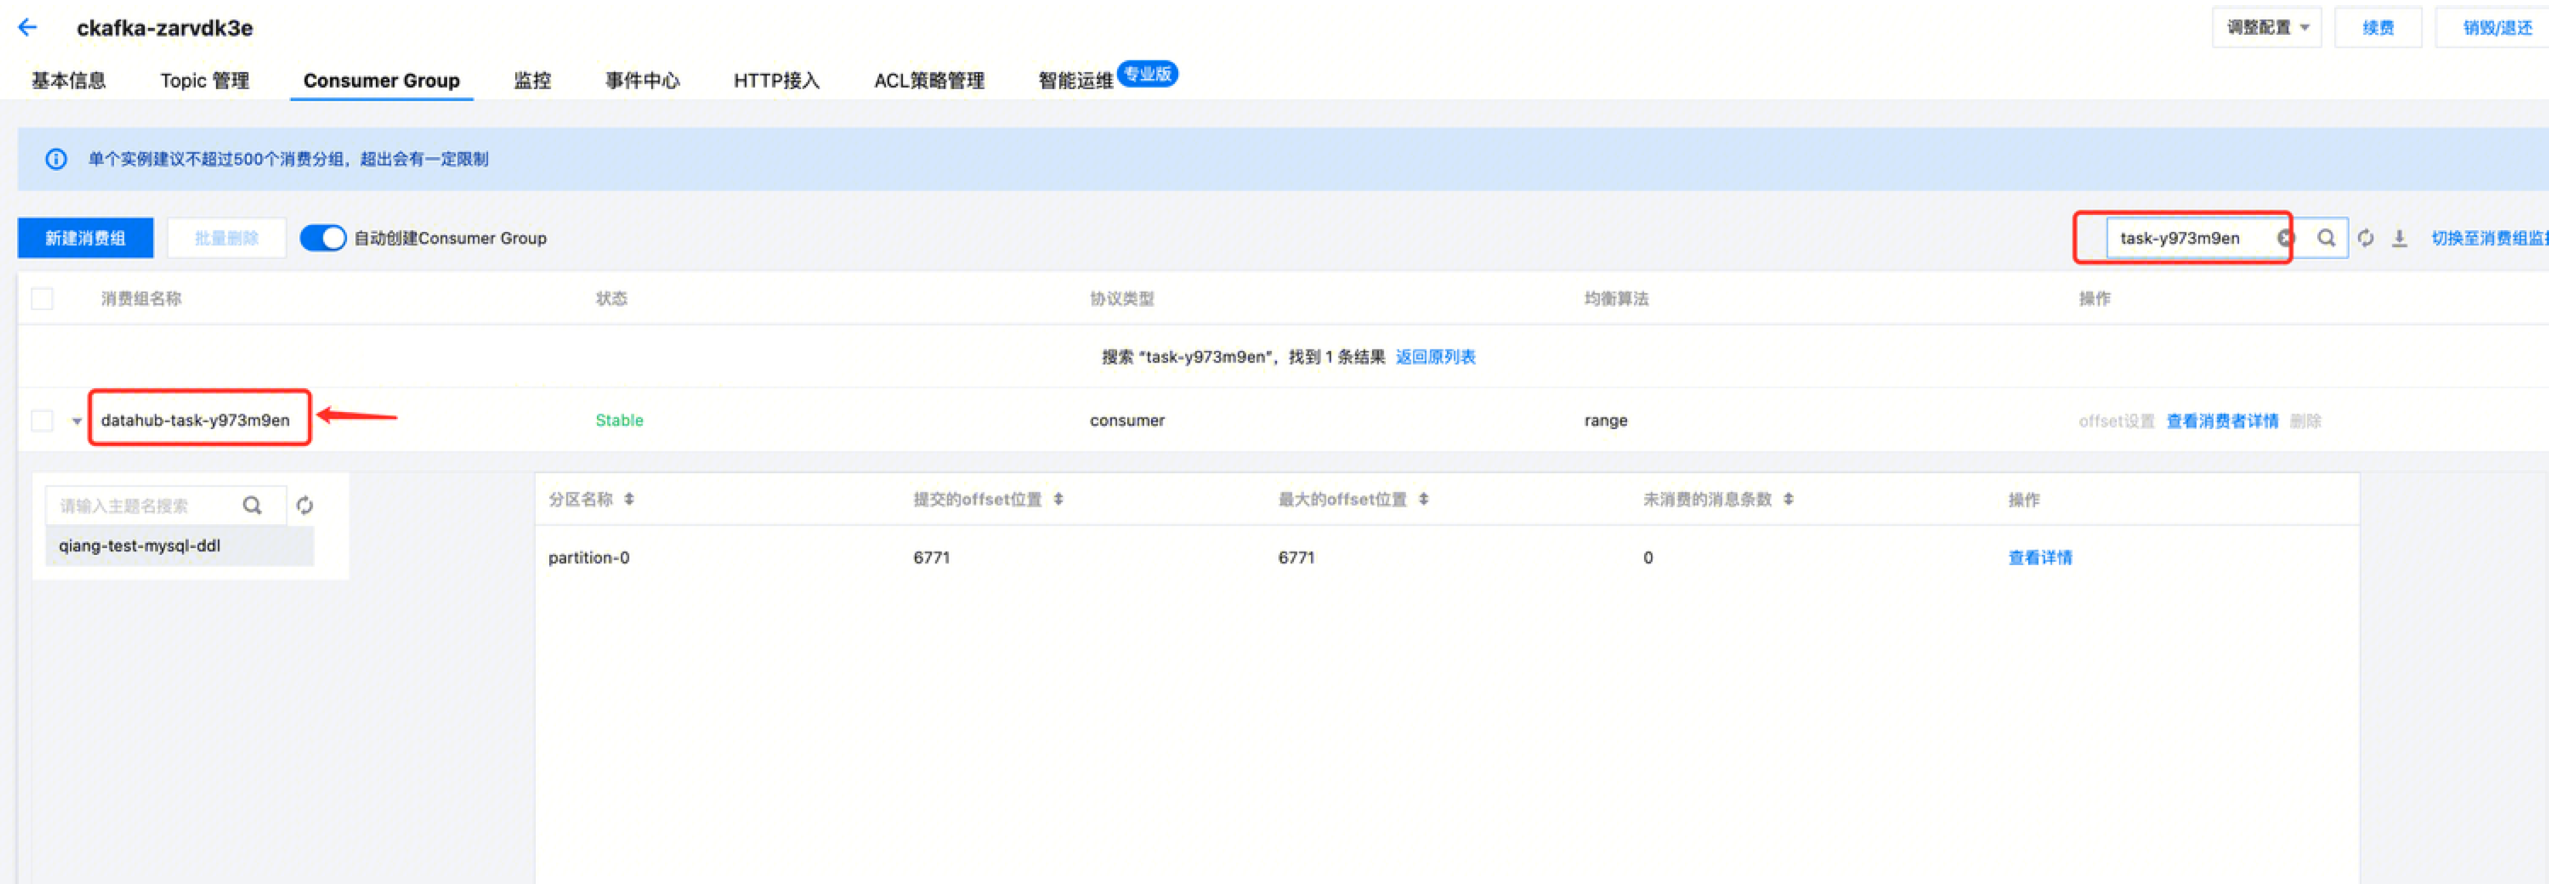
回到消费组(Consumer Group),按照任务 ID 进行搜索,找到对应的消费组名称 。
文档反馈