データ一貫性検証の作成
Download
Focus Mode
Font Size
操作シナリオ
データ一貫性の検証とは、DTSがデータ同期のソースデータベースとターゲットデータベースのテーブルデータを比較し、比較結果と不一致の詳細を提供することで、ユーザーが同期結果を迅速に検証できるようにするものです。データ一貫性の検証タスクは独立して実行され、ソースデータベースの通常の業務に影響を与えず、DTSのタスクにも影響を与えません。
説明:
一貫性の検証は補助的なデータ検証手段にすぎません。そのため、同期結果が要件を満たしていることを確認するために、ユーザー自身でデータ検証を行う必要があります。
独立検証、組み込み検証、GTID検証の違い
一貫性の検証は、独立検証、組み込み検証、GTID検証の3つの検証方式に分かれており、ユーザーは実際のニーズに応じて選択できます。
比較項目 | 内蔵検証 | 独立検証 | GTID検証 |
定義 | 検証サービスはDTSタスクに組み込まれており、タスクの実行中に一貫性の検証を開始する必要があります。DTSタスクの終了後は、検証の開始はサポートされません。 | 検証サービスはDTSタスクから独立しており、ソース側とターゲット側の同じデータブロックを選択して比較します。DTSタスクの終了後は、検証の開始はサポートされません。 | ソース側とターゲット側で実行済みのGTIDに基づいてデータの一貫性を比較します。 |
比較範囲 | DTSタスクで選択された同期オブジェクトのみを比較し、ソースデータベースで選択されていない同期オブジェクトは検証範囲に含まれません。 DTSによってターゲット側に書き込まれたデータのみを比較し、ユーザー自身がターゲット側に書き込んだデータは検証範囲に含まれません。 | DTSタスクで選択されていない他の同期オブジェクトを比較できます。 ユーザーが自らターゲット側に書き込んだデータを比較できます。 | すべての同期オブジェクトを比較します。 |
検証中の要件 | ソース側ではDMLデータの書き込みは可能ですが、DDLデータの書き込みはできません。そうでない場合、検証が不正確になる可能性があります。 | 静的データ状態で検証を開始することをお勧めします。つまり、ソース側とターゲット側の両方でデータ書き込みがない状態です。そうでない場合、検証結果が不正確になる可能性があります。 | ソース側とターゲット側の両方でGTID機能を有効にする必要があります。 |
適用シーン
現在データ一貫性の検証をサポートしている同期リンクは以下の通りです:
MySQL/MariaDB/Percona/TDSQL-C MySQL/TDSQL MySQL > MySQL
MySQL/MariaDB/Percona/TDSQL-C MySQL/TDSQL MySQL > MariaDB
MySQL/MariaDB/Percona/TDSQL-C MySQL/TDSQL MySQL > TDSQL-C MySQL
MySQL/MariaDB/Percona/TDSQL-C MySQL/TDSQL MySQL > TDSQL MySQL
MySQL/MariaDB/Percona/TDSQL-C MySQL/TDSQL MySQL > TDSQL Boundless
注意事項と制約事項
1. データ一貫性の検証タスクはソースデータベースインスタンスの負荷を増加させる可能性があるため、業務への影響が少ない時間帯に操作を行ってください。
2. 比較検証の制約事項:
完全検証、サンプリング検証:主キー/一意キーがないテーブルの場合、行数が5万行未満のときは検証をサポートし、5万行を超えるテーブルは検証をスキップします。
行数検証:主キーまたは一意キーは必須ではありません。
3. 現在の検証タスクはDDL操作を認識しません。同期中にユーザーがソースデータベースに対してDDL操作を行った場合、検証結果に不一致が生じるため、正確な比較結果を得るには、ユーザーが検証タスクを再度開始する必要があります。
4. 一貫性の検証タスクにおいて、DTSがソースまたはターゲット側のデータを1回クエリする際のタイムアウト制限は10分です。1回のクエリとは、各チャンク検証で1回クエリすることや、行検証で1回クエリすることなどを指します。1回のクエリ時間が10分を超えた場合(例えば、ソース側でクエリするテーブルが大きいテーブルの場合)、検証タスクが失敗します。
5. 単方向同期、双方向同期のデータ検証のみをサポートします。多対一、一対多、リング型、スター型同期などの複雑なトポロジー構造のデータ検証はサポートしません。
6. 同期タスク設定で一部のDML、DDLを選択した場合、またはWhere条件フィルタリングを行った場合、ソースとターゲットデータベースのデータに不一致が生じるため、一貫性の検証では組み込み検証はサポートされません。
7. 同期タスクを以下のように設定すると、データ検証の結果が一致しない可能性があります。検証タスクを作成する際には、この点にご注意ください。
データ初期化タイプで「全量データ初期化」が選択されていない場合、ソースとターゲットのデータに不一致が生じる可能性があり、最終的にデータ検証の結果が一致しない原因となります。
PK競合で「競合を無視」を選択した場合、競合が発生するとソースとターゲットのデータに不一致が生じる可能性があり、最終的にデータ検証の結果が一致しない原因となります。
8. 同期一貫性検証機能のリリース前(MySQL/MariaDB/TDSQL-C MySQLは2023年1月12日、TDSQL MySQLからTDSQL MySQLは2023年7月30日、MySQL/MariaDB/PerconaとTDSQL MySQL間のリンクは2023年10月20日)にすでに存在していた既存タスクは、DTSのバージョンが低すぎるため、現時点では検証タスクを直接作成することはサポートされておらず、チケットを提出してバージョンをアップグレードした後にのみ作成できます。
9. TDSQL MySQL関連のリンクでデータ一貫性の検証を行う際には、以下の内容にも注意する必要があります:
9.1 ソース側またはターゲット側が分散TDSQL MySQLの場合、業務の低ピーク時にデータ一貫性の検証を行ってください。そうしないと、検証結果に不一致が生じる可能性があります。
9.2 仮想列を含むテーブルの検証はサポートされていません。このようなテーブルに遭遇した場合、検証タスクでエラーが発生する可能性があります。
10. 組み込み検証の注意事項。
10.1 組み込み検証の範囲は、ソースデータベースで選択されたテーブルオブジェクトと、ターゲットデータベースに同期されたテーブルオブジェクトのみを比較します。ユーザーが同期タスクの進行中にターゲットデータベースへデータを書き込んだ場合、そのデータは検証範囲に含まれず、その他の高度なオブジェクト(ストアドプロシージャ、関数など)やビューなども含まれません。同期タスク設定で「構造初期化」が選択されていない場合(テーブル構造を同期しないことを意味します)、一貫性の検証時にテーブル構造も検証されません。
10.2 組み込み検証は同期タスクの実行中に開始する必要があります。組み込み検証タスクがまだ終了していないときに、ユーザーが同期タスクを終了すると、組み込み検証タスクは失敗します。
10.3 組み込み検証では、ソースデータベースに新しいデータベース
__tencentdb__を作成し、そのデータベースにCheckSumテーブルを書き込む必要があるため、ソースデータベースが読み取り専用の場合は一貫性の検証がスキップされます。11. 独立検証の制約事項。
データ同期タスクでテーブルに対して列の名前変更、列のフィルタリング、テーブルの名前変更操作をすでに行っている場合、後で独立検証を作成する際に、以下の操作上の制限があります。
11.1 同期リンクで列の名前変更と列のフィルタリングが設定されている場合:独立検証を行う際に、検証対象で「すべてのオブジェクト」を選択すると、列の名前変更と列のフィルタリングが行われたテーブルを検証できます。
11.2 同期リンクで列の名前変更と列のフィルタリングが設定されている場合:独立検証を行う際に、検証対象で「カスタムオブジェクト」を選択すると、検証対象で選択した列は同期オブジェクトのフィルタリング後の列のサブセットである必要があります。そうしないと、列の名前変更と列のフィルタリングが行われたテーブルは検証がスキップされます。
11.3 同期リンクでテーブルの名前変更が設定されている場合:独立検証を行う際に、検証対象で「カスタムオブジェクト」を選択した場合、検証対象を選択するときにテーブルオブジェクトを順番にチェックする必要があります。データベース全体をチェックすることはできません。そうしないと、以前に名前が変更されたテーブルは検証がスキップされます。
実装原理
組み込み検証
DTSによるMySQL系データベースの一貫性の検証は、rowモード(binlog_format = row)に基づいています。rowモードは、masterとslaveの正確なレプリケーションを実現し、データの安全性を確保できます。
実現原理は以下の通りです:
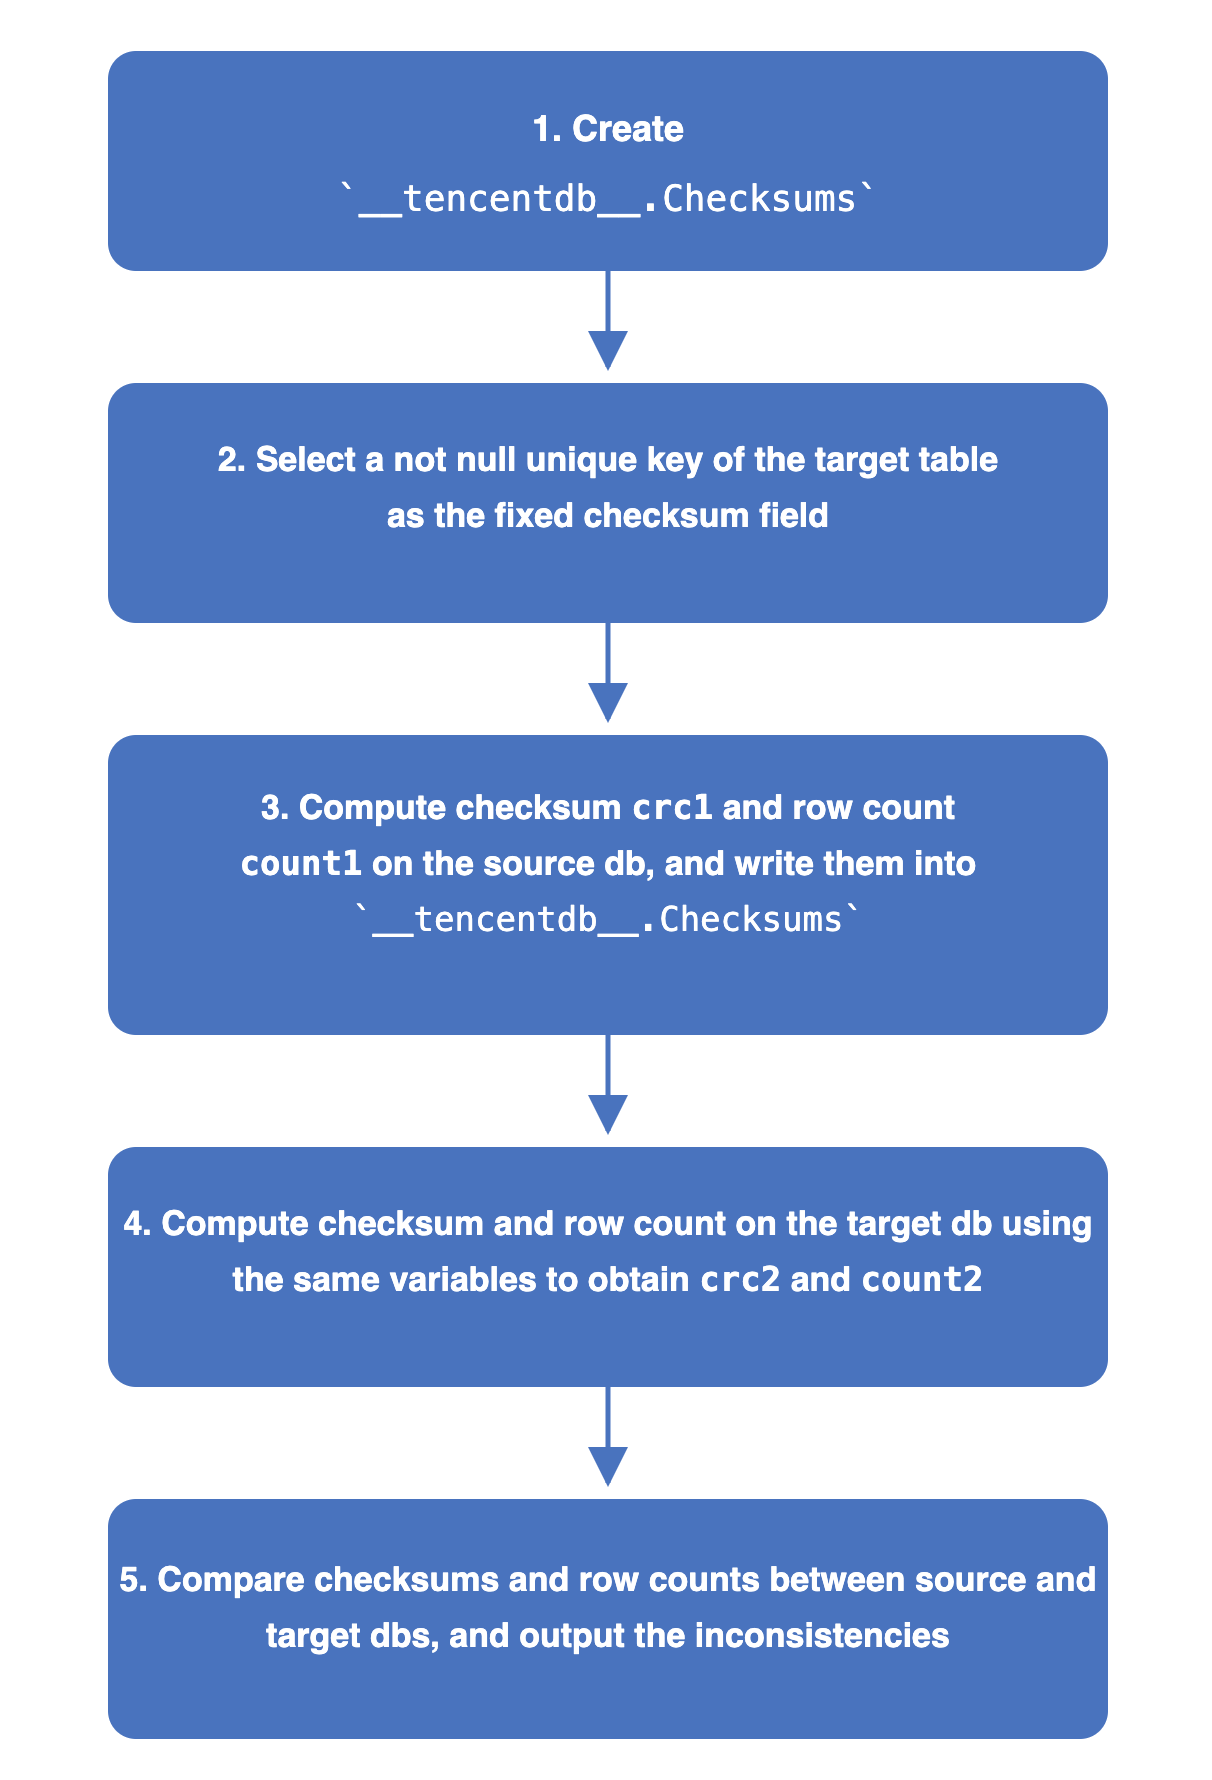
1. ソースデータベースに検証データベース
__tencentdb__.Checksumsを作成し、同期タスクの進行中にデータ比較情報を保存するために使用します。2. 検証対象テーブルの非NULL一意キーを検証固定フィールドとして選択します。
3. ソースデータベースの検証値crc1と行数count1を計算し、ソースデータベースの
__tencentdb__.Checksumsに書き込みます。crcの計算方法はチャンク検証に似ています。検証固定フィールドに基づいて、固定範囲を選択します(例えば、テーブルAからPKが1~1000のデータを選択します)。これらのデータを行ごとに連結してcrcを計算します。これにより、各チャンクデータからcrcが得られ、同時にソースデータベース全体のデータを計算してcrc1が得られます。
4. DTSはbinlog内のrowモードデータを解析し、ソースデータベースに検証値を書き込むSQLを復元してから、このSQLをターゲットデータベースで再生します。
ターゲットデータベース上でソースデータベースと同じ変数を使用して検証値と行数を計算し、ターゲットデータベースのcrc2とcount2を取得します。
5. ソースとターゲットデータベースの検証値と行数を比較し、比較結果を表示します。
独立検証
独立検証は、DTSデータ同期タスクに依存せず、独立して実行できるデータ比較ツールです。ユーザーが定義した設定ファイルに基づいて、ソース側とターゲット側のデータを同時に並行してクエリすることでデータ比較を行います。異種データベース間でのデータ比較をサポートするために、異なるデータベースのデータを統一されたタイプマッピングルールに従って変換します。また、データ比較の並列度を高め、データ同期の遅延の影響を可能な限り排除するために、各テーブルをスライス処理します。各データシャードは、データ比較における最小のデータクエリおよび処理単位となります。
実現原理は以下の通りです:
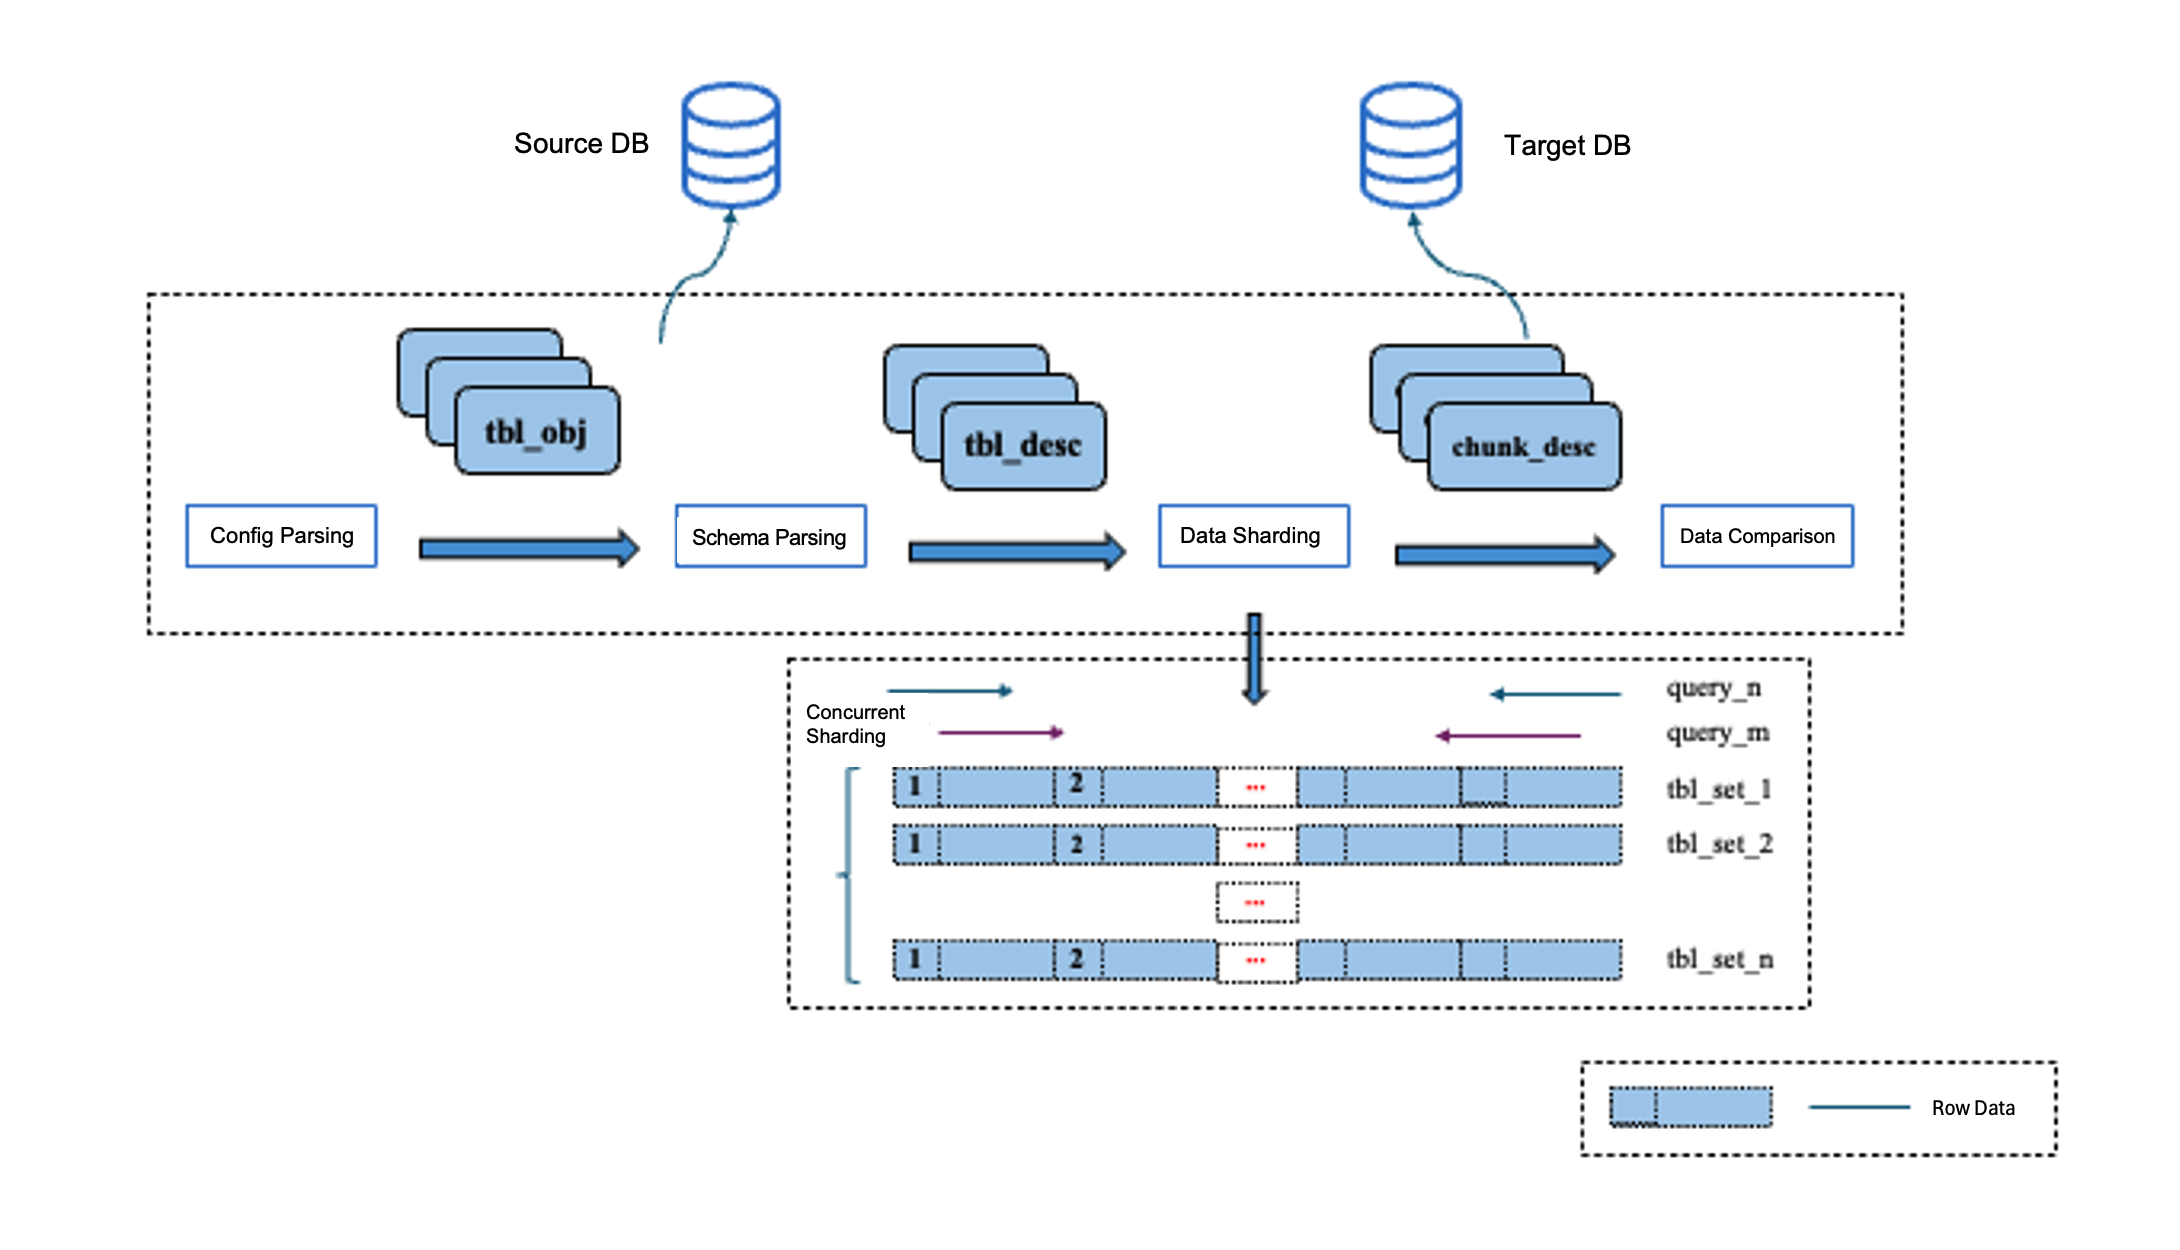
1. 設定解析:主に、今回のデータ比較タスクに関連するデータベーステーブルの識別、名前変更ルールの処理、Where条件の設定などが含まれます。独立検証は、ユーザーがインスタンス全体、データベース全体、カスタムデータベース・テーブルなどのさまざまなオブジェクトを設定してデータ比較を行うことをサポートし、テーブルや列の許可リストと拒否リストの設定をサポートします。また、データベース、テーブル、列名に対するrename変換ルールの設定や、各テーブルに対するWhereフィルタ条件の設定などもサポートします。さまざまな設定を通じて、ユーザーは自身のニーズに応じて適切なオブジェクトを選択し、データ比較を行うことができます。
2. テーブル構造解析:主に列名と列タイプの解析、文字セットと照合順序のクエリ、PKと非NULL一意キーのクエリなどのステップが含まれます。PKがなく、非NULL一意キーもないテーブルの場合、行数が5w行以下のとき、独立検証はデータ値に対してCRC計算を行うことでテーブルデータの一貫性を比較します。データの一意な識別子を見つけられないため、これらのテーブルでは正確な不一致行データを出力できず、訂正SQLも出力できません。行数が5w行を超える場合は、これらのテーブルのデータ比較をスキップします。列タイプ解析は異種環境において非常に重要です。統一されたタイプマッピングルールに基づいて、異なるデータソース間のデータを同じメモリデータタイプに変換します。列タイプ解析はこの重要なステップの基礎となります。
3. データスライス:データクエリとデータ比較の並列度を高めるために、独立検証はテーブルデータをスライス処理します。各データシャードは、データクエリとデータ比較を行う最小単位でもあります。
MySQLタイプのデータベースに対して、独立検証はPK順序分割に基づくスライスポリシーを採用しています。これは、MySQLがB+ツリーというデータ構造でデータを編成しており、PKに基づく範囲クエリがより高い効率を実現し、最小限のI/O消費を実現できるためです。独立検証が使用する典型的なデータスライスアルゴリズムは以下の通りです:テーブルのPKの最小値、最大値、およびPK順序に基づいて、そのテーブルのすべてのPK値を走査し、毎回固定のchunkSizeでスライスの上下境界値(つまりPK値)をクエリし、これによって1つのデータスライスの範囲を決定します。独立検証はまた、スライスプロセス全体を最適化するために多段階並列戦略を採用しています。まず、シャードまたはパーティションが存在するデータテーブルの場合、そのデータはシャードとパーティションに基づいて複数のデータセグメントに分割され、スライスの並列度を高めます。次に、1つのデータセグメント内部でも、双方向から近づく戦略を採用し、先頭と末尾の両端から並行してデータスライスを行います。
4. データ比較:主にデータクエリ、データタイプ変換、データ一貫性比較が含まれます。データタイプ変換はこの段階の重要なステップです。異種データベースには列タイプのさまざまな差異が存在するため、異種データベースのデータ比較を行う前に、事前に定義されたタイプマッピングルールに基づいて、異なるデータベースの列タイプを標準のメモリデータタイプに変換します。同時に、このプロセスでは異種データベース間の文字セットエンコーディングの差異、時間タイプおよび範囲の差異、浮動小数点精度の差異なども処理し、これらのデータ比較の正確性を確保します。独立検証はPKまたは一意キー識別子に基づいて、各行のデータが一致しているかどうかを比較します。一致しないデータについては、具体的なデータフィールドのデータ差異とクエリSQLを出力し、ユーザーがデータを迅速に特定できるようにします。同時に、独立検証は不一致データに対して訂正SQLを生成し、ユーザーがデータを修復できるようにします。
GTID検証
GTID(Global Transaction Identifier)は、MySQLでトランザクションを一意に識別するためのメカニズムです。GTID検証を通じて、ソースデータベースとターゲットデータベースのデータが一致しているかどうかを迅速に検出し、比較結果と不一致の詳細を提供することで、ユーザーが同期結果を迅速に検証するのを支援します。GTID検証タスクは独立して実行されるため、ソースデータベースの通常の業務には影響しません。
実現原理は以下の通りです:
1. ソース側とターゲット側のデータベースで実行済みのGTID SETをそれぞれ取得します。
2. ソース側のGTID SETとターゲット側のGTID SETの差集合を計算し、ターゲット側で未実行のトランザクションを識別します。
3. 不一致のGTID範囲を分析し、対応するデータベース・テーブルの変更情報を関連付けます。
4. 不一致のGTID範囲およびそれに関連するデータベース・テーブル変更の詳細を出力します。
データ一貫性検証の作成
自動トリガー
DTS同期タスクを新規作成する際に、データ一貫性の検証タスクを有効にできます。後続のタスクが同期増分ステップに進むと、一貫性の検証タスクが自動的に1回トリガーされます。
一貫性の検証の設定ページで、データ一貫性の検証を有効にするにチェックを入れ、パラメータを設定した後、次へをクリックします。
説明:
設定項目 | パラメータ | 説明 |
検証オプション | 検証内容 | 全量検証:検証タスクの開始時に、ソースデータベースとターゲットデータベース内の全データを比較します。 |
| 検証基準 | 両端:ソース側とターゲット側のデータを検証基準として使用します。 |
検証パラメータの設定 | スレッド数選択 | 設定範囲は1~8です。実際の状況に応じて選択してください。スレッド数を増やすと一貫性の検証速度を向上させることができますが、ソースとターゲットデータベースの負荷も増加します。 |
| 再検査回数 | 再検査回数を設定します。 初回の全量データ検証結果が不一致の場合、バックエンドは全量検証で不一致となったデータに対して検証を開始します。 |
| 再検査間隔 | 再検査の時間間隔を設定します。 |
検証対象オプション | 検証対象 | すべての同期オブジェクト:検証範囲は同期タスクで選択されたすべてのオブジェクトです。 カスタム選択:選択した同期オブジェクトの中から、検証を行うオブジェクトを選択します。 |
手動作成
1. DTSコンソールにログインします。
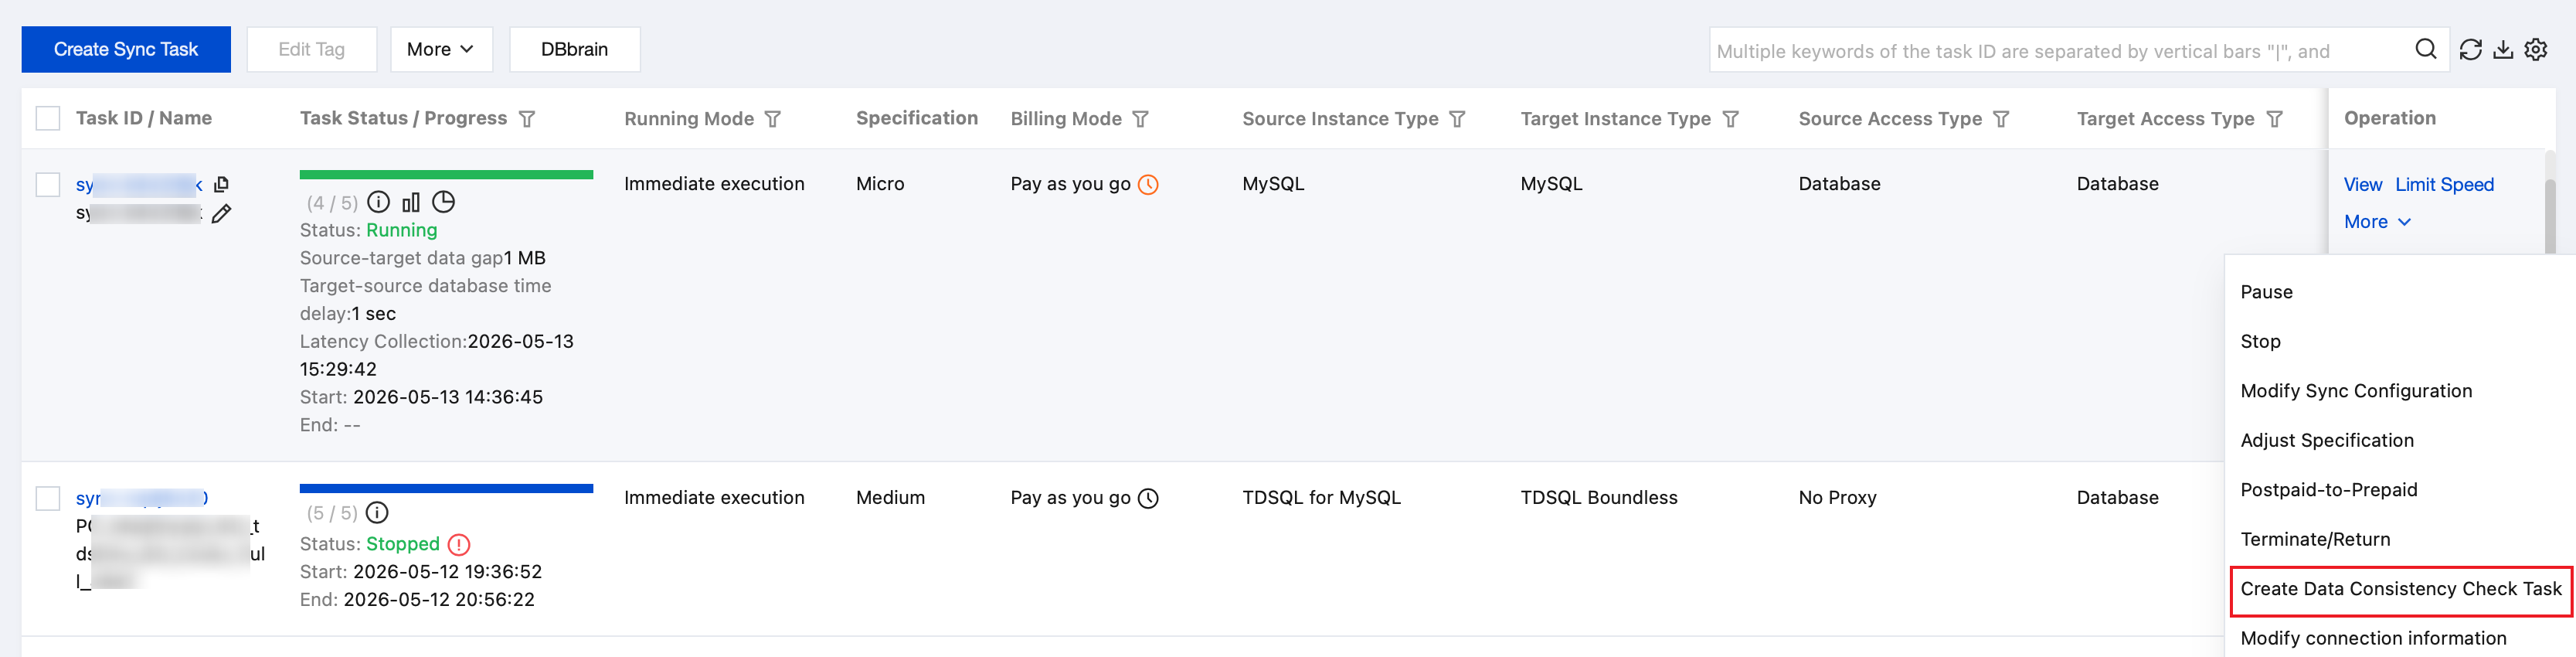
2. データ同期ページで、検証が必要な同期タスクを選択し、操作列でその他 > データ一貫性の検証を作成を選択します。
説明:
一貫性の検証は、「ターゲットとソースデータベースのデータ差異」が100MB未満の場合にのみ作成できます。画面のボタンがグレー表示の場合、同期タスクの状態が条件を満たしていません。例えば、タスク設定で一部のDMLまたはDDLが選択されている、Where条件フィルタリングが設定されている、タスクが失敗している、ソースとターゲットのデータ差異が100MBを超えている、同期トポロジー構造が複雑なトポロジーであるなどです。
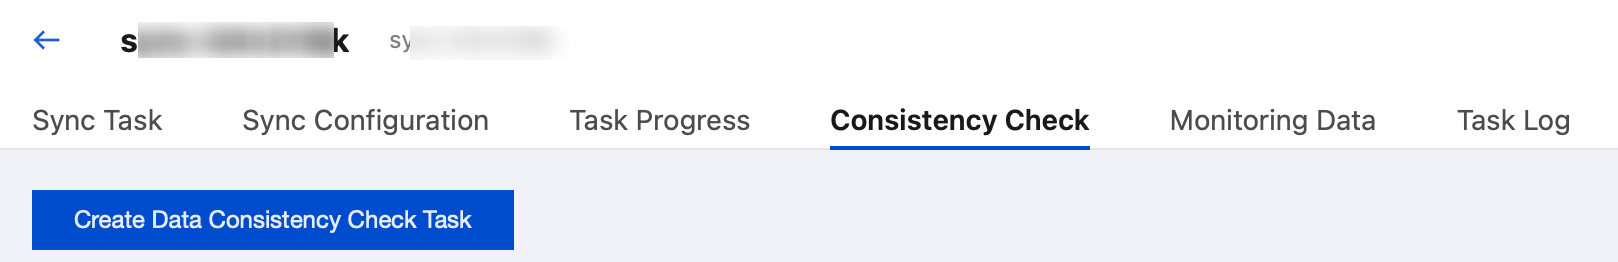
3. データ一貫性の検証ページで、データ一貫性の検証を作成をクリックします。
説明:
既に一貫性の検証タスクが存在する場合、操作列の類似タスクを作成をクリックでき、関連パラメータの設定もサポートされます。
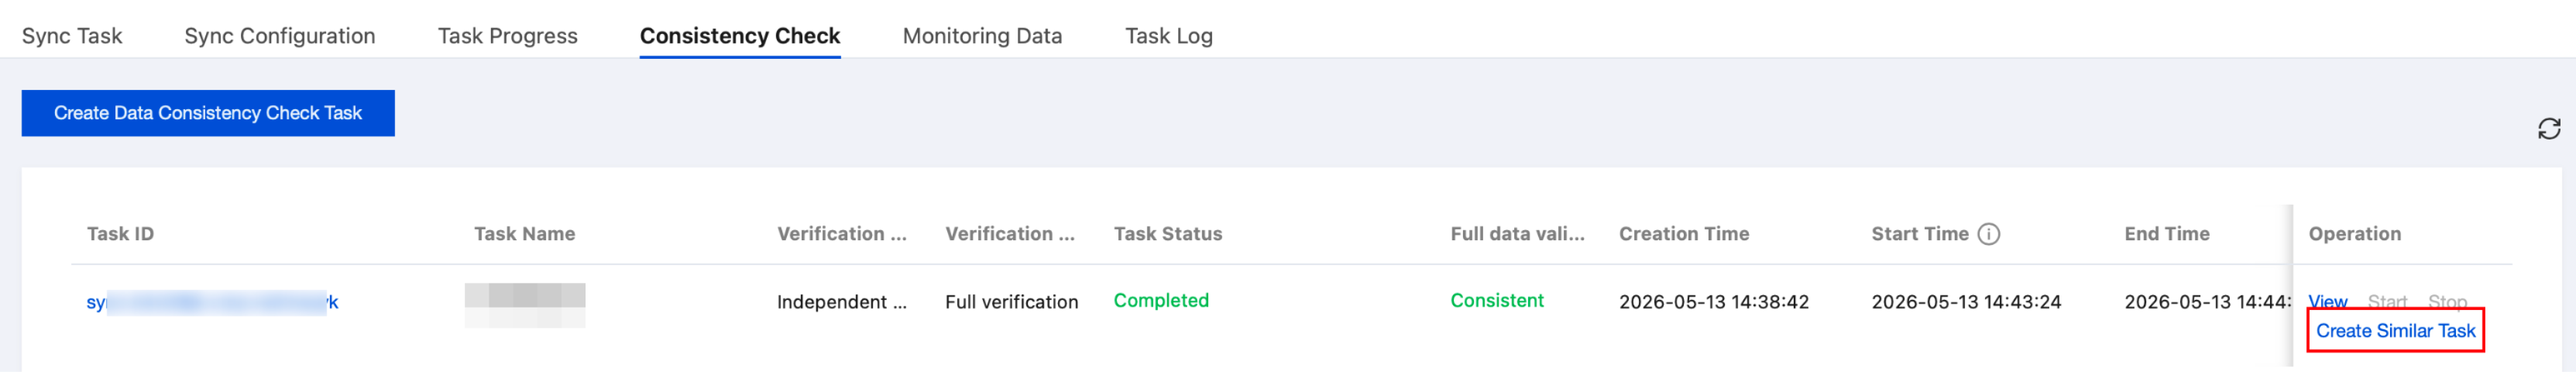
4. ポップアップダイアログで、データ一貫性の検証パラメータを設定した後、一貫性の検証を作成して開始をクリックします。
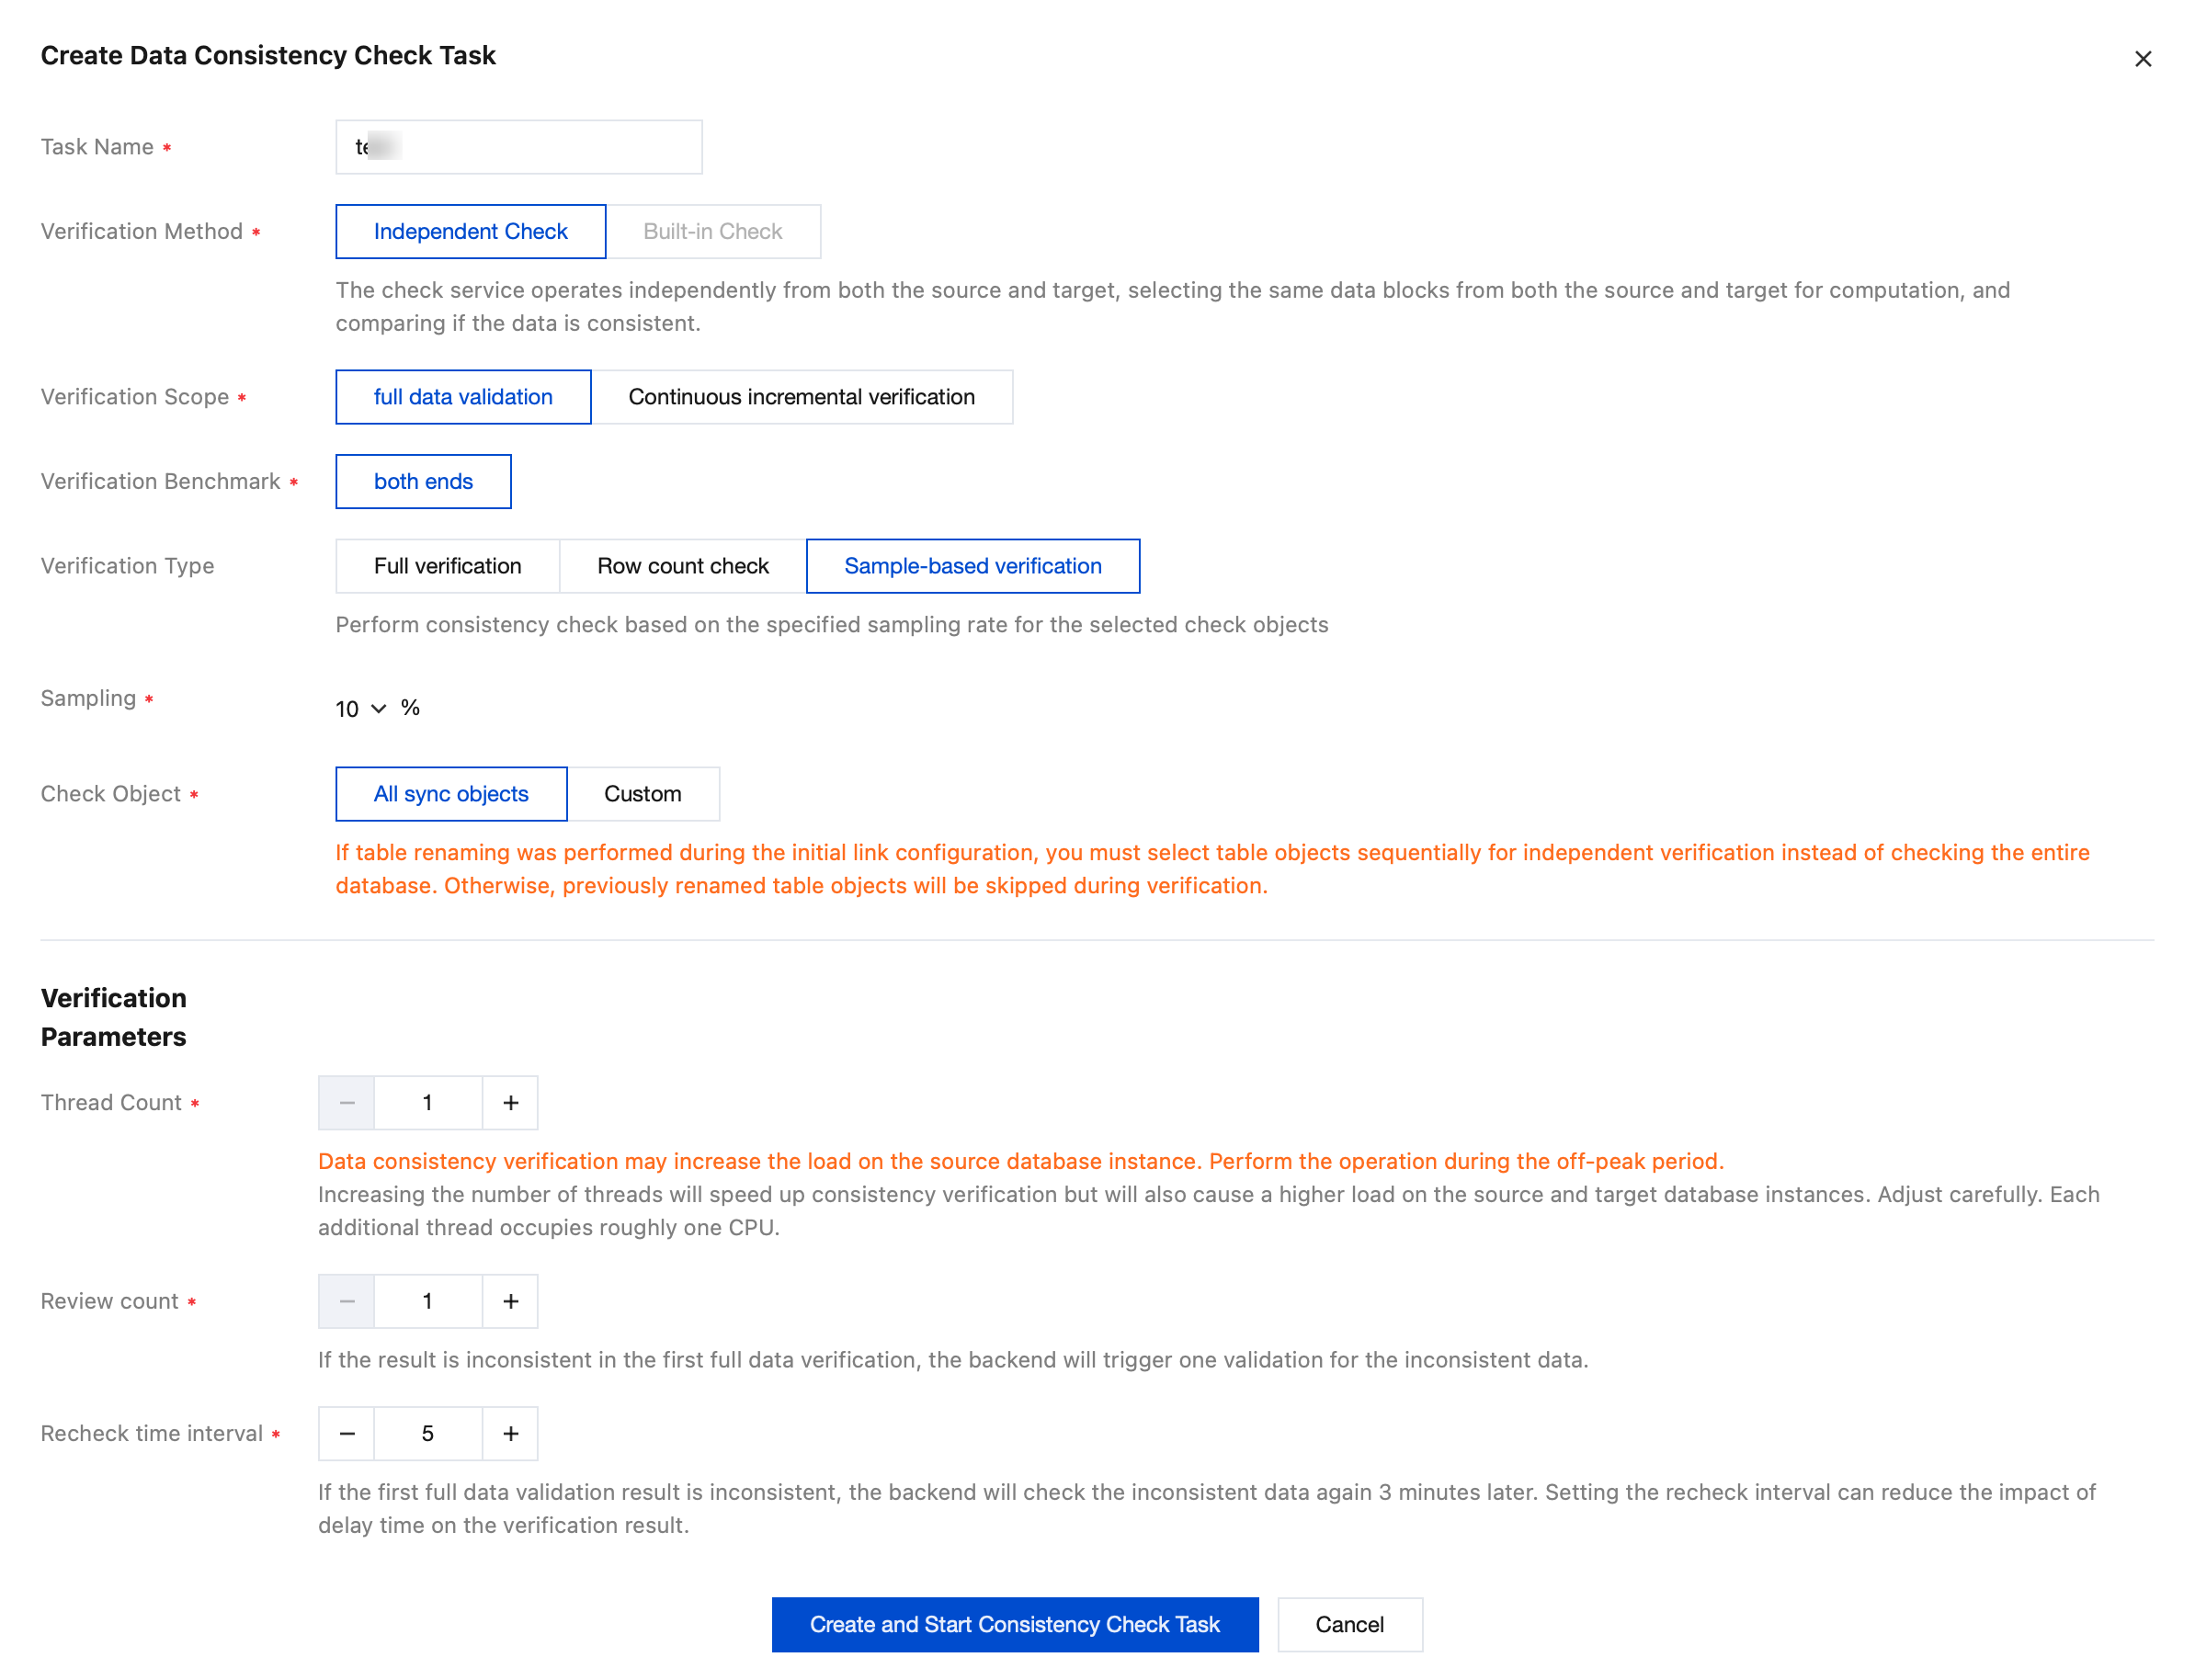
パラメータ | 説明 |
タスク名 | 一貫性検証タスクを作成するための名前です。 |
検証方式 | 独立検証:検証サービスはDTSタスクから独立しており、ソース側とターゲット側の同じデータブロックを選択して比較します。DTSタスクの実行が停止した後は、検証の開始はサポートされません。 内置検証:検証サービスはDTSタスクに内蔵されており、タスクの実行中に一貫性の検証を開始する必要があります。DTSタスクの実行が停止した後は、検証の開始はサポートされません。 GTID検証:ソース側とターゲット側で実行されたGTIDに基づいてデータの一貫性を比較します。各同期タスクには1つのGTID検証タスクのみ関連付けることができます。 |
検証内容 | 全量検証:検証タスクの開始時に、ソースデータベースとターゲットデータベース内の全データを比較します。 |
検証基準 | 両端:ソース側とターゲット側のデータを検証基準として使用します。 |
検証タイプ | 完全検証:選択した検証オブジェクトの完全なデータを検証します。 サンプリング検証:選択した検証オブジェクトから一定の割合を抽出して検証します。 行数検証:選択した検証オブジェクトに対して、データ行数のみを比較します。 |
サンプリング比率 | サンプリング比率を設定します。サンプリング比率は10%、20%、30%……90%をサポートしています。 説明: 検証タイプがサンプリング検証の場合のみ、このパラメータを設定する必要があります。 |
検証対象 | すべての同期オブジェクト:検証範囲は同期タスクで選択されたすべてのオブジェクトです。 カスタム選択:選択した同期オブジェクトの中から、検証を行うオブジェクトを選択します。 |
スレッド数選択 | 設定範囲は1~8です。実際の状況に応じて選択してください。スレッド数を増やすと一貫性の検証速度を向上させることができますが、ソースとターゲットデータベースの負荷も増加します。 |
再検査回数 | 再検査回数を設定します。 初回の全量データ検証結果が不一致の場合、バックエンドは全量検証で不一致となったデータに対して検証を開始します。 |
再検査間隔 | 再検査の時間間隔を設定します。 |
データ一貫性検証結果の確認
1. データ同期ページで、確認する同期タスクを選択し、操作列でその他 > データ一貫性の検証を作成を選択します。
2. 操作列で表示をクリックすると、検証結果を確認できます。
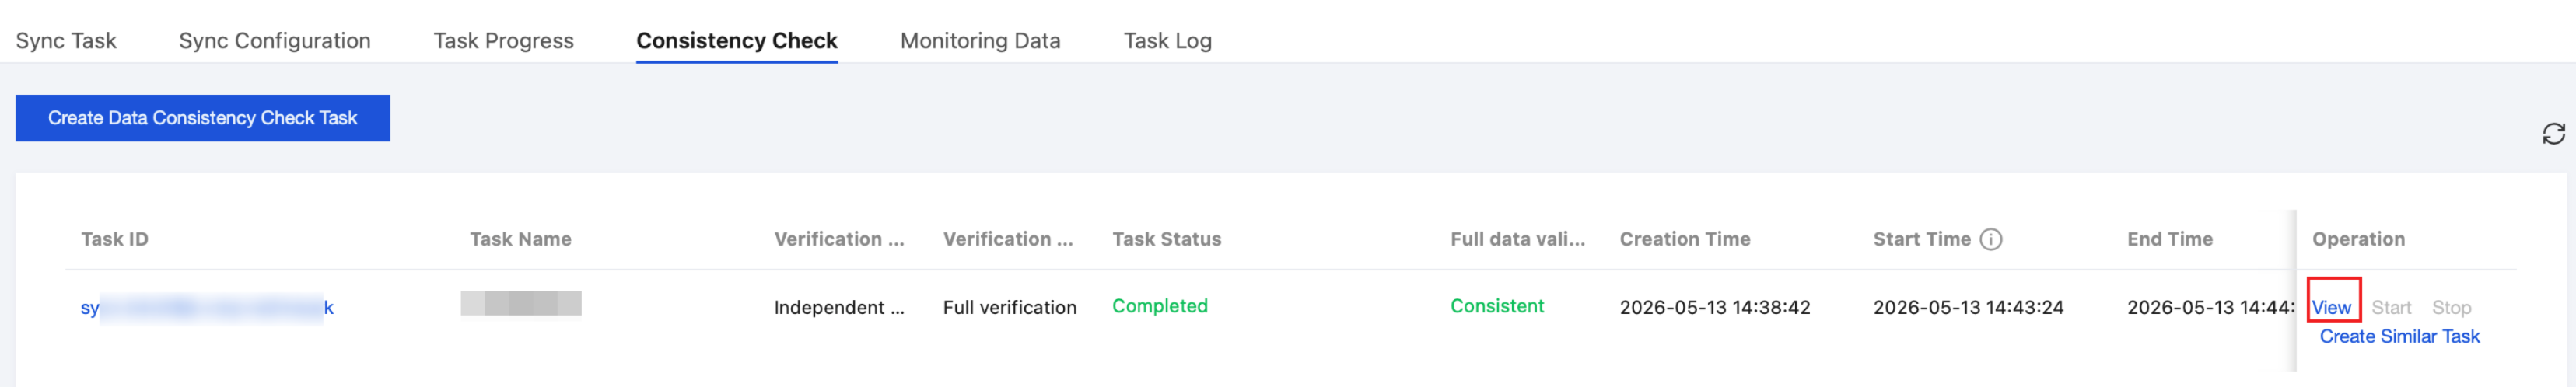
3. 検証結果を確認します。
独立検証、組み込み検証
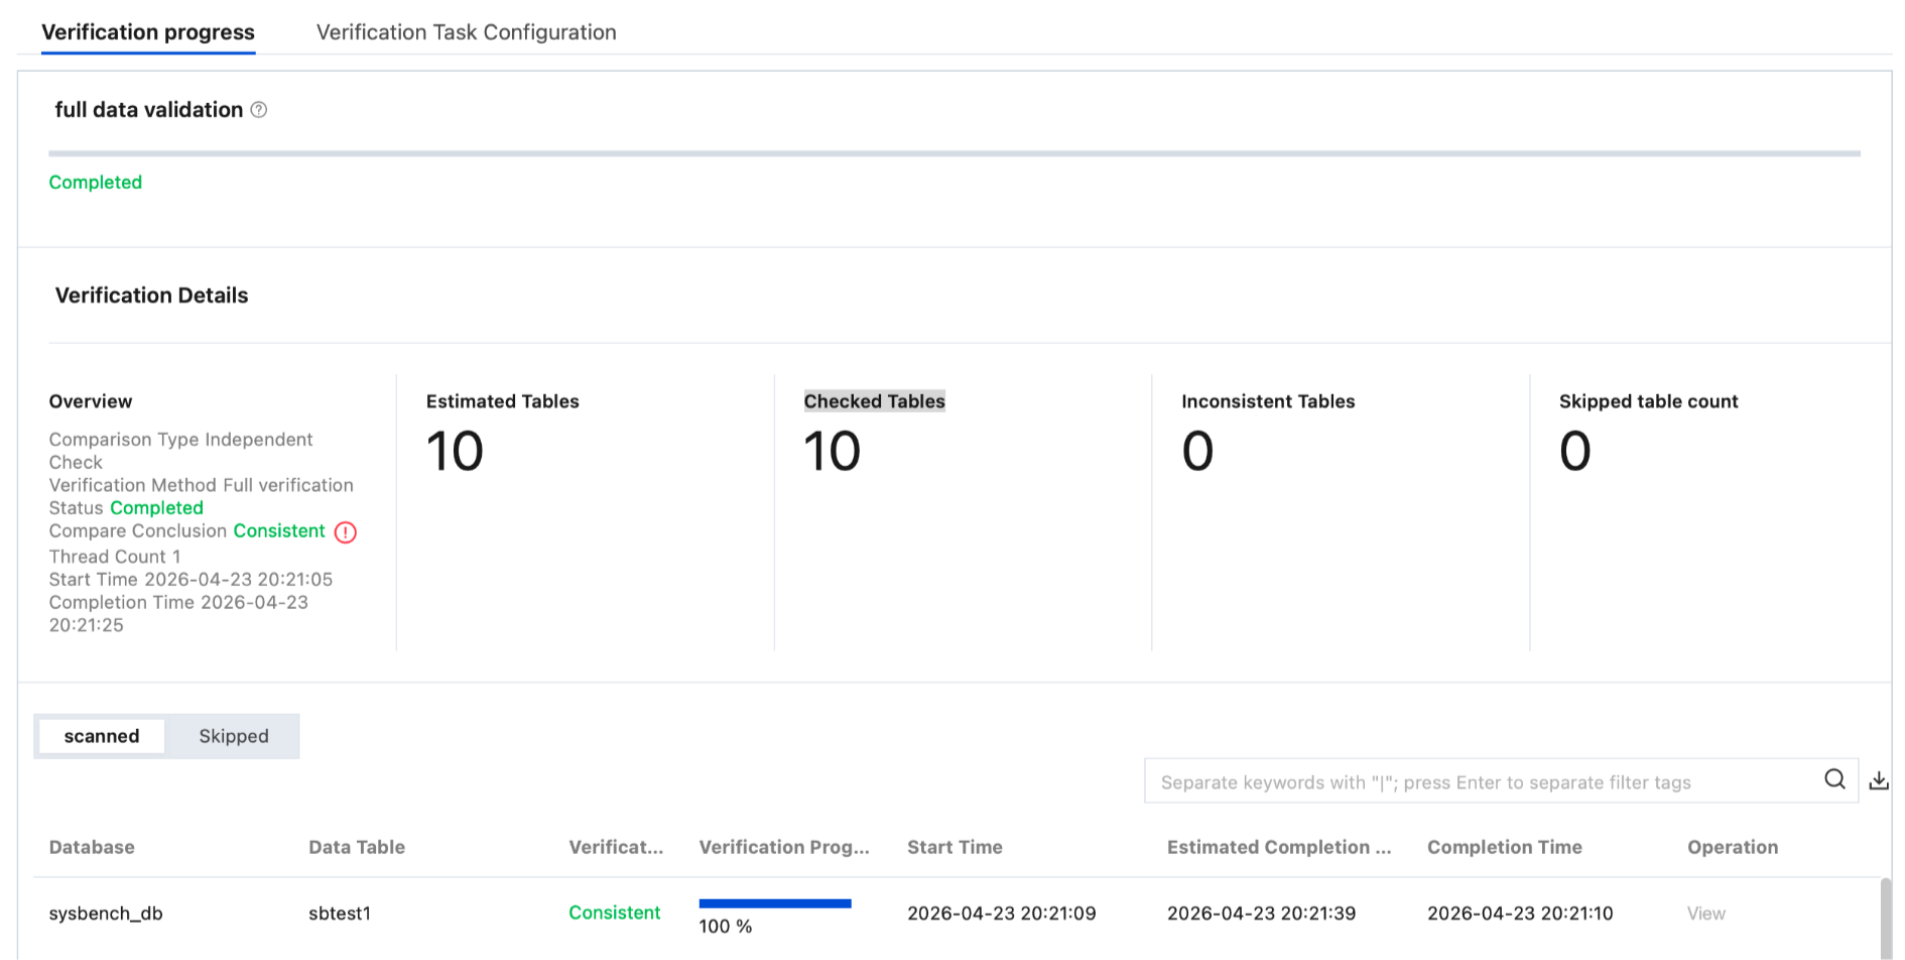
全量検証:推定テーブル総数、検証済みテーブル数、不一致テーブル数、スキップ済みテーブル数を確認します。
推定テーブル総数:検証予定のテーブル総数の推定値であり、最終的な実際の検証テーブル総数とは若干の差異が生じます。これは、検証予定のテーブル総数を正確に提供すると、全体の検証パフォーマンスに影響を与えるためです。
未チェック表の原因:PKまたは非NULL一意キーがない、空テーブル、サポートされていないエンジンタイプ、テーブルが存在しない。
GTID検証
ソース側とターゲット側の差分、ソース側とターゲット側の不一致データベース・テーブル、ターゲット側とソース側の差分を確認します。
4. 不一致の詳細を確認します。
組み込み検証シナリオでは、不一致の結果について、ユーザーがソースデータベースとターゲットデータベースの対応する内容を手動で比較する必要があります。
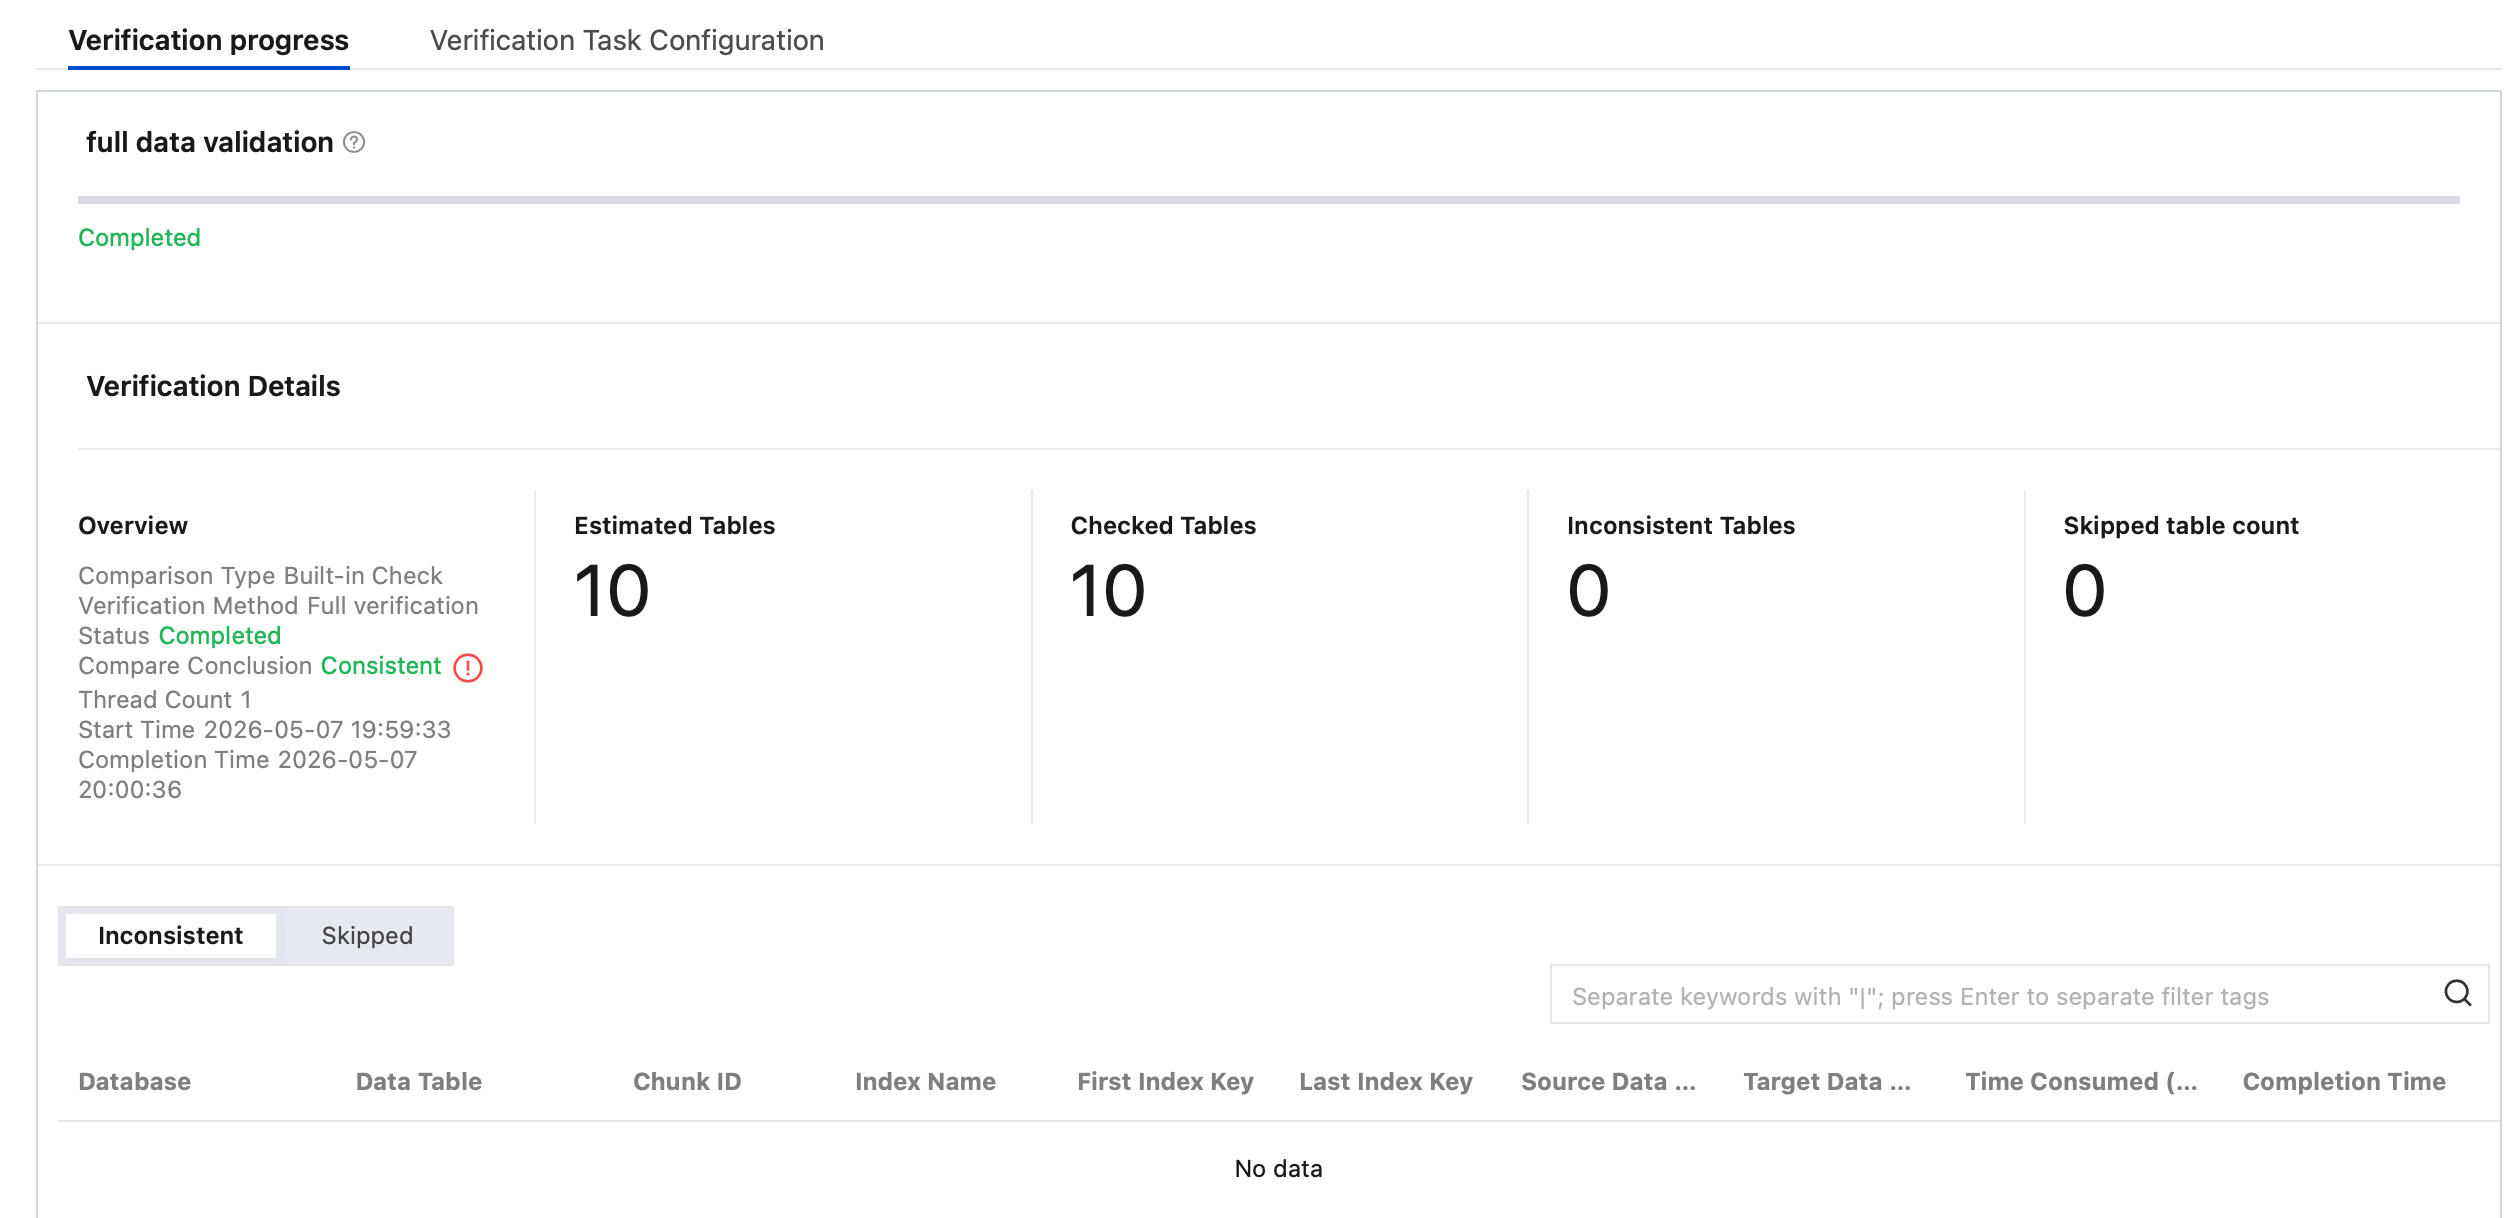
画面に表示されるデータベース、データテーブル、インデックス名、インデックス上限、インデックス下限のパラメータに従って、具体的な位置を特定して比較してください。
参考操作は以下の通りです:
1. ソースデータベースにログインし、提示されたインデックス範囲をクエリします。select * from table_name where col_index >=1 and col_index <=5;2. ターゲットデータベースにログインし、提示されたインデックス範囲をクエリします。3. ターゲットとソースのデータ差異を比較します。
独立検証シナリオ
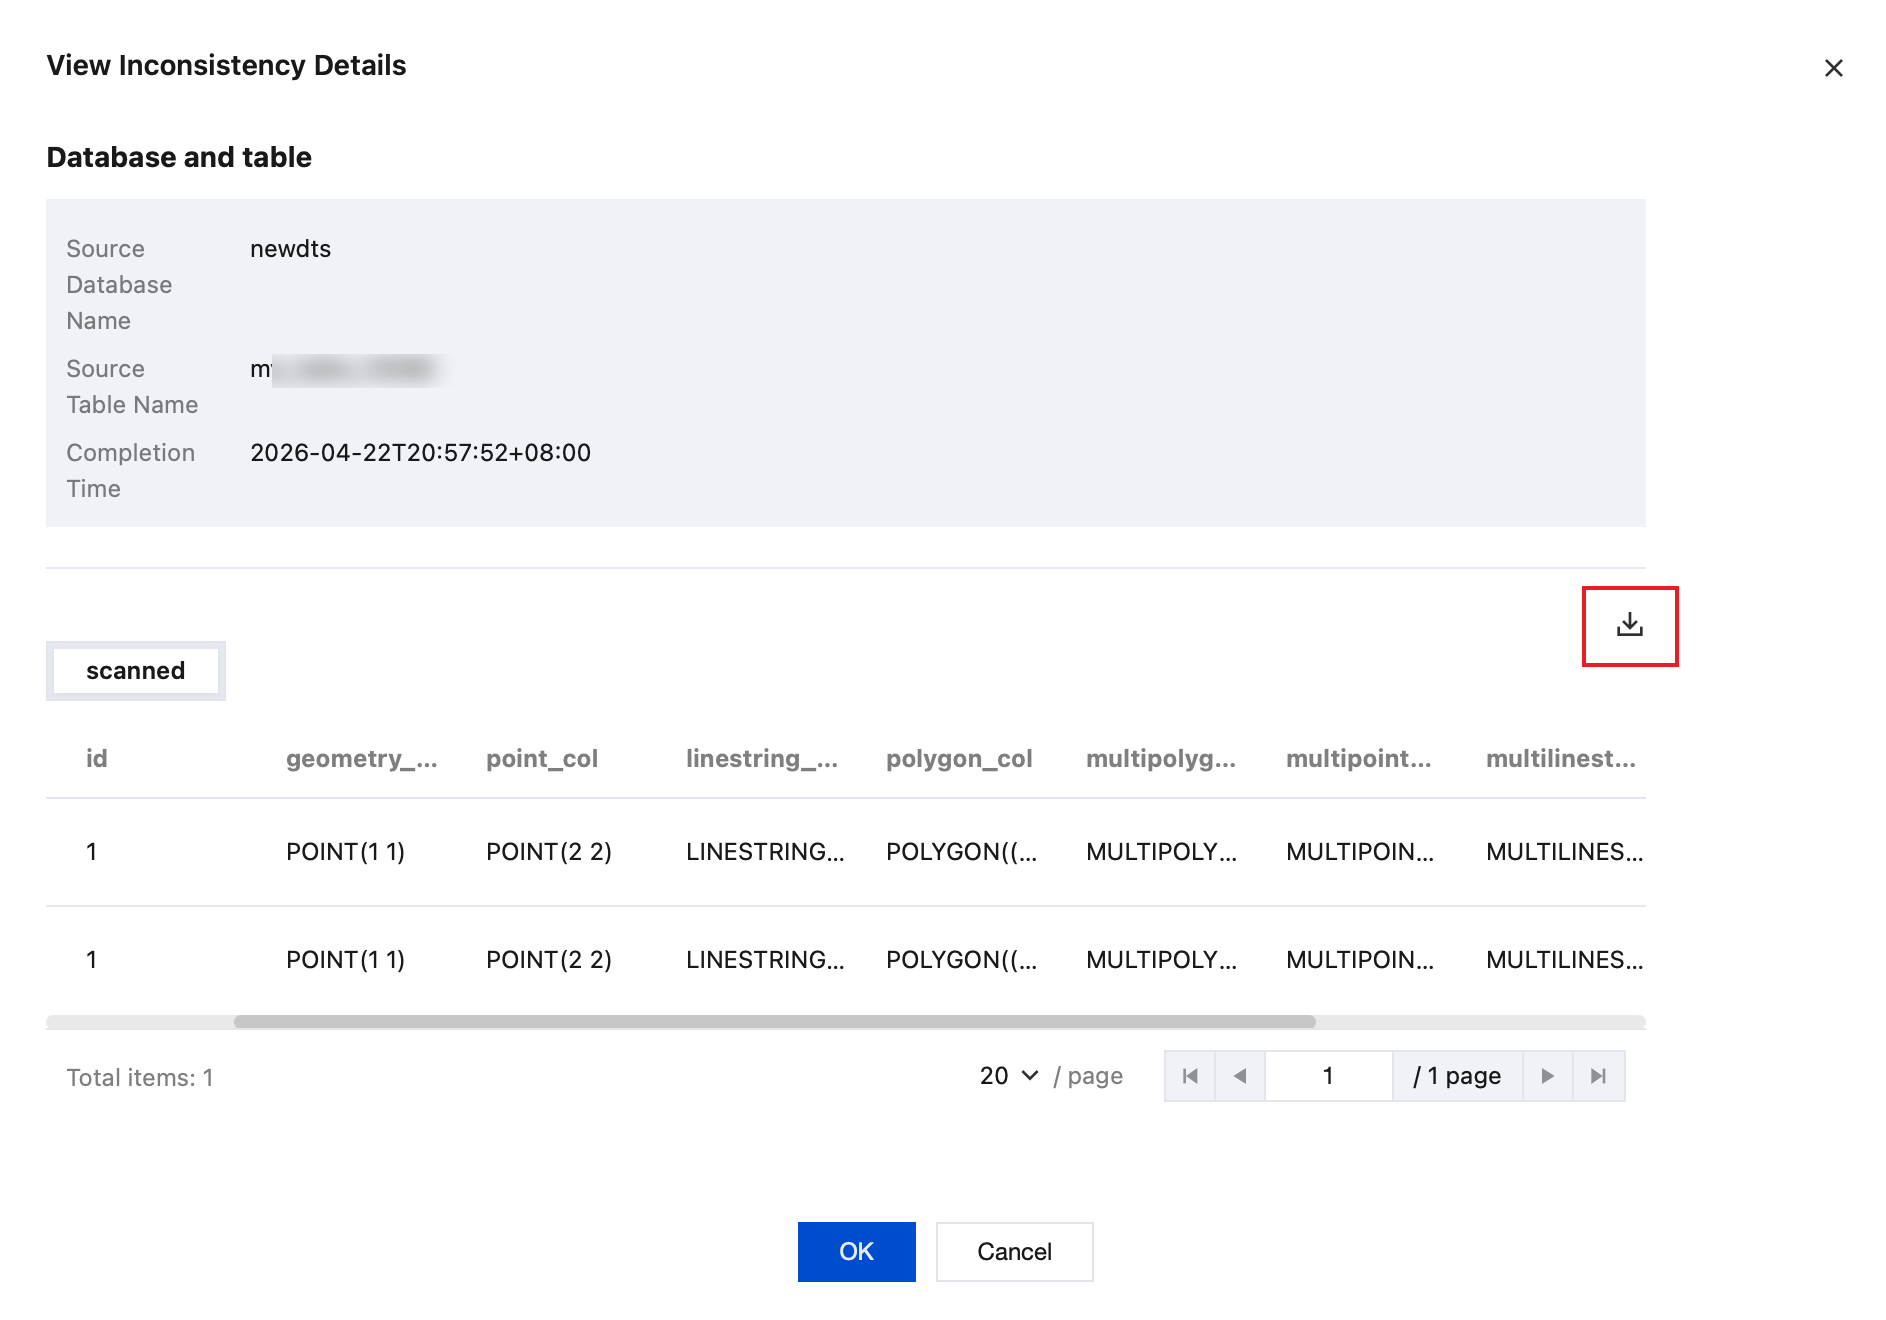
4.1.1 検出済みエリアで対応するテーブルの後ろにある表示をクリックすると、不一致のデータ詳細を確認できます。
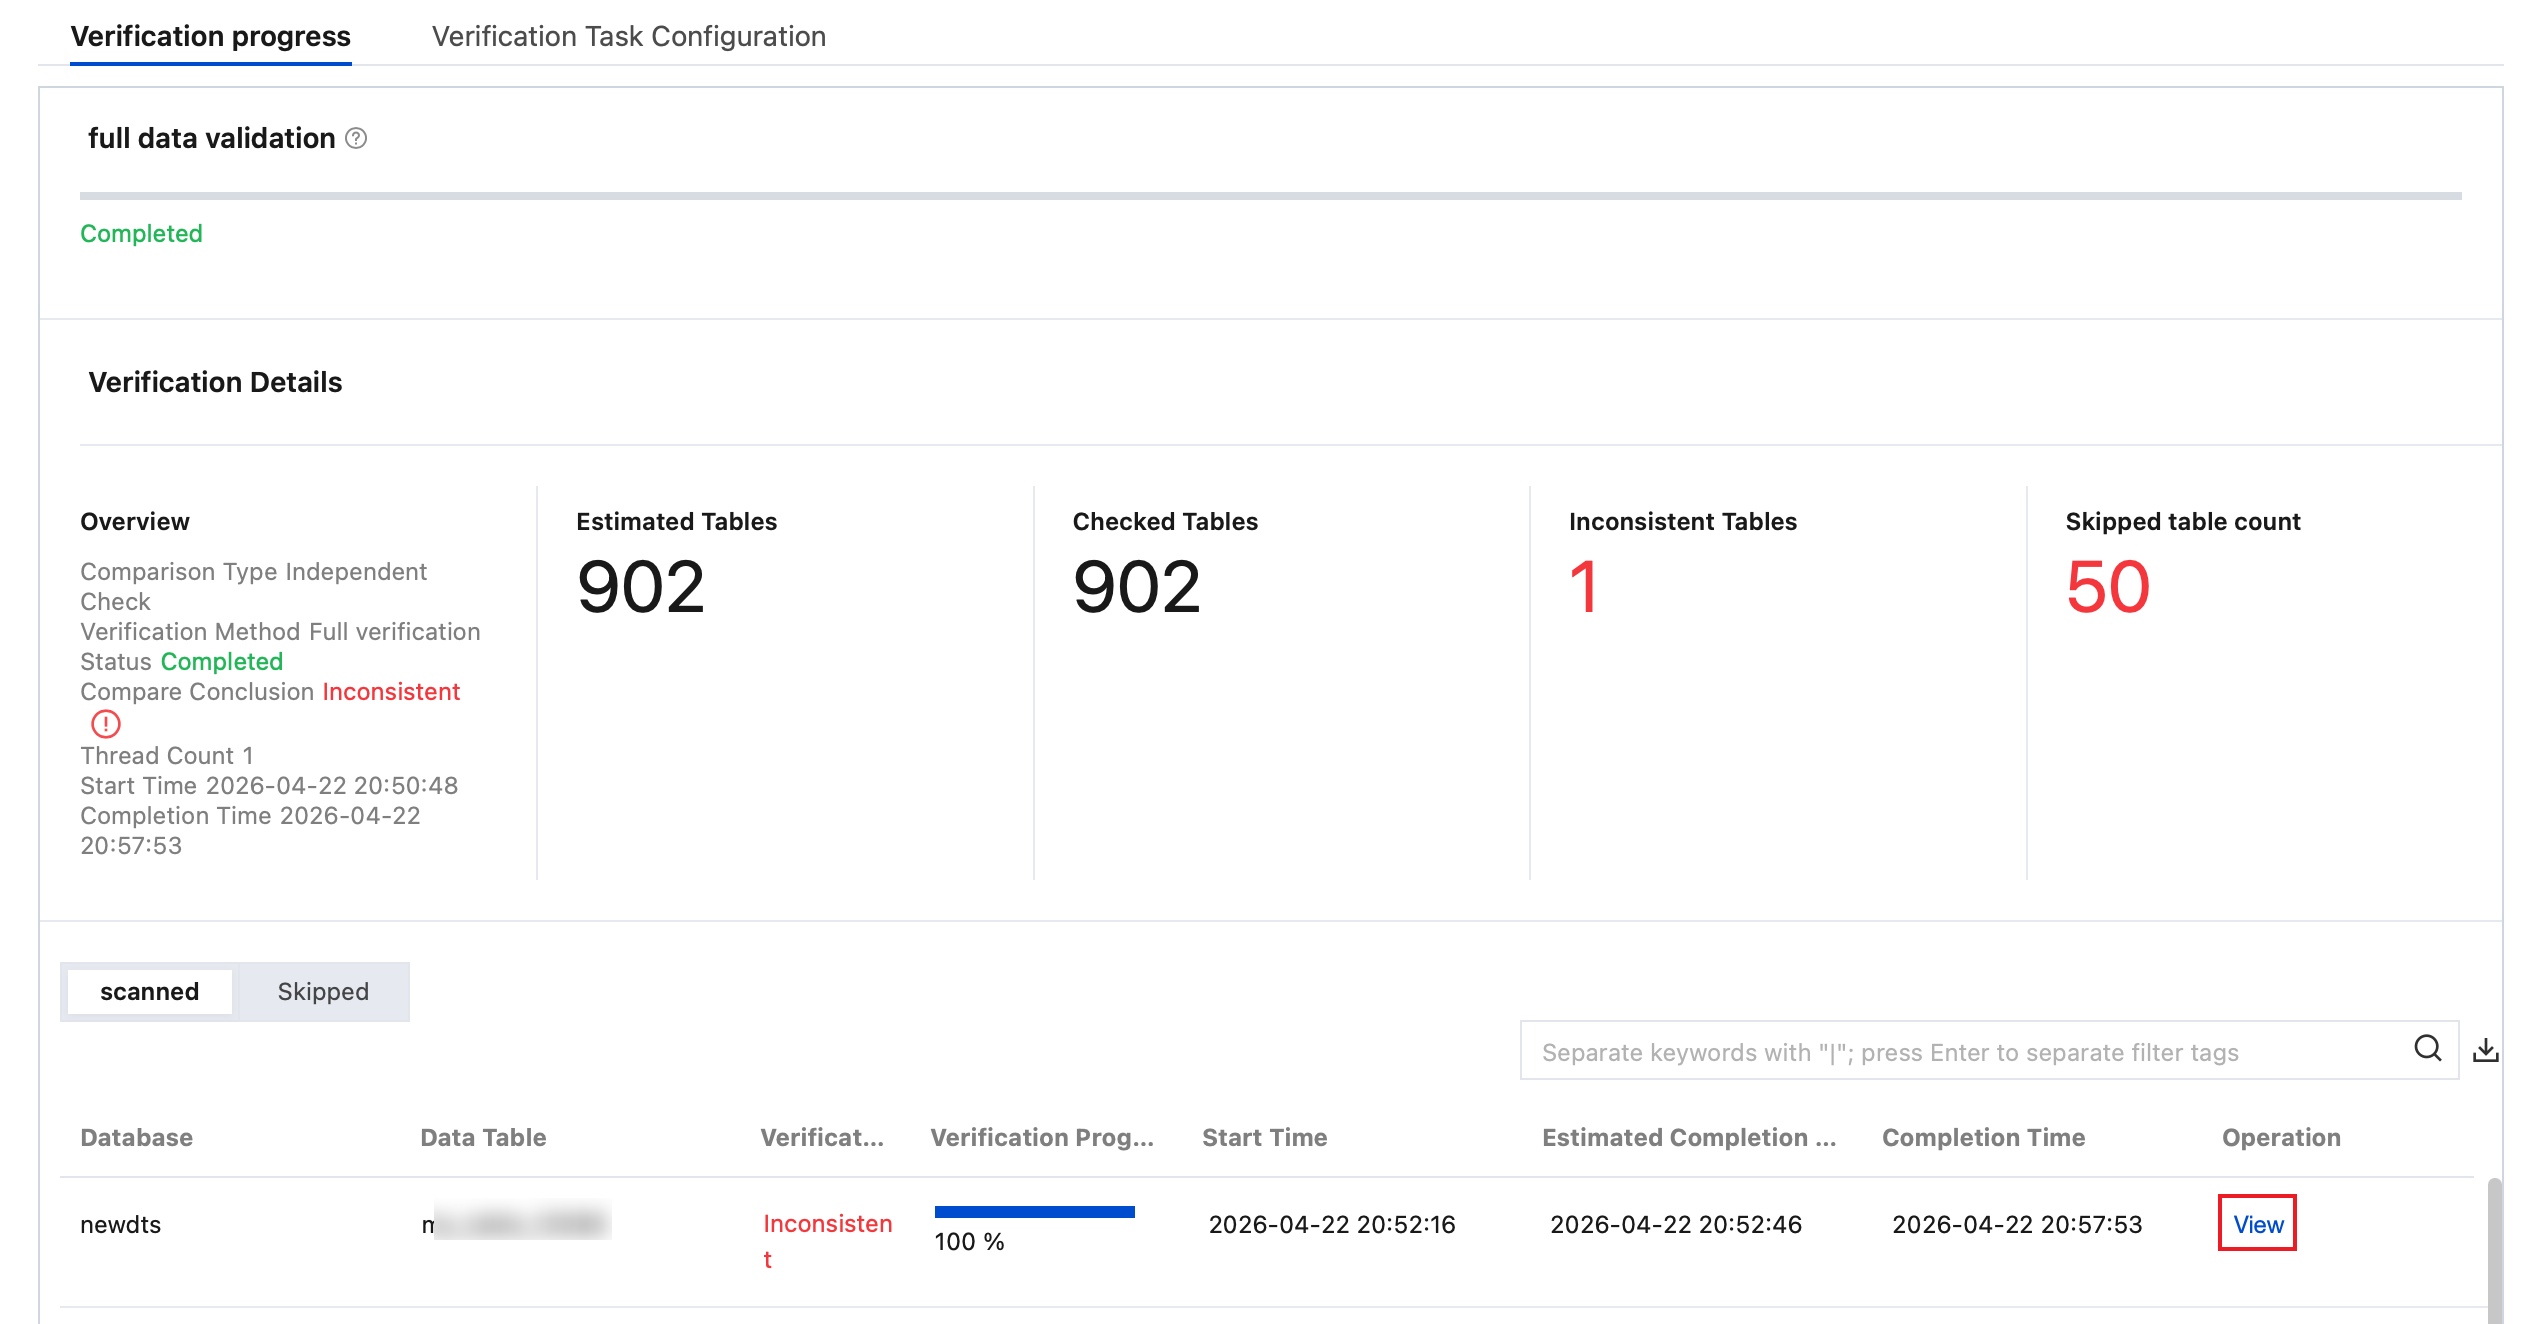
4.1.2 表示されたダイアログボックスで不一致の詳細を確認します。
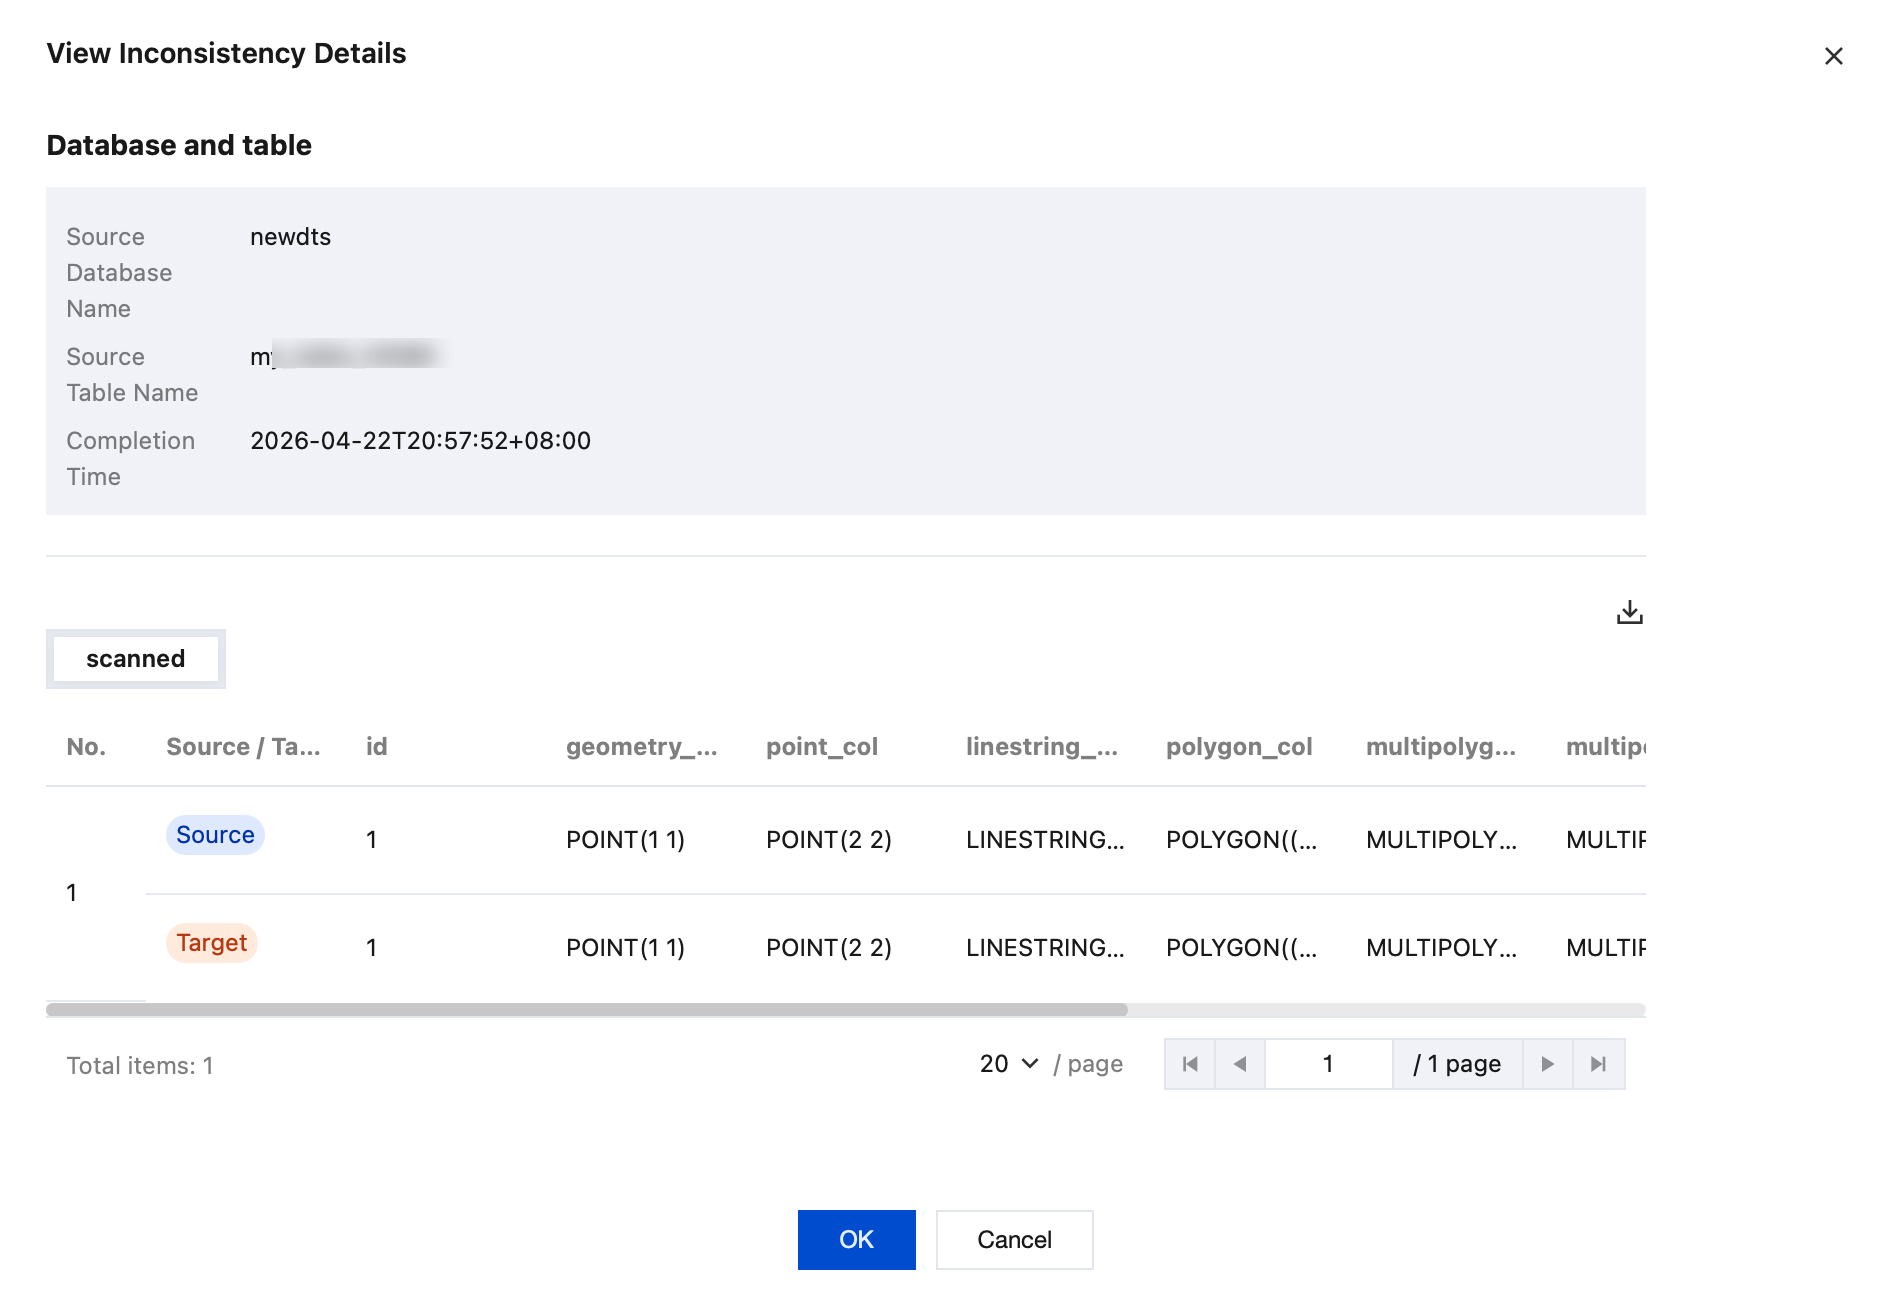
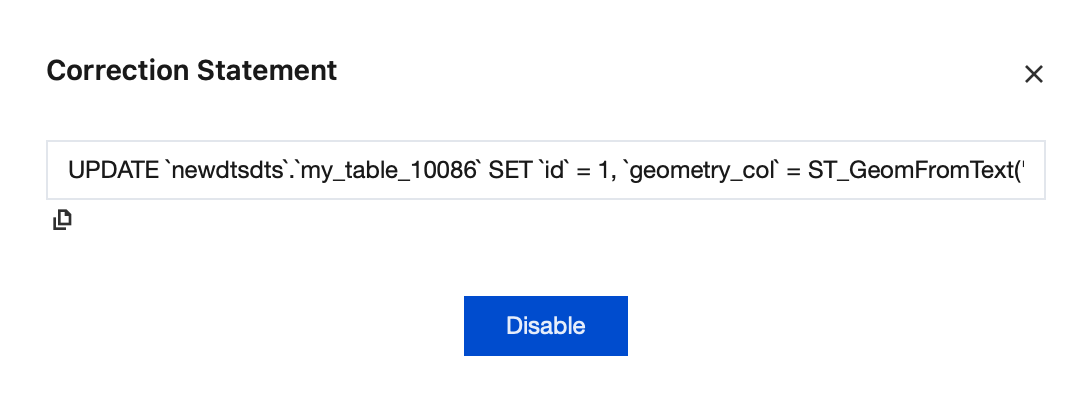
4.1.3 操作列で訂正文をクリックします。
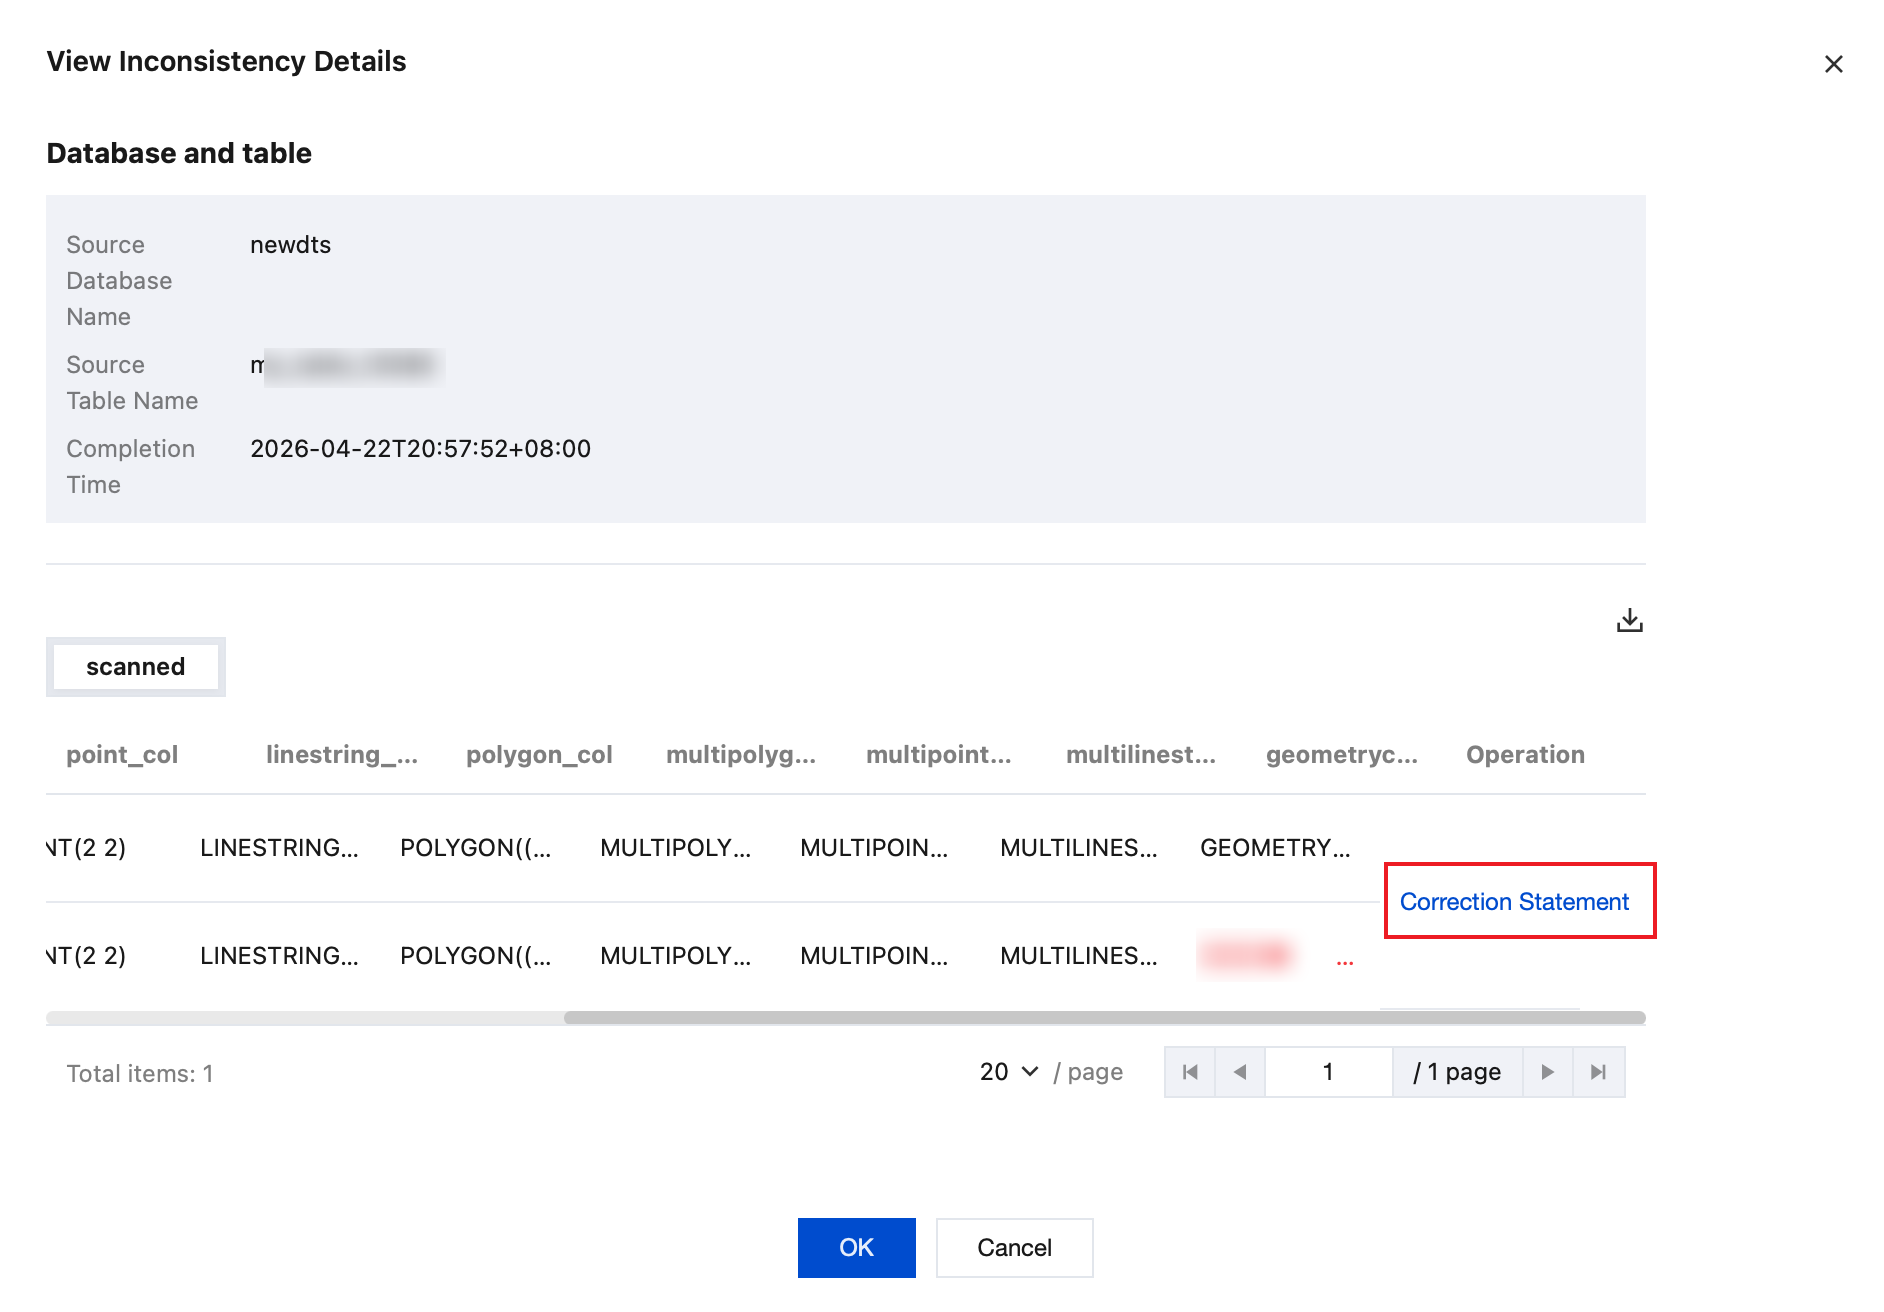
訂正文を表示します。
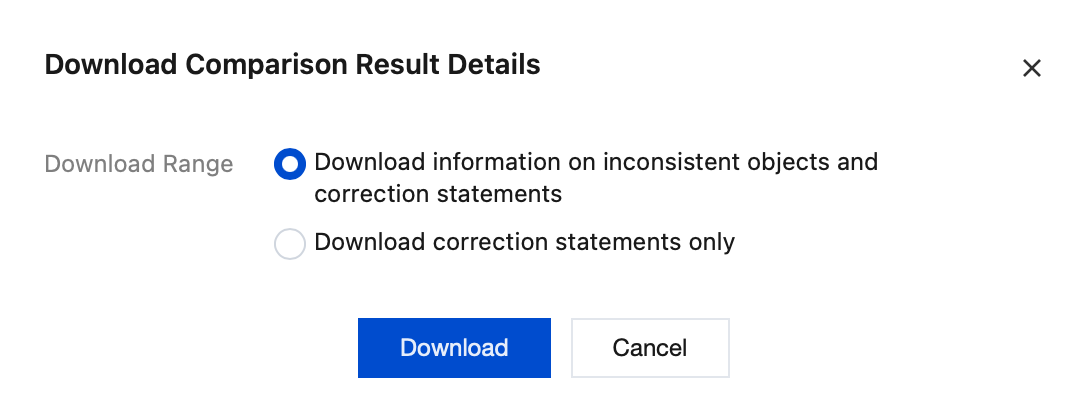
4.1.4 ダイアログボックスの右側で
不一致情報と訂正文をダウンロードするか、または訂正文のみをダウンロードできます。
GTID検証シナリオ
不一致の詳細エリアで不一致のデータ詳細を確認できます。
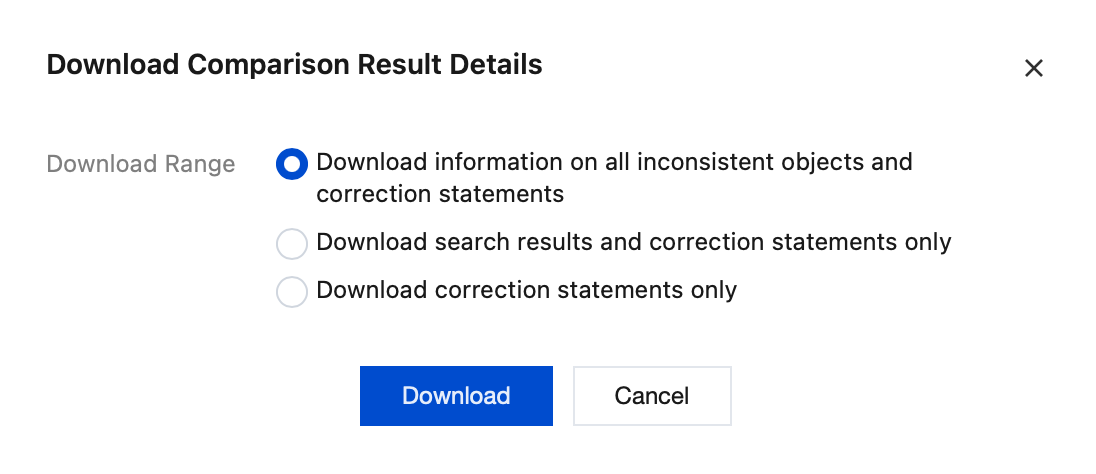
5. 比較結果の詳細をダウンロードします。
5.1 検証進捗ページで、右側の
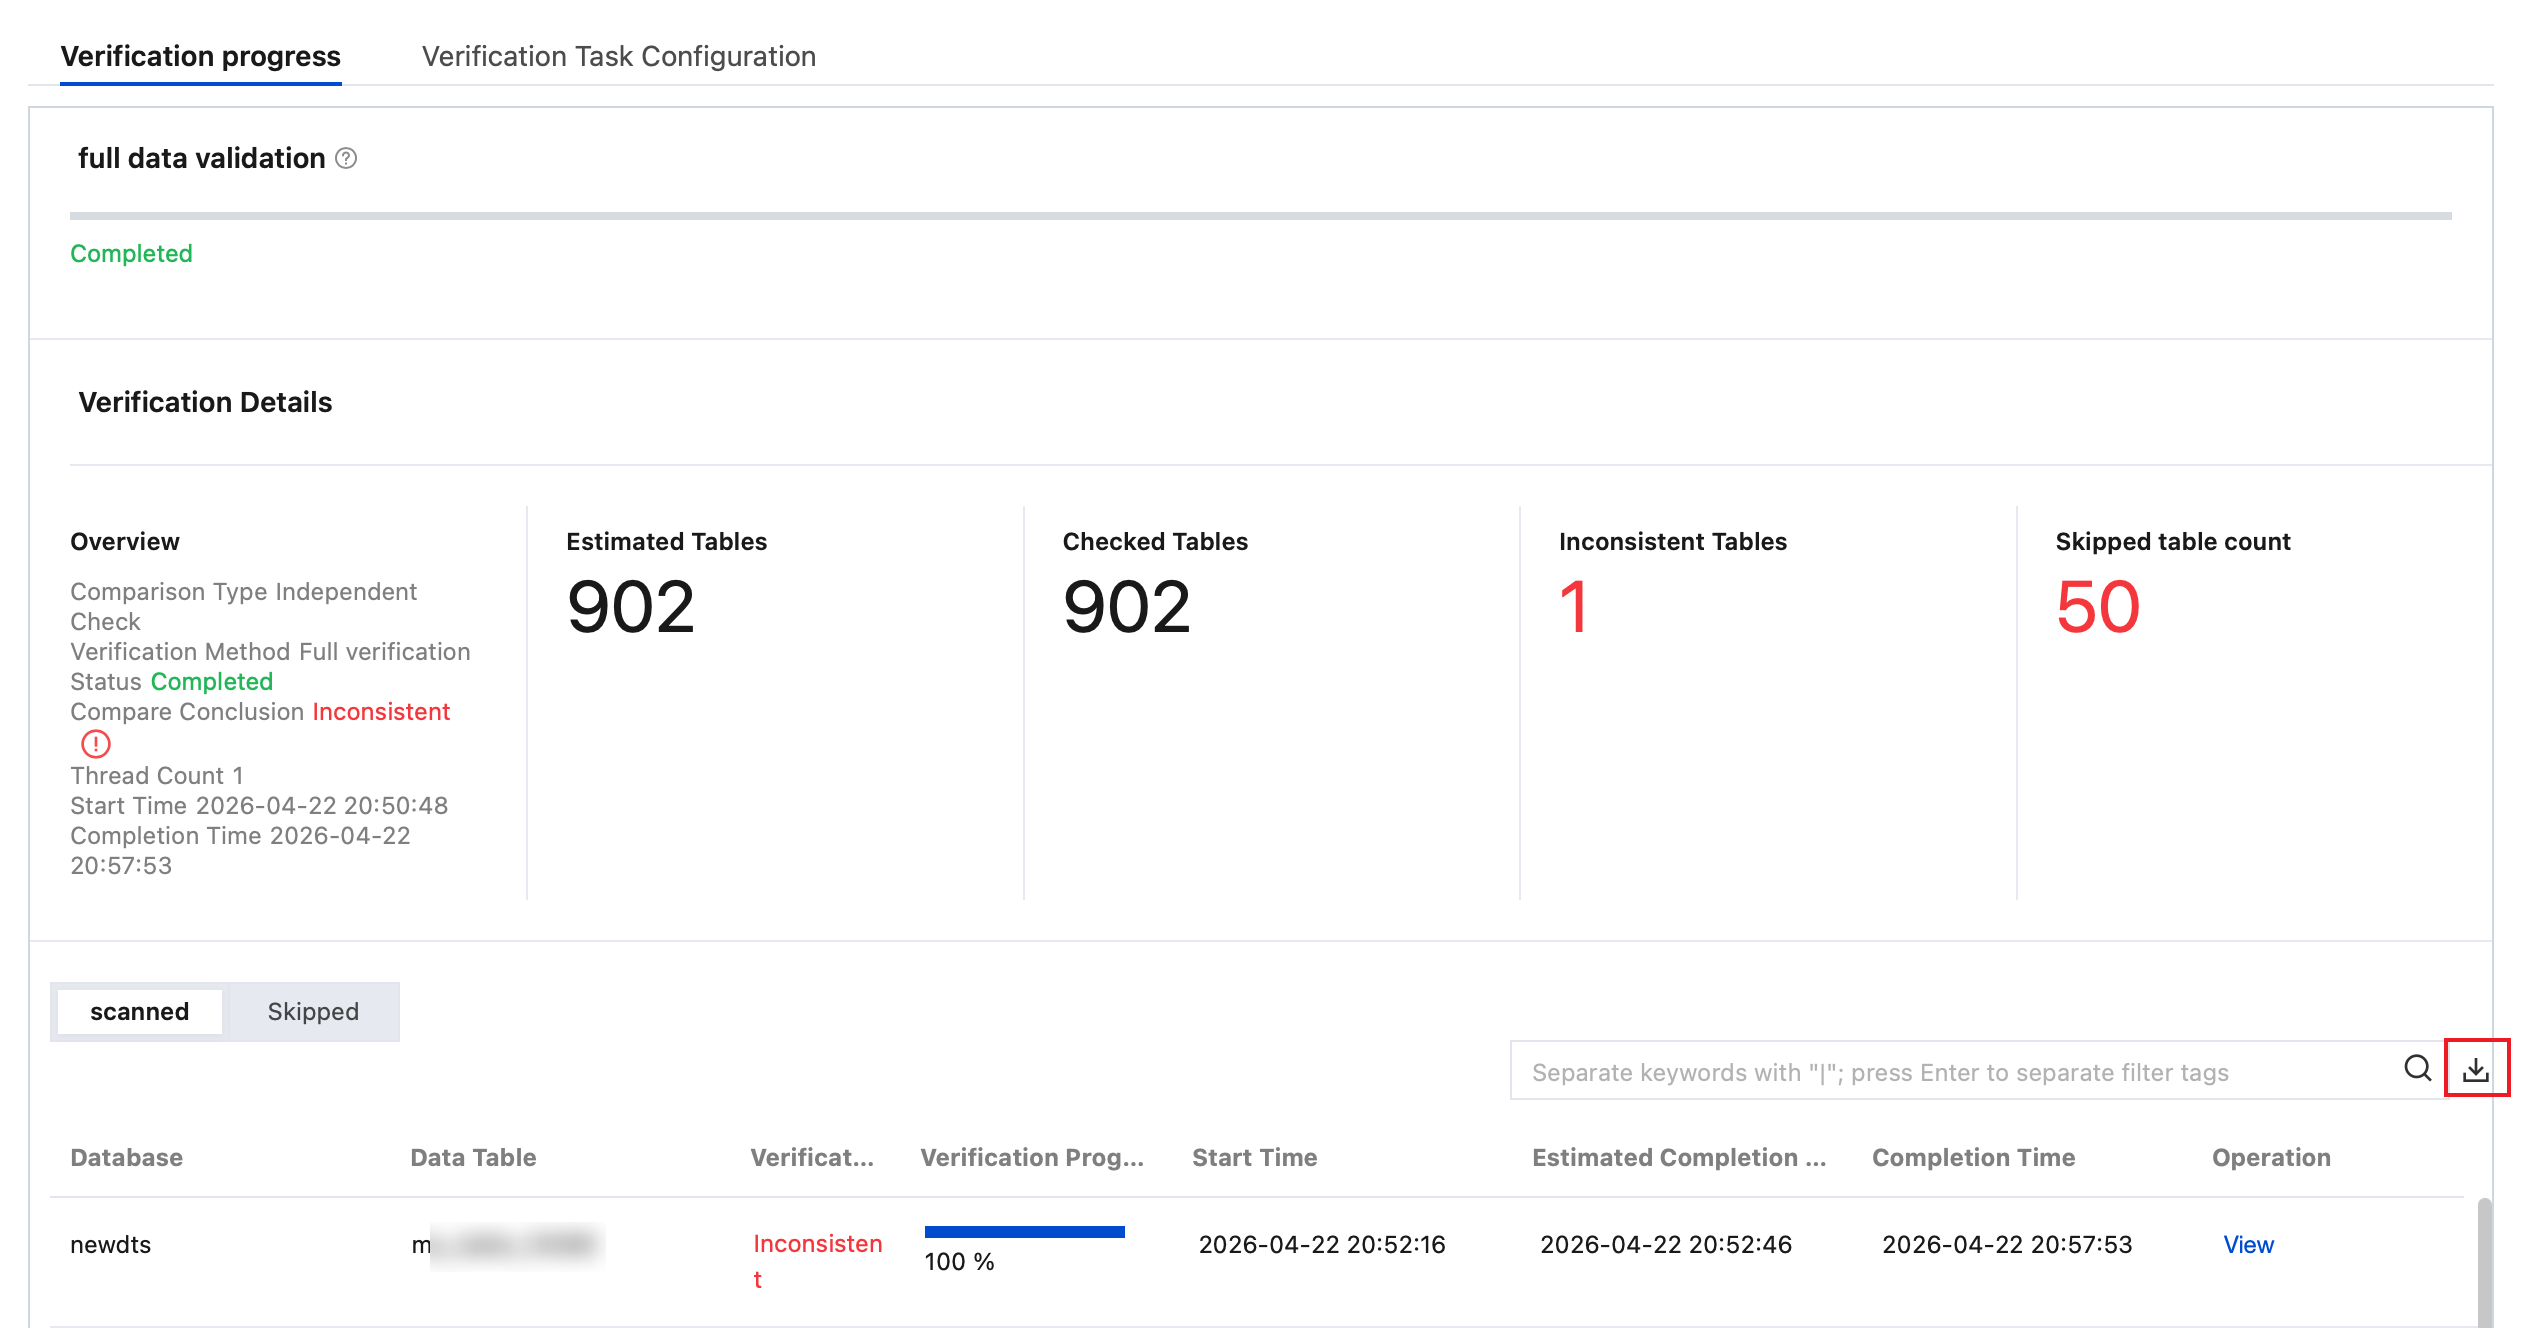
5.2 表示されたダイアログボックスで、ダウンロードをクリックします。
Help and Support
Was this page helpful?
You can also Contact sales or Submit a Ticket for help.
Help us improve! Rate your documentation experience in 5 mins.
Feedback