Elasticsearch/Tencent Elasticsearch データソース
Download
Focus Mode
Font Size
Tencent Cloud ElasticsearchデータソースとElasticsearchデータソースの設定方法は同じです。ここではElasticsearchデータソースを例として説明します。
サポートバージョン
ElasticSearch 6.x、7.xバージョンをサポートします。
利用制限
1. Elasticsearch Readerはデータ同期のためにServer側のshard情報を取得します。タスク同期中にServer側のshardsが生存状態であることを確認する必要があります。そうでない場合、データ不整合のリスクがあります。
2. scaled_float型のフィールドの同期はサポートされません。
3. 同期フィールドにキーワード$refを含むインデックスの同期はサポートされません。
Elasticsearch オフライン単一テーブル読み取りノードの設定
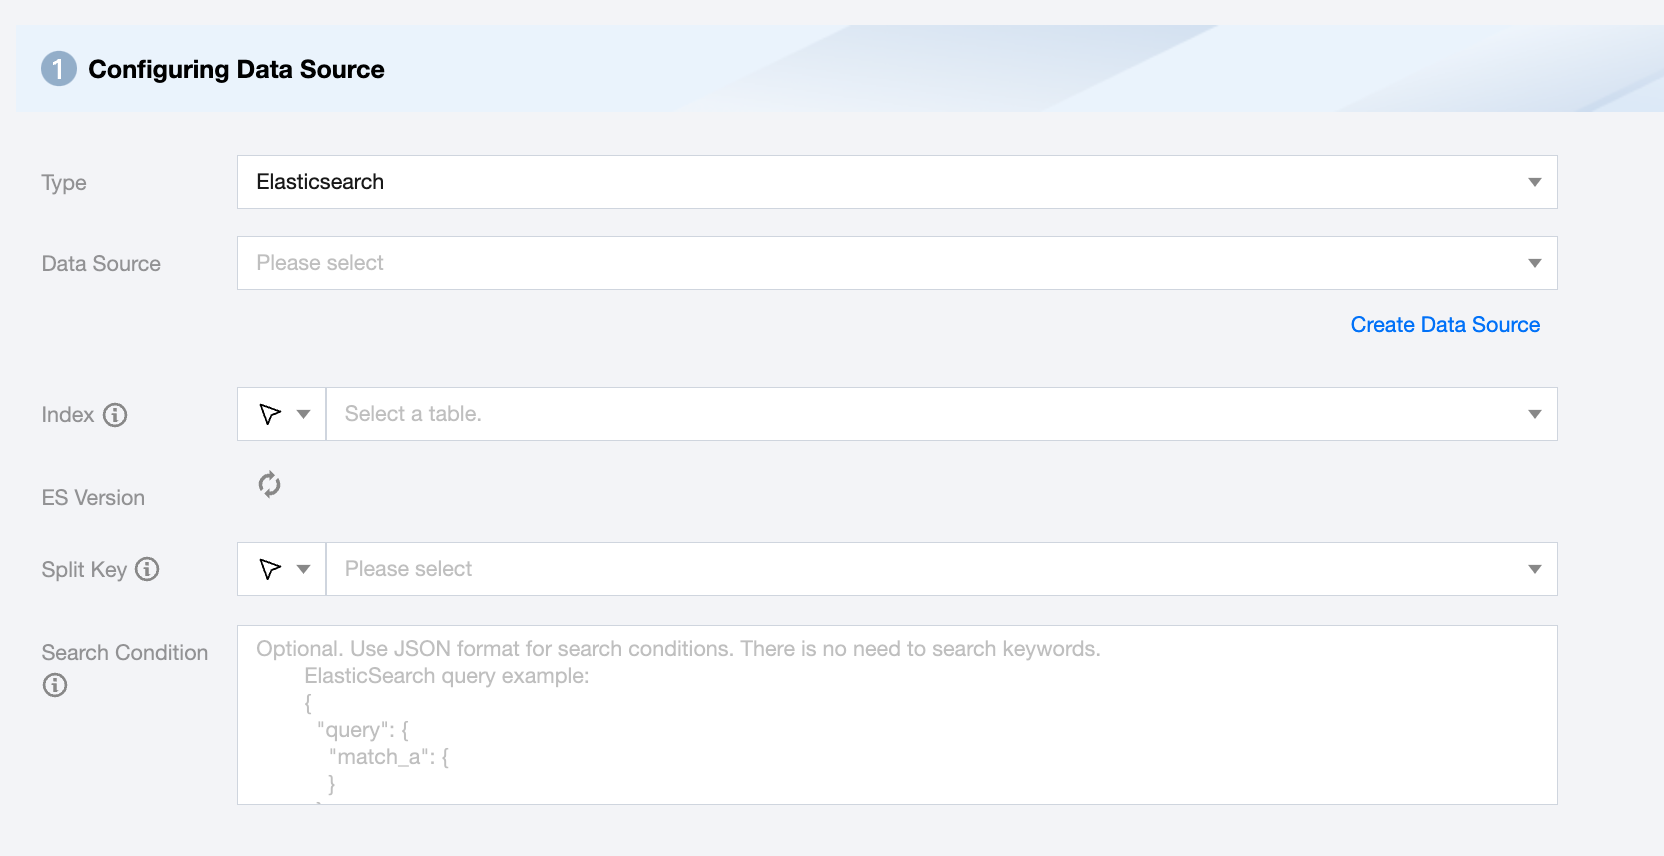
パラメータ | 説明 |
データソース | 現在のプロジェクトで利用可能なElasticsearchデータソースを選択します。 |
インデックス | 複数のインデックス名または正規表現をサポートします。インデックス名の正規表現にはワイルドカード(*)を使用してください。例えばindex_*です。 |
ESバージョン | データソースとインデックスに基づいてESバージョンを決定します。 |
分割キー | データシャーディングに使用するフィールドを指定します。指定後、並行タスクが起動されデータ同期が行われます。ソースデータテーブルのいずれかの列をシャーディングキーとして指定できます。主キーまたはインデックス付きの列をシャーディングキーとして使用することをお勧めします。 |
検索条件(任意) | JSON形式で検索を行います。 |
Elasticsearch オフライン単一テーブル書き込みノードの設定
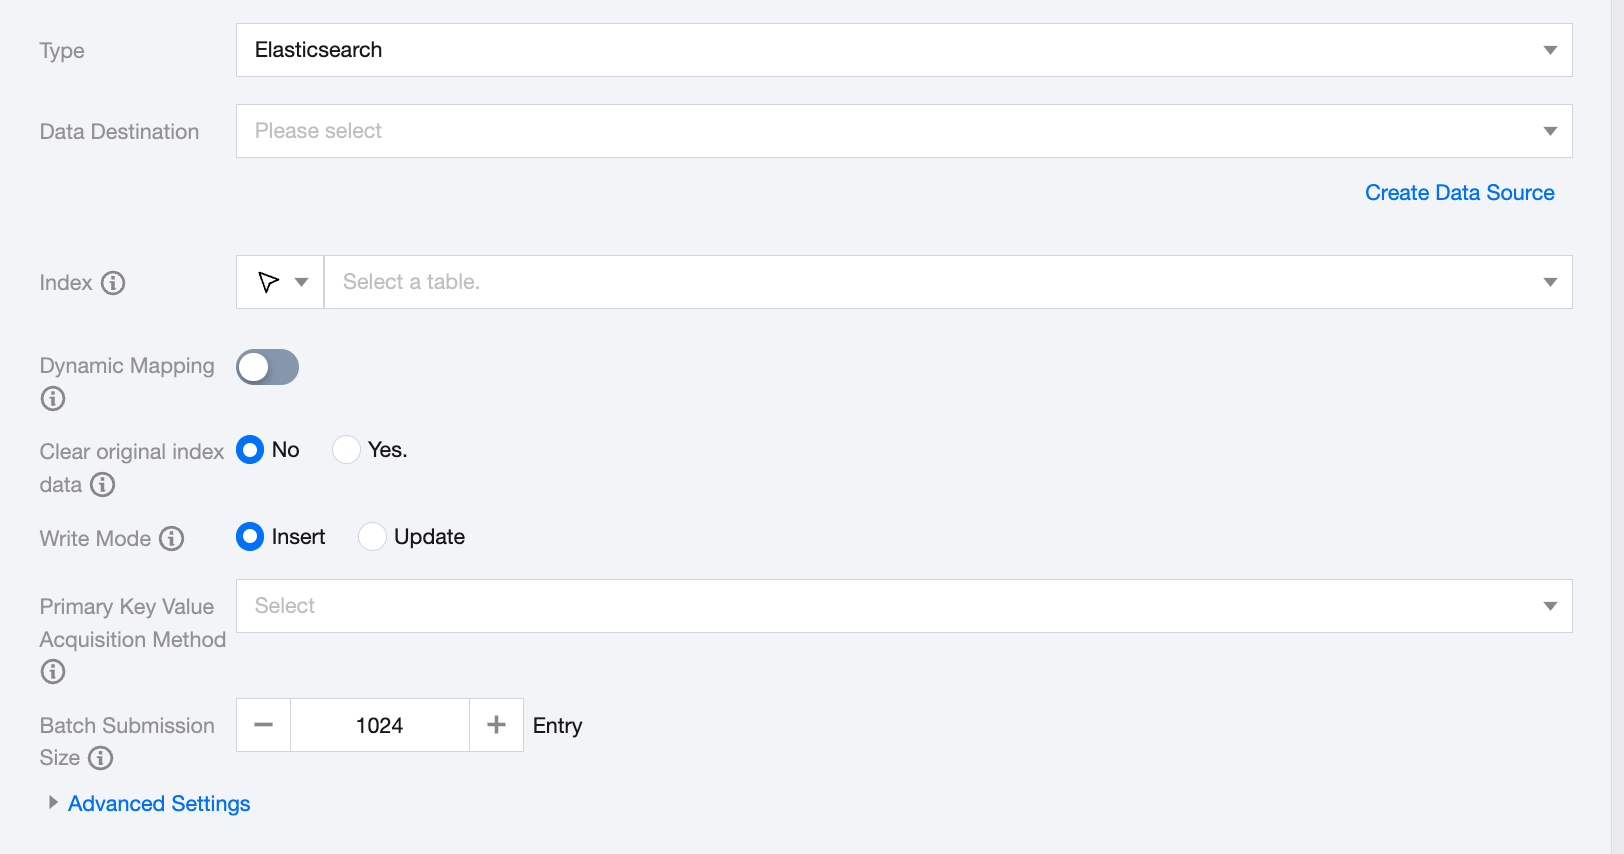
パラメータ | 説明 |
データの転送先 | 現在のプロジェクトで利用可能なElasticsearchデータソースを選択します。 |
インデックス | ElasticSearch内のインデックス名。 |
動的マッピング | ドキュメント内に存在しないフィールドが検出された場合に、同期タスクがElasticsearchの動的マッピングメカニズムを通じてフィールドにマッピングを追加するかどうかを定義します。 開く:Elasticsearchの自動mappingsマッピングを保持します。 閉じる:デフォルトでは無効です。同期タスクで設定されたcolumnに基づいて、Elasticsearchのmappingsマッピングを生成して更新します。 Elasticsearch 7.xバージョンのデフォルトtypeは_docです。Elasticsearchの自動mappingsを使用する場合は、_docとesVersionを7に設定してください。 |
元のインデックスデータのクリア | 元のインデックスデータをクリアするかどうかを手動で選択します。 いいえ:データをインポートする前に、インデックスに既に存在するデータを保持します。 はい:データをインポートする前に元のインデックスを削除し、同じ名前のインデックスを再作成します。この操作により、そのインデックス内のデータが削除されます。 |
書き込み方式 | 挿入と更新の2種類の書き込み方式をサポートします。 挿入:すべてのデータを直接挿入します。 更新:同じ主キーが存在する場合はデータを更新し、それ以外の場合は挿入します。 |
主キー取得方法 | 3種類の取得方法をサポートします。 ソーステーブル主キー:documentのidにはソーステーブルの主キーを使用します。 複合主キー:documentのidは、ソーステーブルの複数の列によって共同で決定されます。 主キーなし:デフォルトで_id値が生成されます。 |
バッチコミットサイズ | 一度にバッチ送信されるレコード数です。この値により、データ同期システムとElasticSearch間のネットワーク通信回数を大幅に削減し、全体のスループットを向上させることができます。この値が大きすぎる場合、データ同期プロセスでOOM例外が発生する可能性があります。 |
詳細設定(任意) | 業務ニーズに応じてパラメータを設定できます。 |
データ型変換のサポート
読み取り
ElasticSearchデータ型 | 内部型 |
byte、short、integer、long、unsigned long | Long |
float、double、half_float | Double |
string、text、keyword、integer_range、long_range、float_range、double_range、date_range、array、object、nested、flattened、geo_point、geo_shape | String |
date | Date |
binary | Bytes |
boolean | Boolean |
書き込み
内部型 | ElasticSearchデータ型 |
Long | byte、short、integer、long |
Double | float、double |
String | string、text、keyword、object、nested、geo_point、geo_shape、ip、binary、completion |
Date | date |
Boolean | boolean |
よくあるご質問
ES writerがインデックスを削除した後、自動的に再構築されたインデックスのフィールド型が想定と異なる
問題情報:
ES書き込みノードで「元のインデックスデータを削除」を設定し、「はい」を選択してタスクを再実行する場合、es writerはインデックスを自動作成しません。データを直接書き込む場合、ESはデータに基づいて推測し、インデックスを自動作成します。新しいインデックスのフィールドタイプは旧バージョンと異なる可能性があります。
問題原因:
ES writerが元のインデックスデータを削除する方法は、インデックスを直接deleteすることであり、MySQLのtruncate tableのような構文はありません。インデックス削除後、ES Serverがデータに基づいて推測するインデックスのフィールドタイプは、元のインデックスのフィールドタイプと異なる可能性があります。
ソリューション:
ES templateを使用して、インデックスのフィールドタイプを事前に定義します。
作成例:(merlion_suggest_words_*は、merlion_suggest_words_で始まるすべてのインデックスに有効です)。
PUT _template/merlion_suggest_words{"template": "merlion_suggest_words_*","order": 1,"mappings": {"properties": {"biz_owner": {"type": "keyword"},"create_time": {"type": "date","format": "yyyy-MM-dd HH:mm:ss||date_hour_minute_second||strict_date_optional_time||epoch_millis"},"is_deleted": {"type": "short"},"sug_words": {"type": "keyword"},"language": {"type": "keyword"}}},"settings": {"refresh_interval": "5s","number_of_replicas": 1,"number_of_shards": 1}}
Help and Support
Was this page helpful?
You can also Contact sales or Submit a Ticket for help.
Help us improve! Rate your documentation experience in 5 mins.
Feedback